
2026-11-09 00:55:40
之前的时候就听说湖南移动有个爱家共享的活动,组成之后可以额外获得共享流量和通话,但由于那会刚参加全民百G活动,通话还比较够用,也没有组的欲望,直到最近通话开始不太够用,就想看看有没有什么语音包值得开的,这就让移动爱家再次进入到了视线中。一直到最近几天,听说爱家计划要进行升级,加上发现很多想参加这个活动的人并不是特别了解这个活动,就想着写篇文章详细介绍一下这个活动,以备日后查阅。
简单来说就是一个号码作为发起人,然后邀请其他号码加入,根据发起号码和加入号码的认定消费之和产生一个保底消费档位,根据这个档位获得对应的流量和通话(爱家共享计划。若超过80元档,将额外赠送第二条宽带),并且还可以根据发起号码和加入号码的网龄之和获得对应的流量或通话(爱家网龄计划),以及发起号码和加入号码之间互打电话免费(亲情网)。
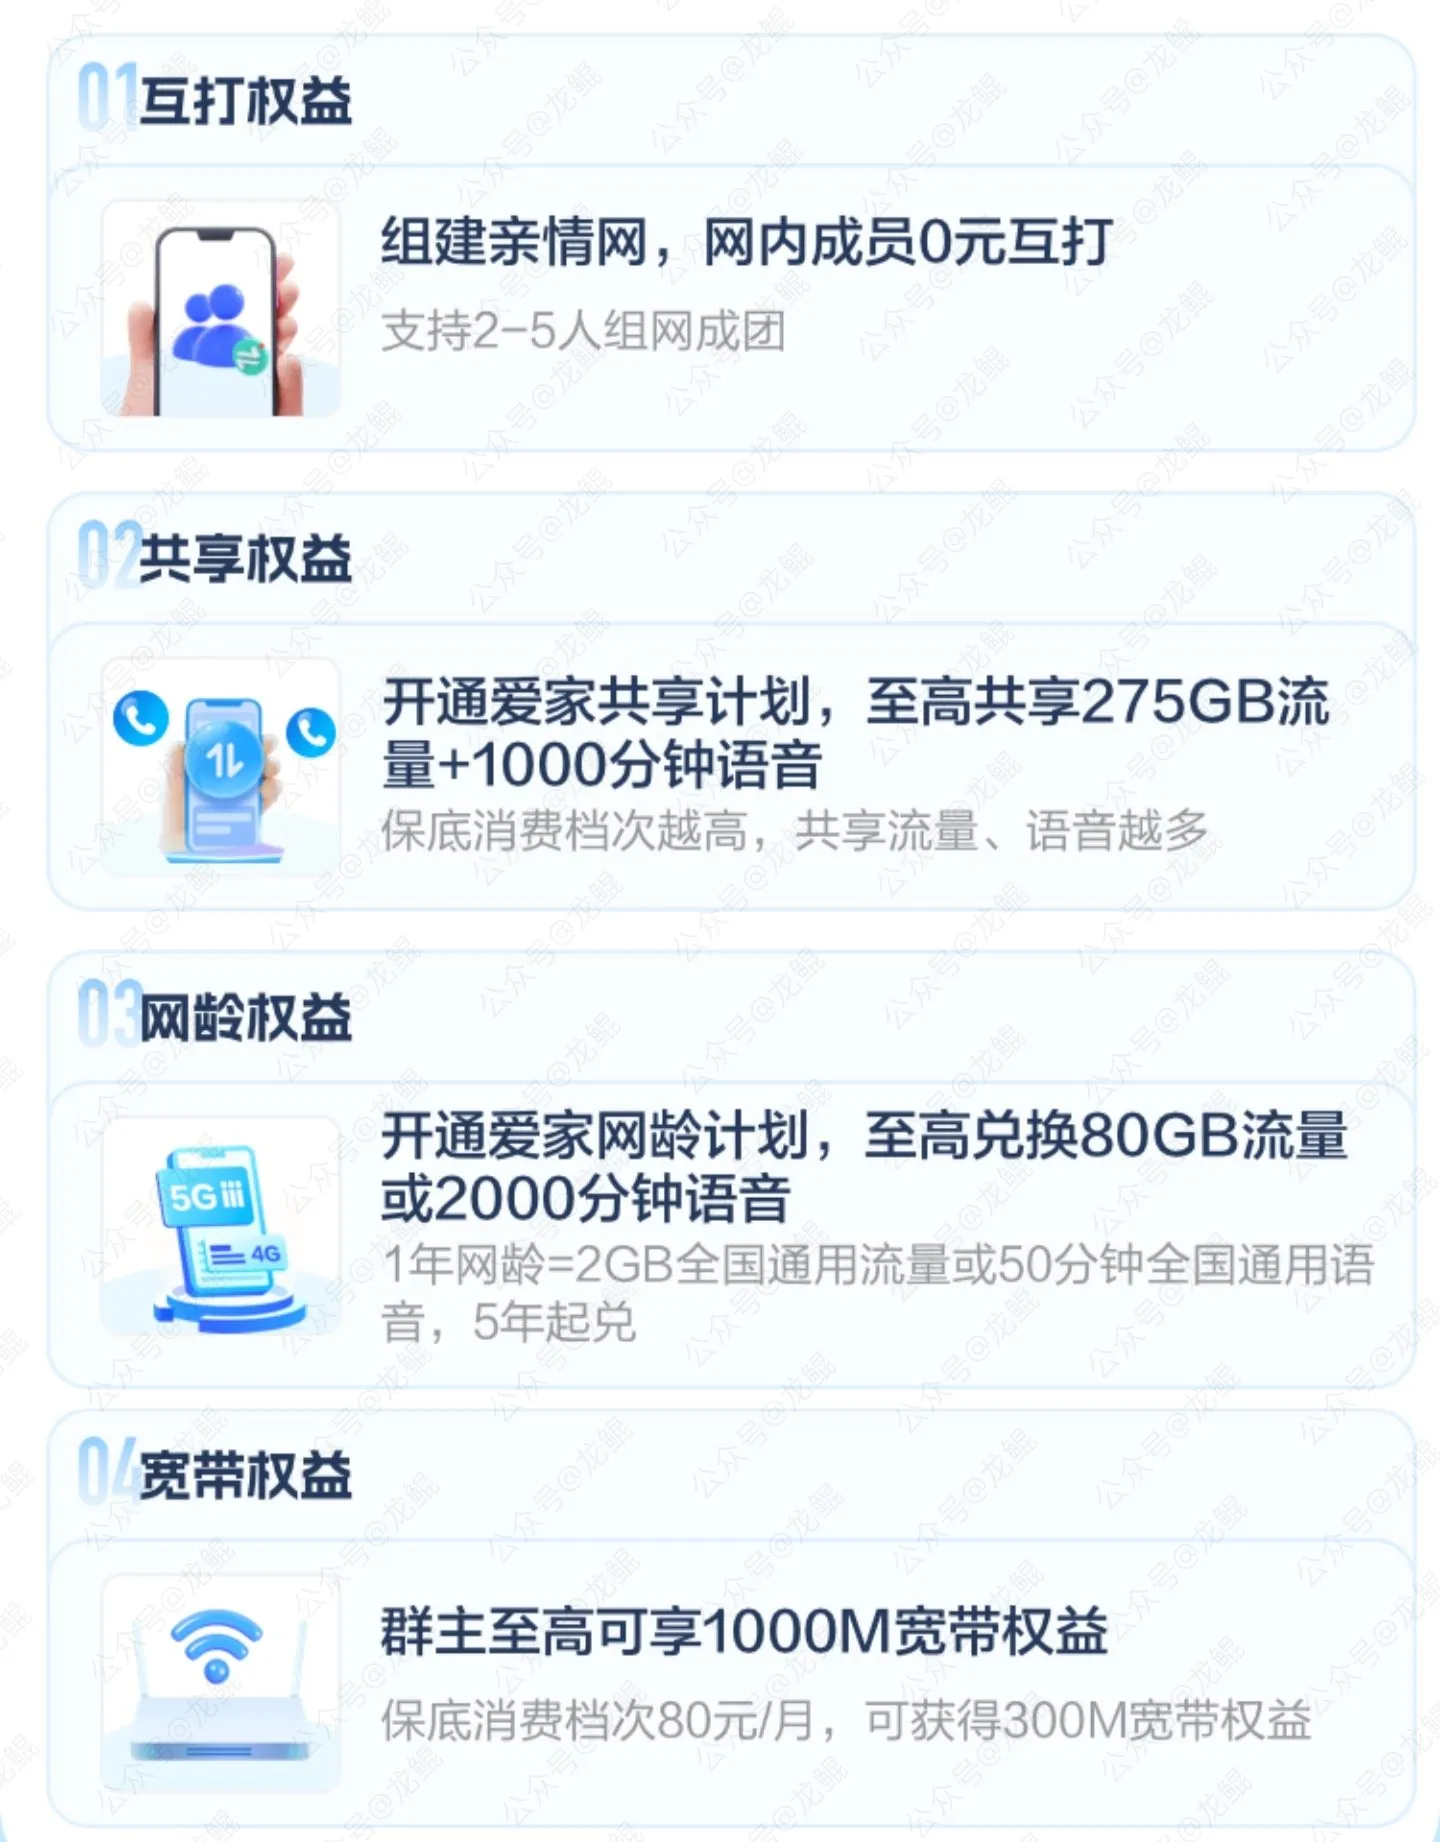
这个活动看着好像挺简单的,但实际上由于它具体的细则比较多,有很多需要注意的点,参加前建议详细了解,以免月底时产生额外消费(参考全面百G保底消费)。
1.发起人开通亲情网,邀请参与号码加入。
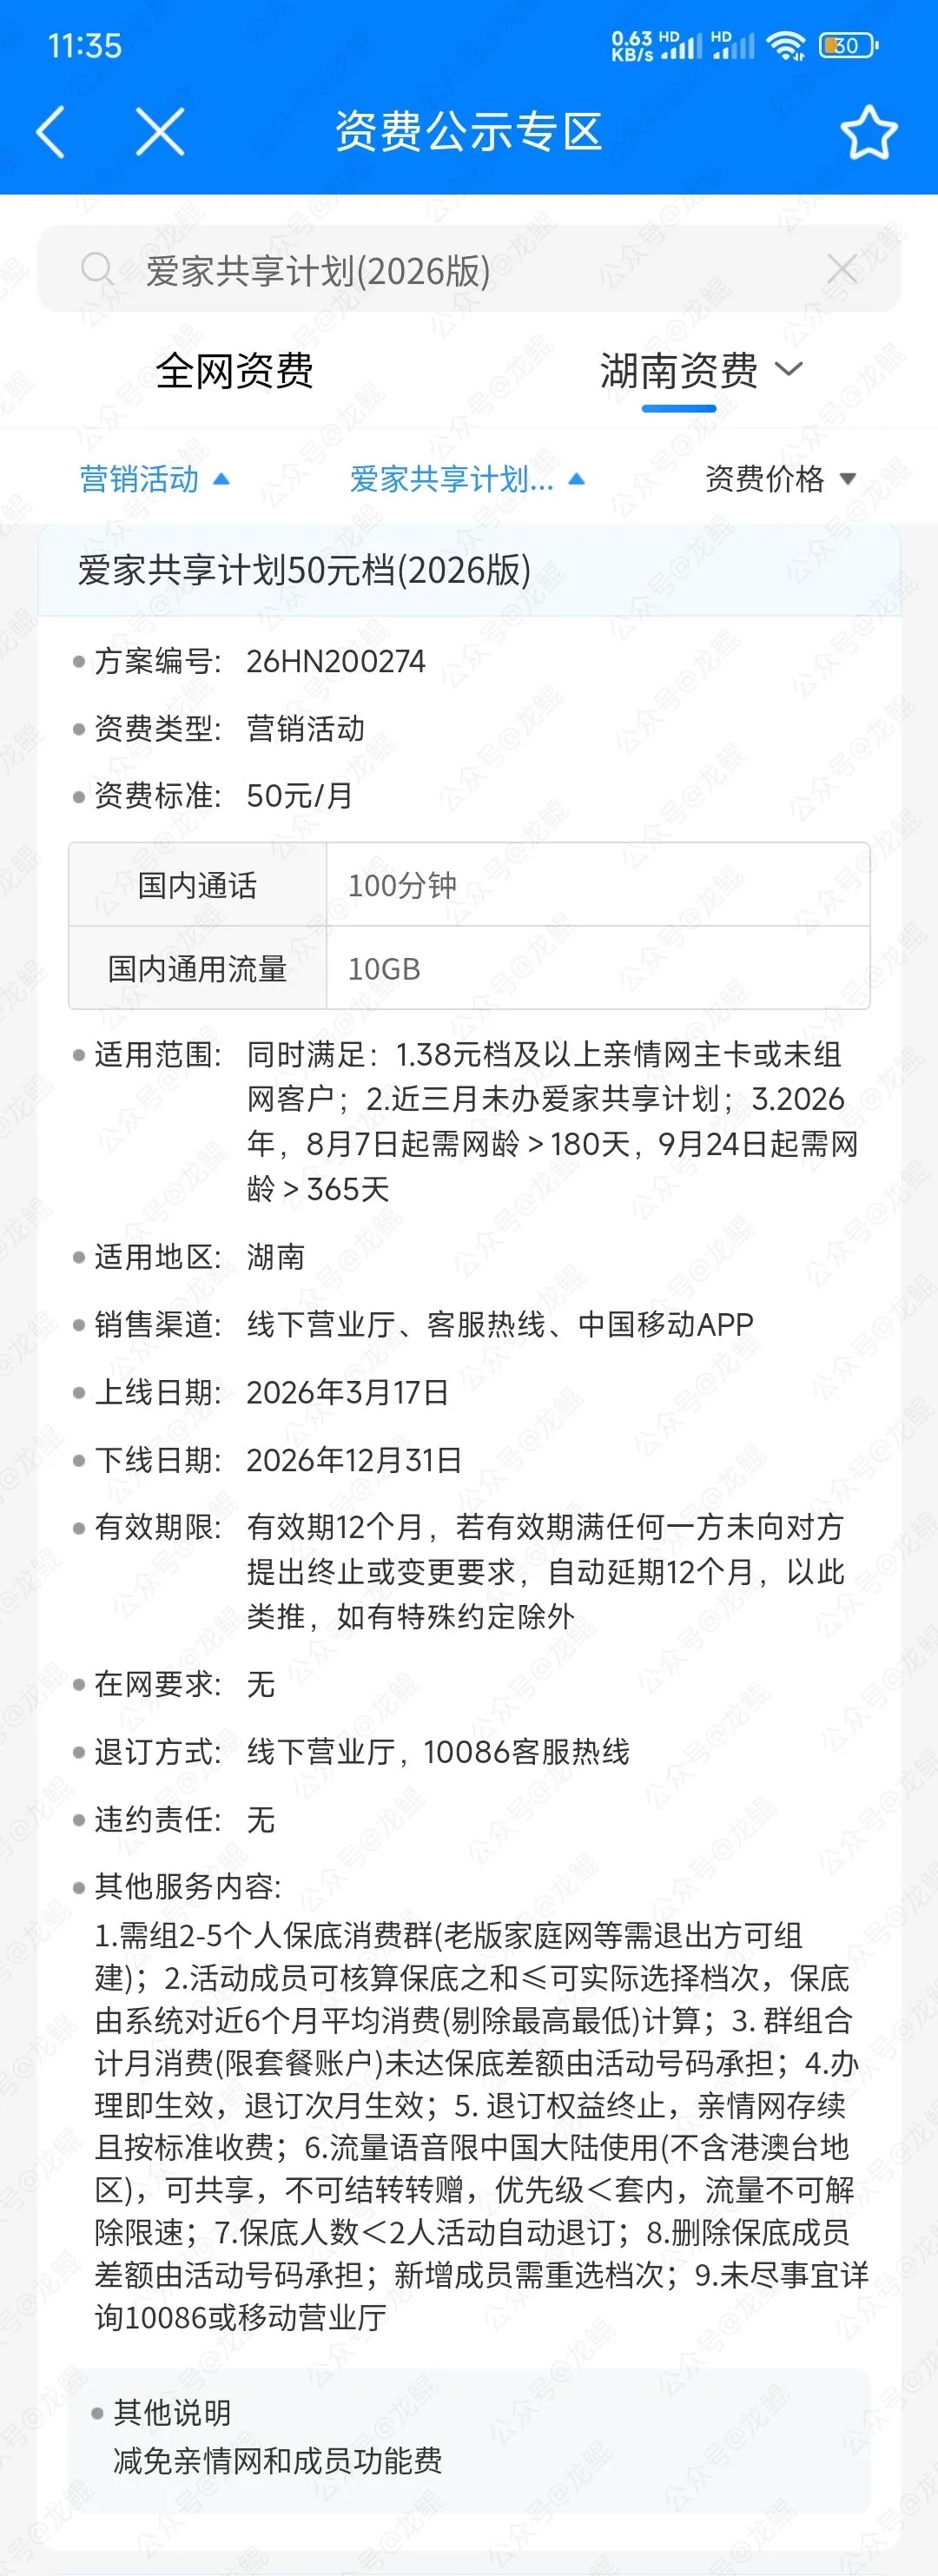
参与爱家共享计划,需开通亲情网,开通号码(亲情网主卡)要求套餐档次不低于38元、近三月未办理爱家共享计划,且自2026年8月7日起需主卡网龄>180天,9月24日起需主卡网龄>365天。组网成员号码无套餐档次要求。非亲情网客户办理爱家共享计划需开通亲情网,网内成员(含主卡)互打免费,支持短号互拨,主卡默认短号为520。亲情网业务收取6元/月功能费,成员>2人时,每增加1名成员加收1元/月成员功能费。成功办理爱家共享计划后,全额减免有效期内的亲情网业务功能费及参与爱家共享计划的成员功能费
发起人的套餐档次需要不低于38元,网龄不低于1年,邀请加入号码无套餐档次要求,0元/月也可以加入。
*这里使用的是资费公示专区的参数,与实际可能有出入,具体以各自页面显示为准。
2.选择月保底消费档次。
参与爱家计划的亲情网主卡,可选择月保底消费档次,并享受对应档次的权益,月保底消费金额由参与爱家计划的亲情网主卡及成员(含群主,最少2人,最多5人)承担,不足部分由主卡补齐。要求活动成员(主卡+成员)可核算保底之和≤可实际选择档次,各成员保底核算由系统对近6个月平均消费(剔除最高最低)计算。
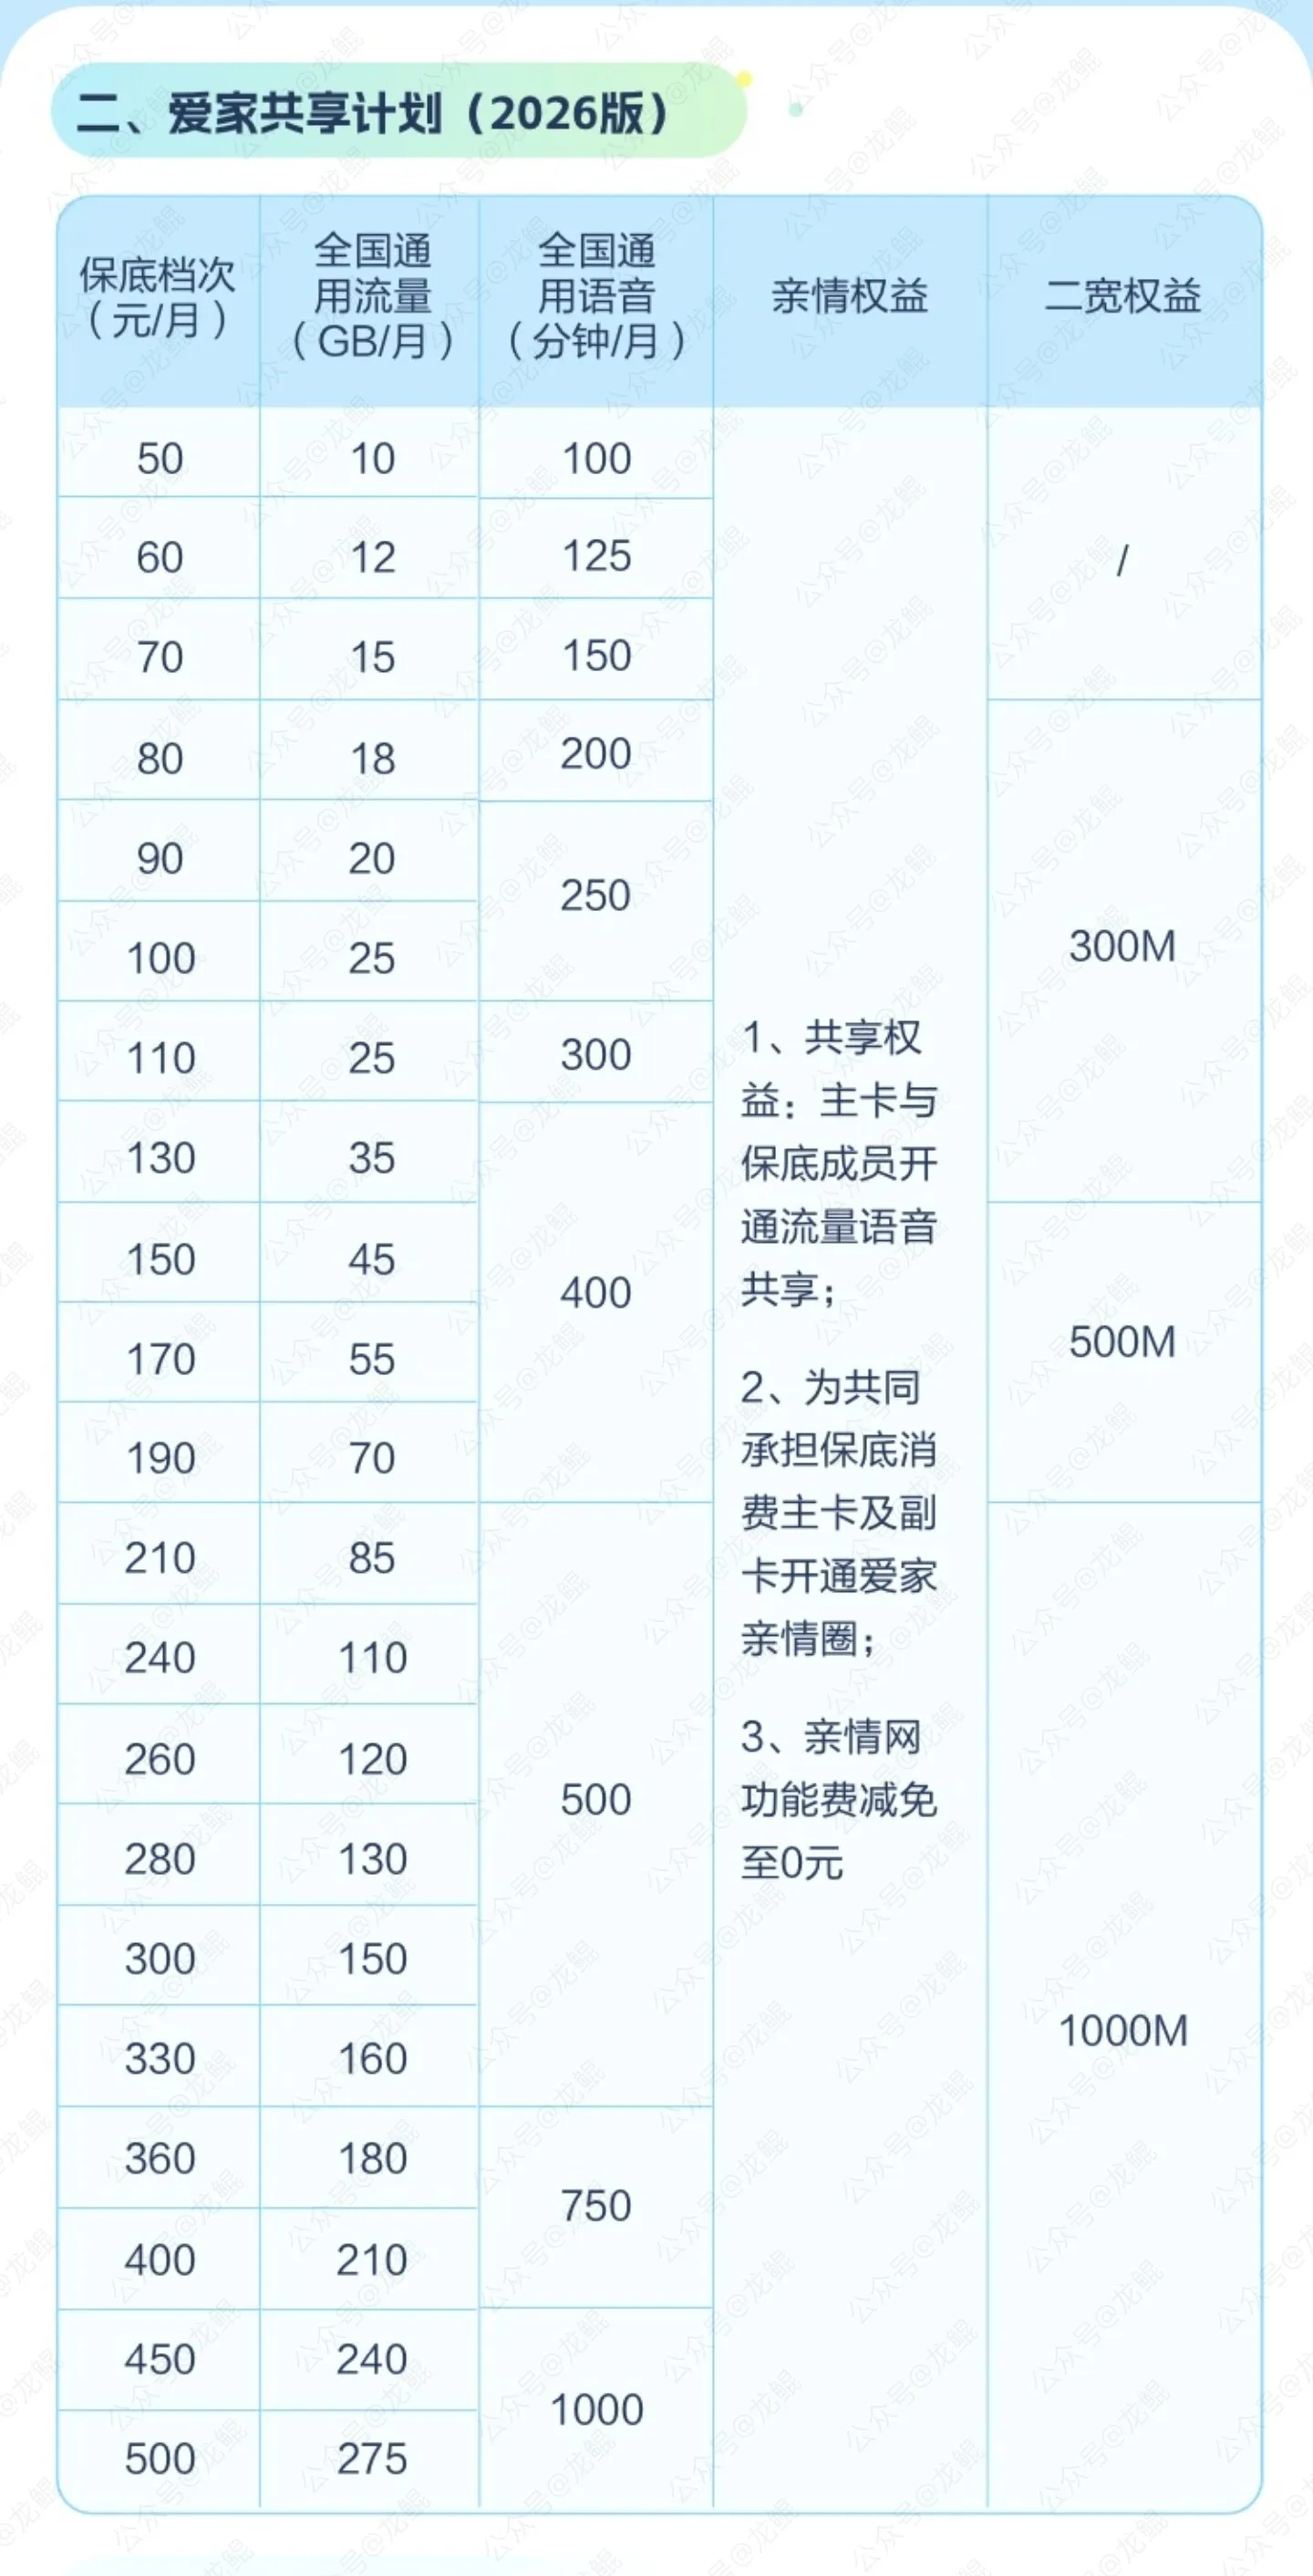
这里有几个数据需要了解,分别是单个成员认定消费、可核算保底之和、可实际选择档次。
单个成员认定消费=(前六个月消费之和-最高值-最低值)/4(向上取整)
有很多人诧异,为什么我这个月消费100元,但是认定消费却只有80元,又或者我实际应付只有80元,但是认定消费却有100元,还有我有减免、返费等算不算消费。
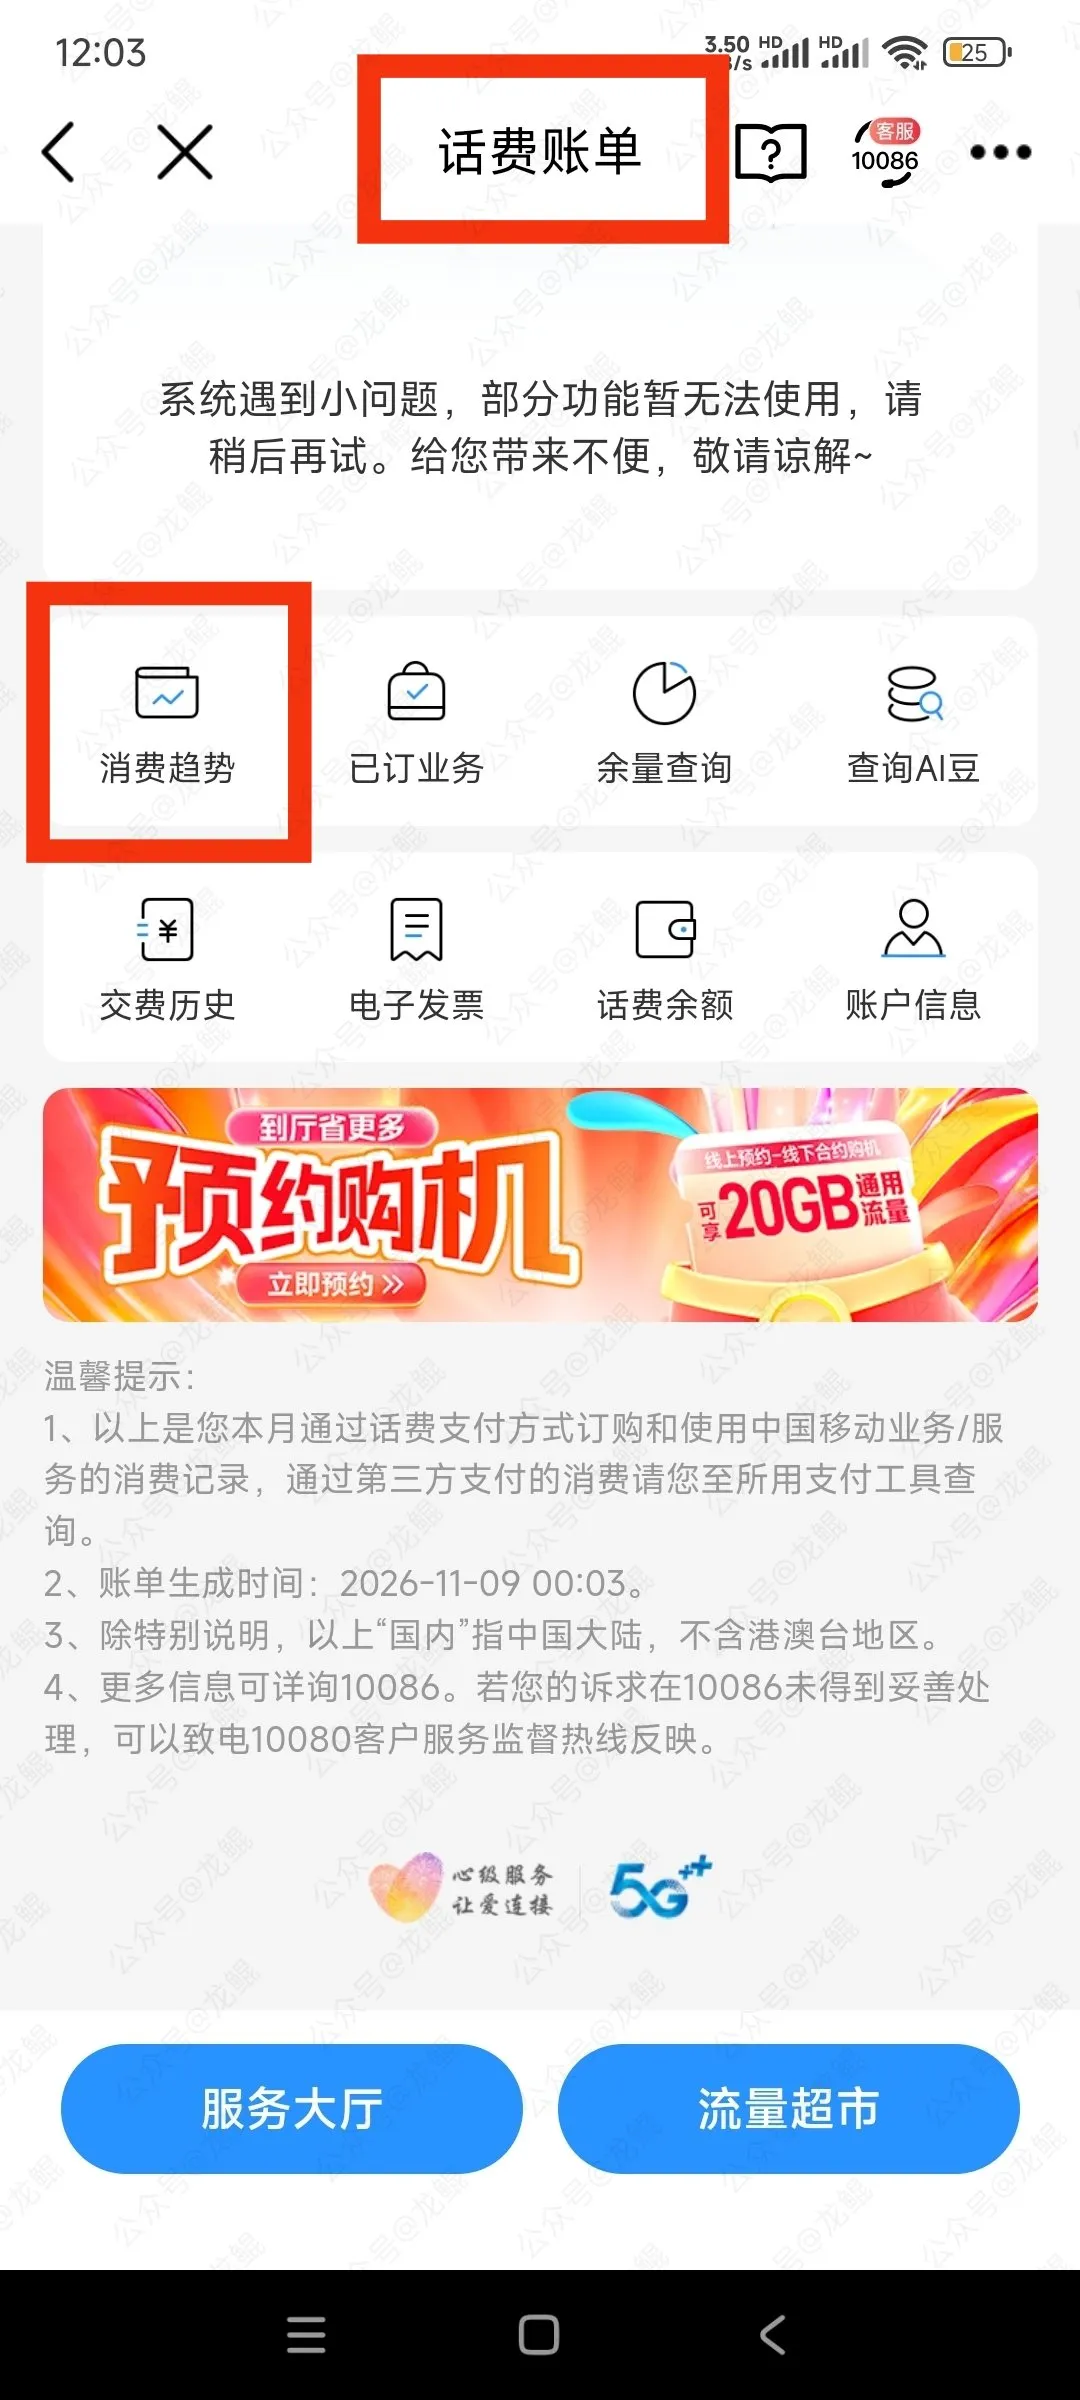
因为移动的业务众多,如果要逐一列举估计不太现实,索性我直接告诉大家一个技巧:在移动APP中点开话费账单,滑到最下面,点击消费趋势即可查看自己号码前六个月消费的有效数值。
假设前六个月消费分别为:8元、8元、8元、23元、23元、23元,那么成员认定消费计算则为:(8+8+8+23+23+23-8-23)/4≈15.5,向上取证后为16,那么该成员的认定消费为16元/月。
可核算保底之和=成员认定消费之和
假设成员有3人,认定消费分别为38元、10元、10元,那么可核算保底之和为58元。
可实际选择档次≤可核算保底之和
可核算保底之和若为83元,可选择办理80元档位的爱家共享计划。
*这里使用的是资费公示专区的数据,与实际可能有出入,具体以各自页面显示为准。
3.选择爱家网龄计划。
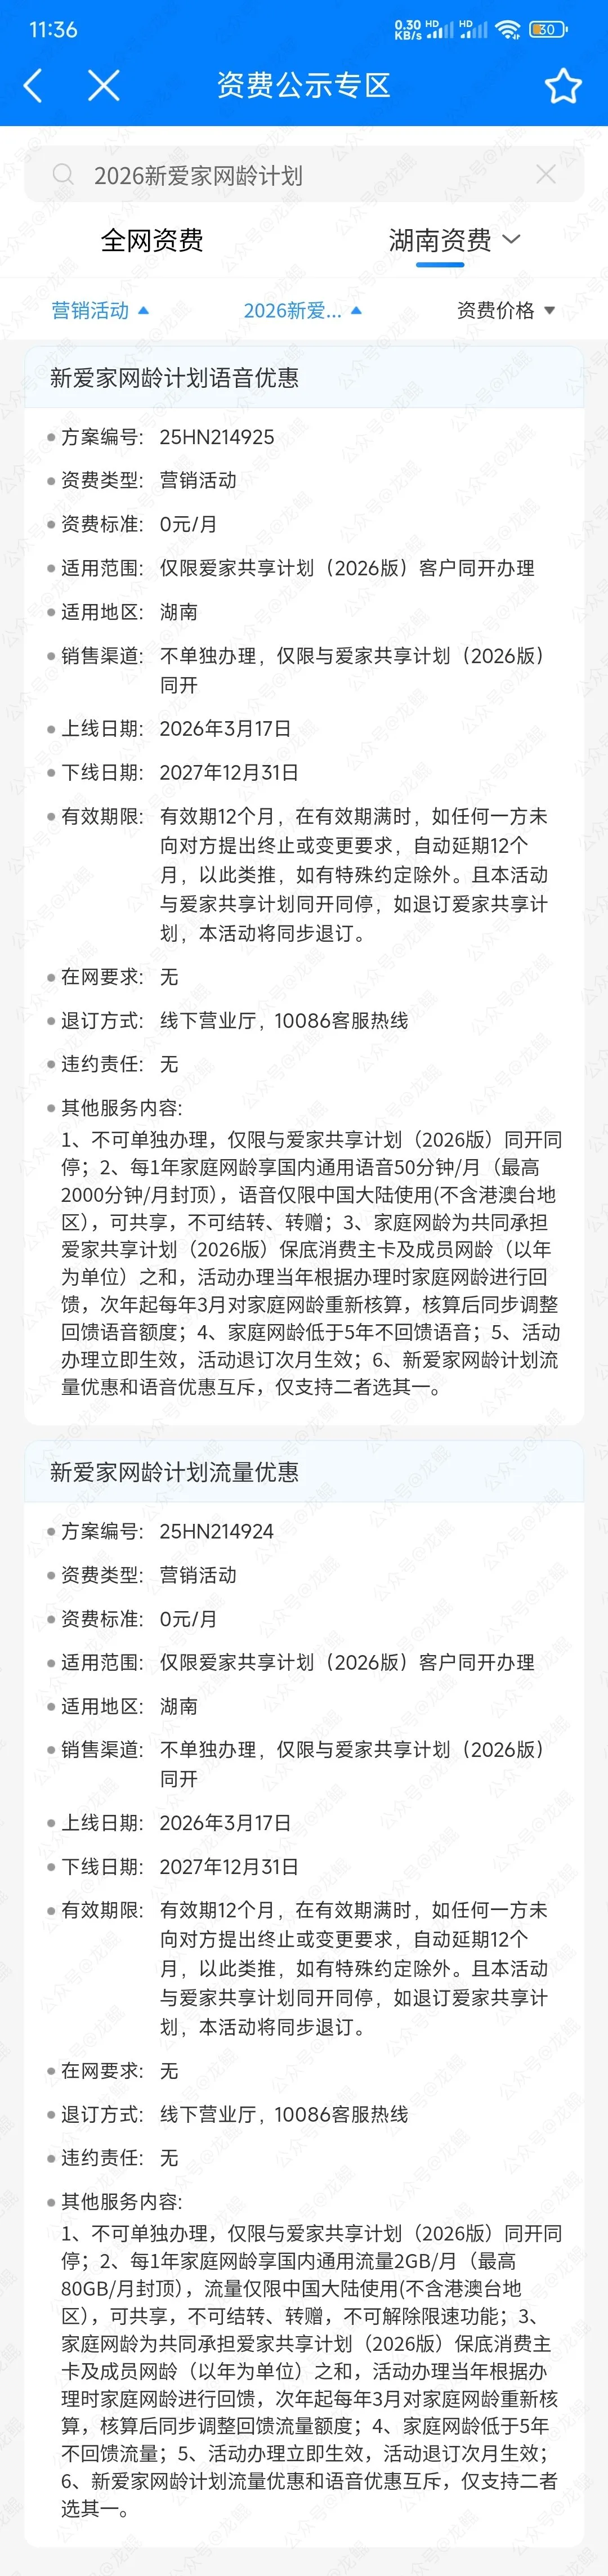
参与爱家共享计划,可办理新爱家网龄计划活动,可享受网龄语音或流量权益。家庭网龄为共同承担爱家共享计划(2026版)保底消费主卡及成员网龄(以年为单位)之和,活动办理当年根据办理时家庭网龄进行回馈,每1年网龄享2GB/月全国通用流量(最高80GB封顶)或50分钟/月全国通用语音(最高2000分钟封顶)二选一。次年起每年3月对家庭网龄重新核算,核算后同步调整回馈流量额度。家庭网龄低于5年不参与回馈语音流量。
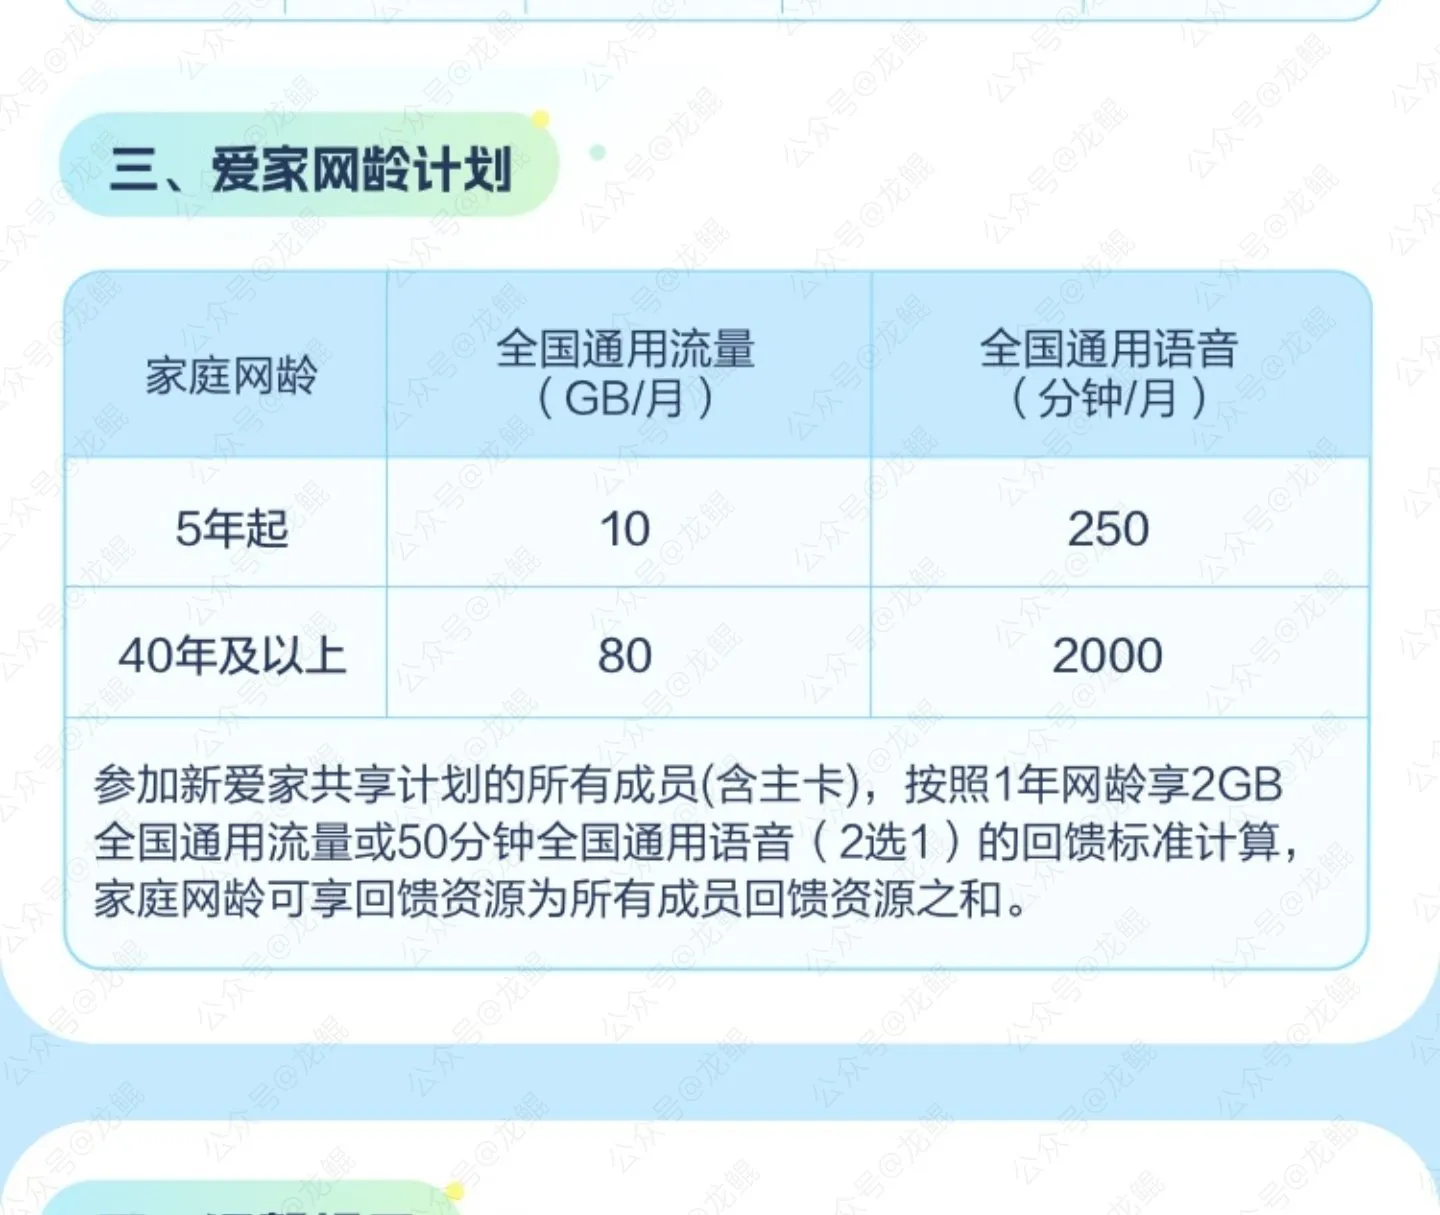
网龄计划5年起算,计算成员网龄之和,流量或语音由发起人任选其一,成员一起共享。
若所有成员的网龄之和为40年,选择流量会获得40*2=80G共享流量,选择语音则会获得40*50=2000分钟共享通话。
*这里使用的资费公示专区的数据,与实际可能有出入,具体以各自页面显示为准。
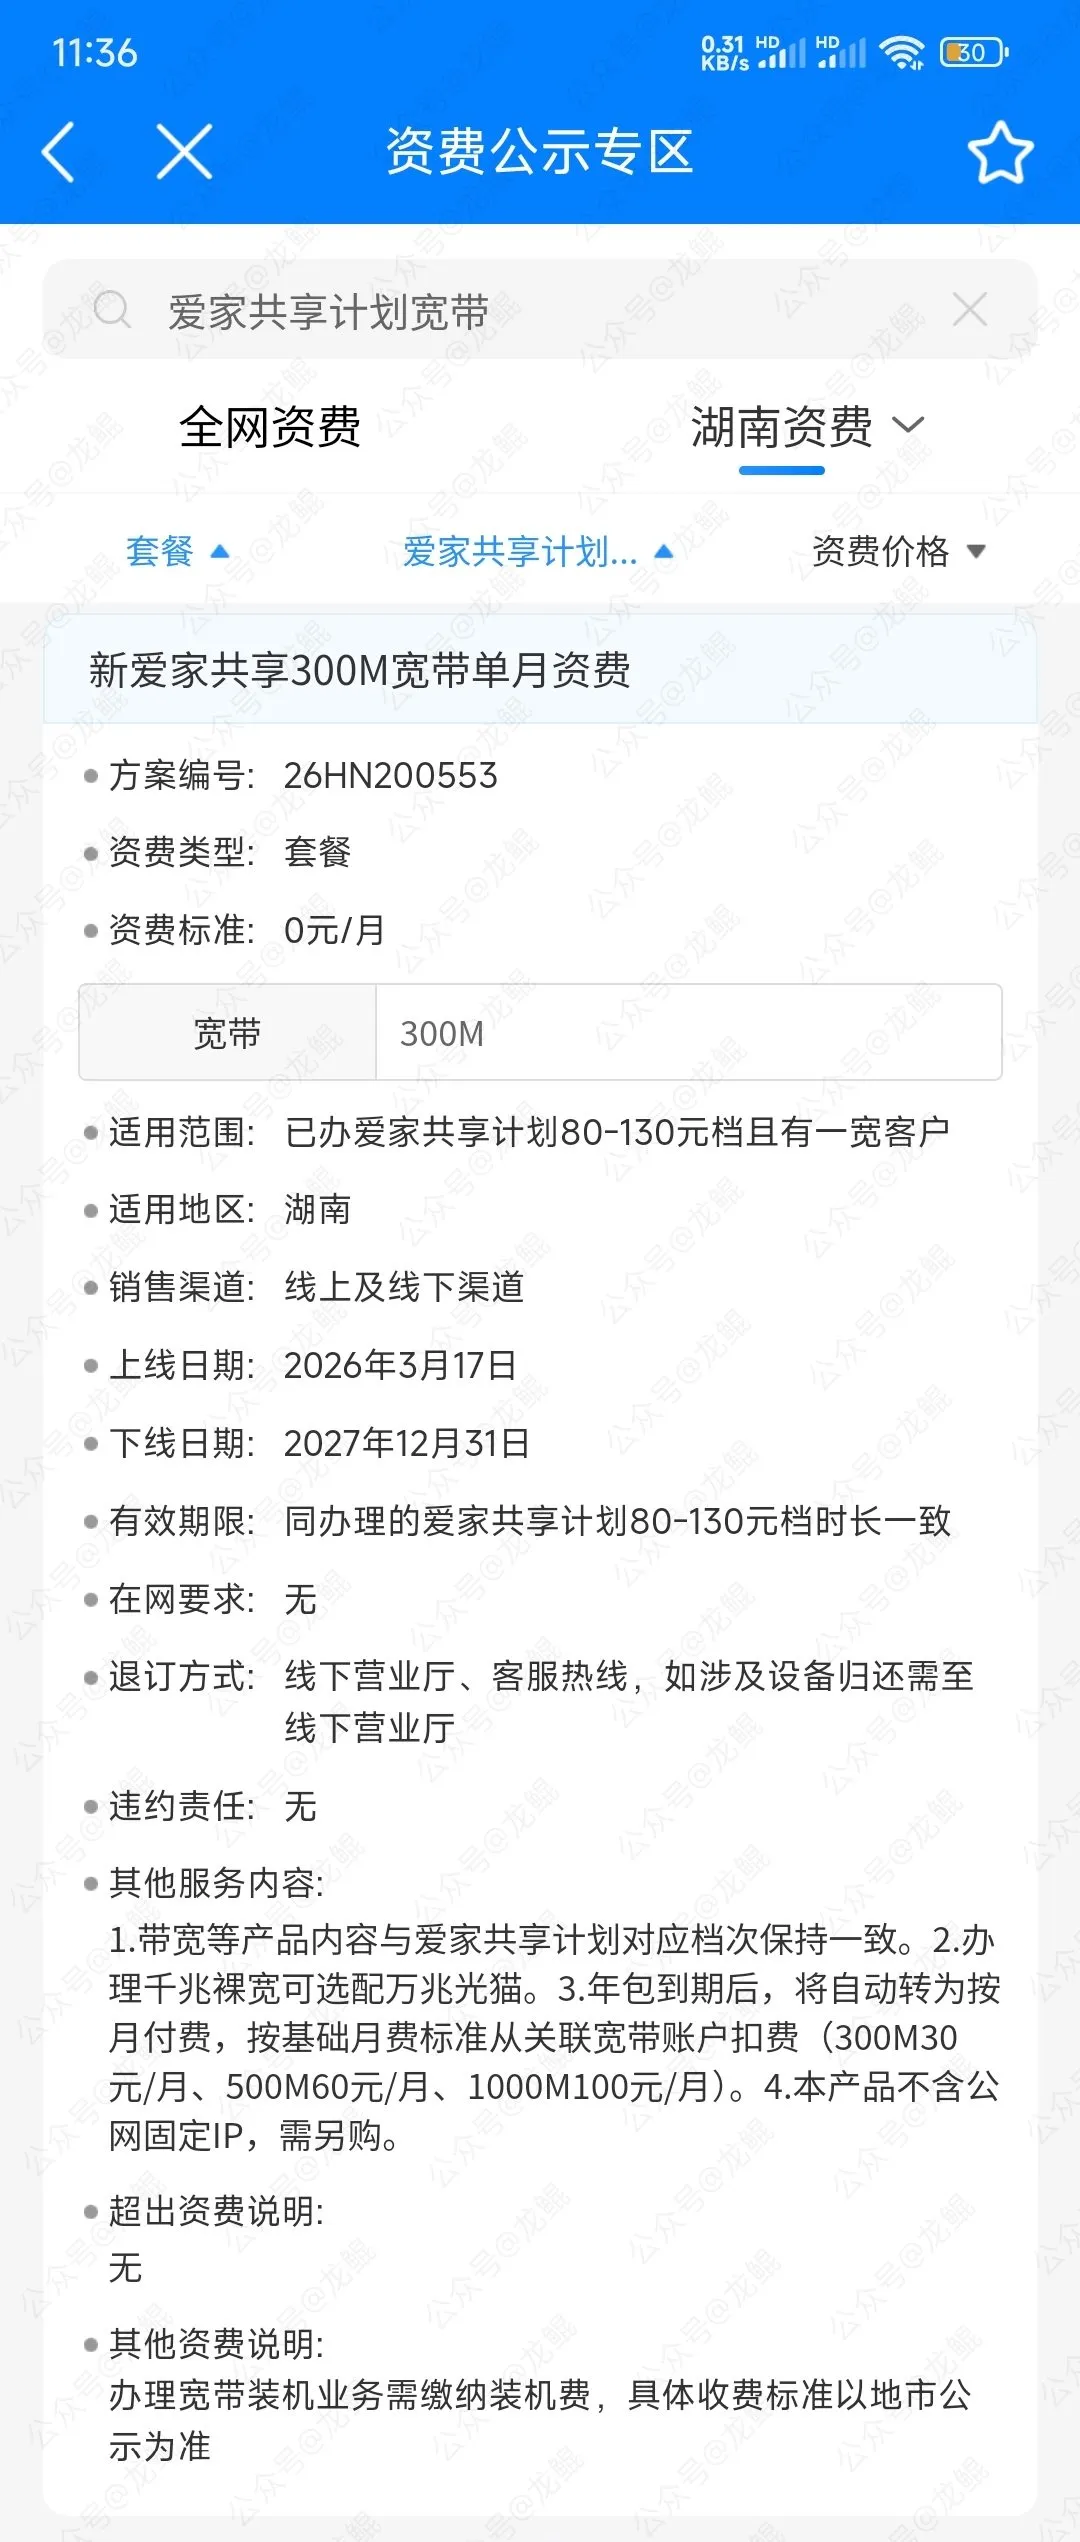
特别提示:爱家共享计划内包含的二宽权益仅限办理了80元档及以上爱家共享计划且已经安装了湖南移动宽带的客户领取安装。
80元档以上的爱家共享计划才会包含这条宽带,需要发起人名下已经有一条宽带,才可以安装爱家共享计划这条宽带。
参与爱家共享计划的成员不可主动退出,仅限主卡删除成员,删除成员同步退出亲情网,次月生效。因参与计划的成员变化或其它原因导致参与主卡及成员的月消费总额未达到爱家共享计划档次,则需主卡补齐差额。
参与爱家共享计划后,因各种原因导致成员月消费之和未达实际选择档次,由发起人补齐差额。举个例子,假设办理了50元档爱家共享计划,发起人或成员因为降档、停机保号等原因,导致月消费之和只有40元,这中间的差额10元需要主卡补齐(单个成员月消费金额参考消费趋势,具体路径见上方“2.选择月保底消费档次。”或移动APP爱家共享页面直接查看)。
爱家共享计划、爱家网龄计划活动办理立即生效,活动退订次月生效。办理成功后如需取消,可通过线下营业厅、客服热线退订,无违约责任,无需额外赔付违约金,退订后权益终止,亲情网、宽带存续且按标准收费。
虽然订购爱家没有合约,可随时退订,但退订后亲情网、宽带会继续存续,需要单独取消,否则按标准收费(该内容仅为个人理解,未进行实际操作)。
爱家共享计划、爱家网龄计划赠送的流量和语音仅限中国大陆使用(不含港澳台地区),可共享,不可结转、转赠,优先级低于套内资源,流量不可解除限速。
爱家共享计划和网龄计划中的流量均可共享,但不能结转,并且优先级会低于套餐内,这里可能出现什么问题,就是你套内流量可以结转,你想优先使用爱家中的流量,这个是不行的,又或者你本身是共享语音给副卡使用,一共500分钟,而你的语音缺口大概是1000分钟,参加爱家计划刚好可以满足,但是如果你要使用爱家计划的语音,必须先使用完套餐内原有的500分钟,才可以使用爱家计划中的1000分钟,在这种情况下,虽然你的语音需求满足了,但副卡就会没有任何套餐内的通话使用,这里需要格外注意。
保底人数<2人活动自动退订;新增成员需重选档次。
因为活动上限是5人,有些人开启后可能想要重新邀请人,这时候如果一次性删除所有已加入成员,想要重新邀请其他成员会导致自动退订活动,退订后想要重新发起,需要间隔3个月(目前该活动在资费公示专区显示的下线时间为2026年12月31日)。新增成员会重选档次,这里对应现在的场景是,如果你原有可核算保底之和为53元,对应的档次是50元档,再邀请新成员,哪怕对方认定消费为0元/月,在现有情况下可能也无法继续选择50元档,而只能选择60元档。
根据社交媒体公开信息,已经办理爱家网龄计划的用户,不用任何操作,系统会根据成员的数量,自动添加多个爱家网龄计划包,例如成员数为5个,网龄之和超过40年,之前选择的爱家网龄计划是流量,那么赠送的流量之和为400G,选择语音规则亦是如此,原因不详。
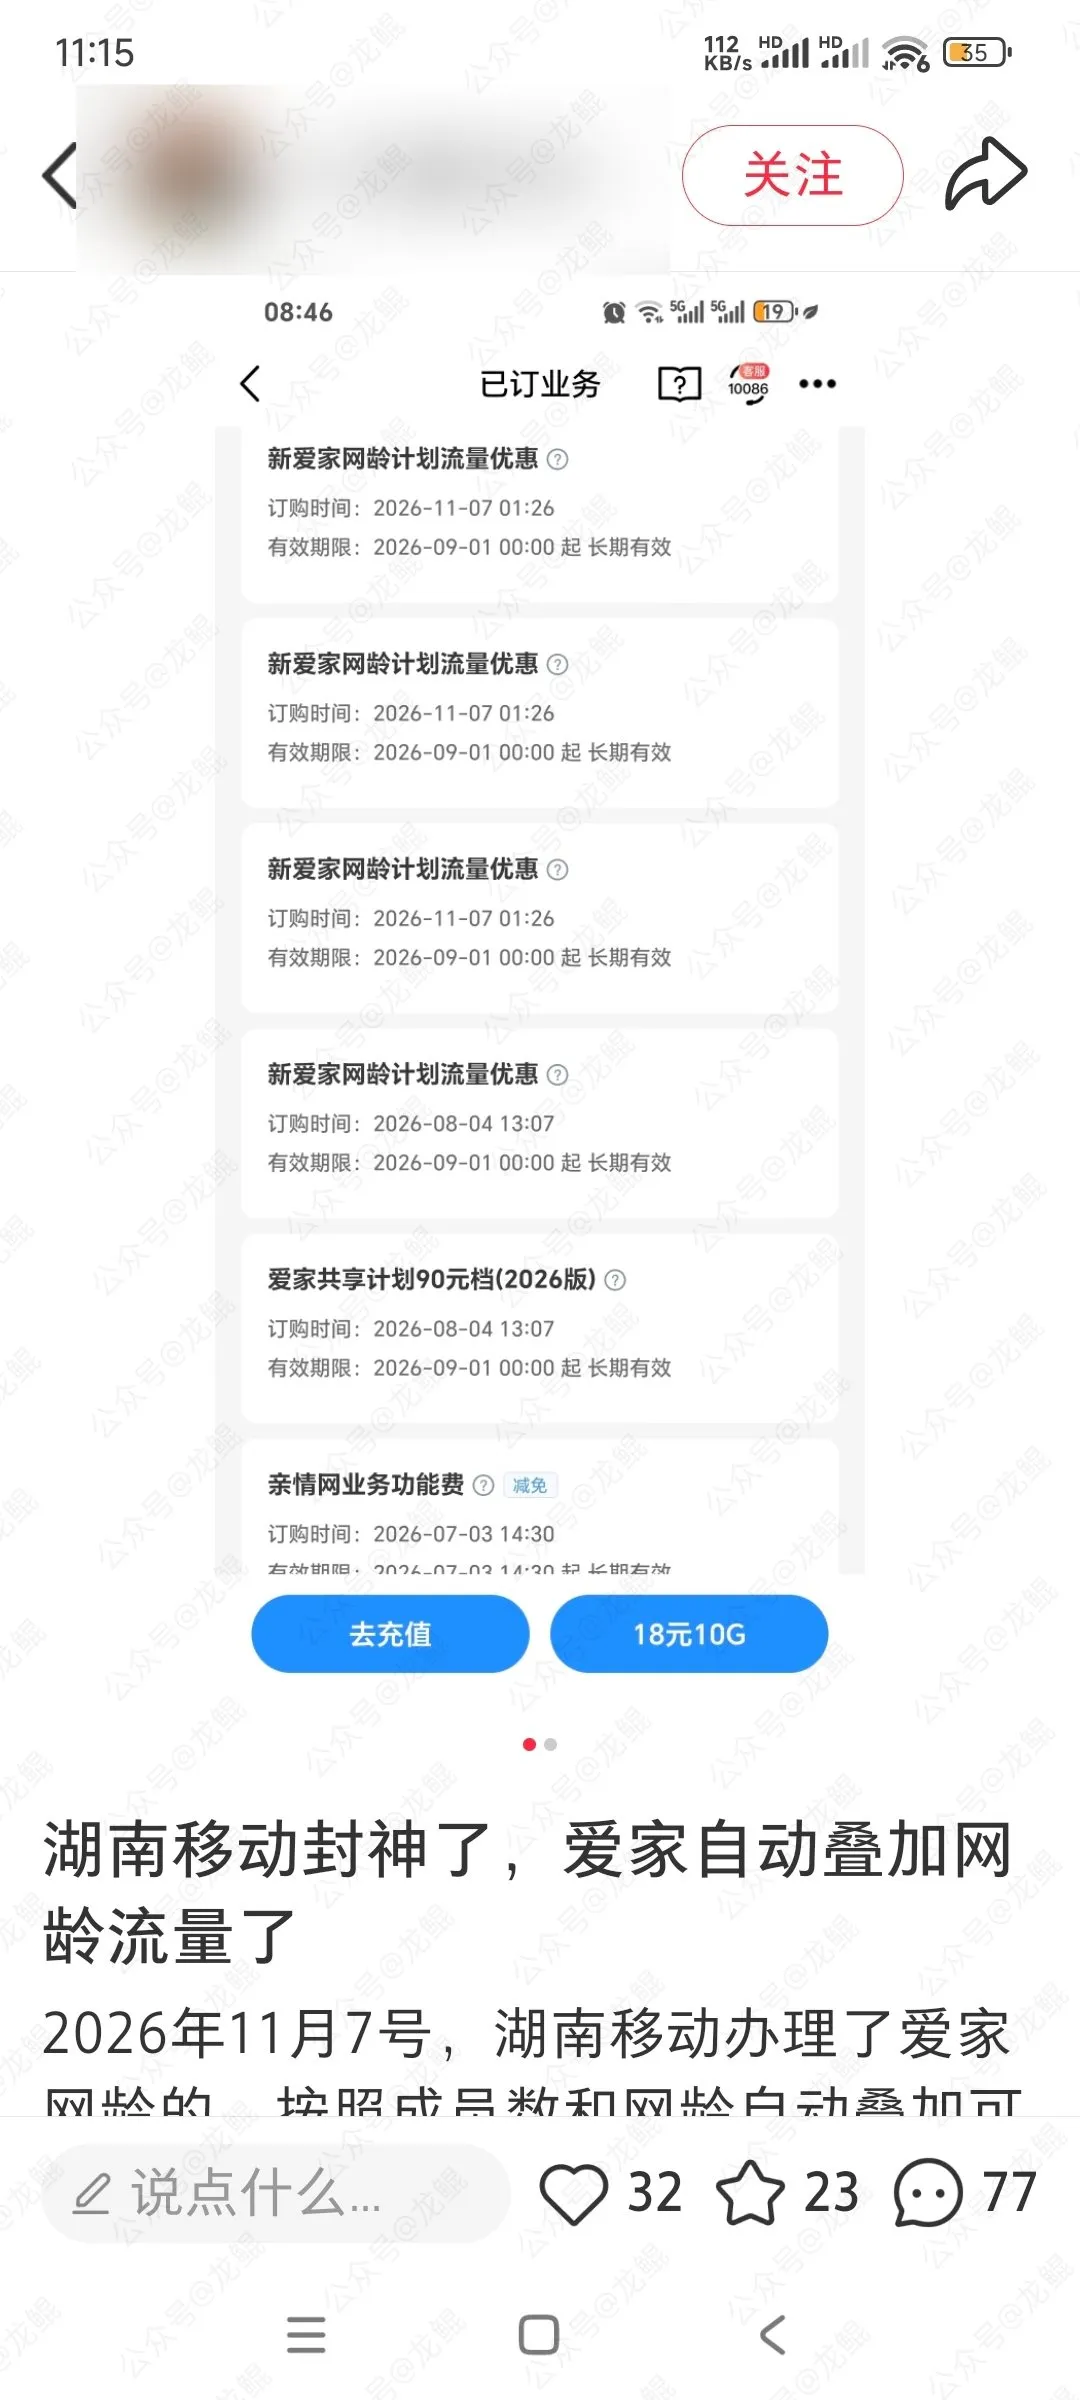
*该截图为社交媒体公开信息,发布时间为11月7日。本人不对截图内展示具体内容的真实性负责,不保证现在办理爱家计划会自动添加对应业务,截图除添加水印外,其他内容均未做修改。
根据网友分享信息,在安装完爱家共享计划宽带后,会有短信告知是否0元升级第一条宽带为千兆,回复“是”后,添加一宽千兆提速包业务,失效时间为二宽拆机后。
其实这个活动最早上线时间是2026年3月17日,距今已有大半年的时间,之所以最近办理的人开始增多,一方面在于全民百G活动的提前下线,另外一方面就是因为自动添加的爱家网龄计划包,虽然早前社交媒体上已有消息称爱家网龄计划流量包上限要从80G升级至200G,但一直未有正式消息。不管怎么说,如果觉得用得上,还是可以先参加再说,毕竟也没有合约,不需要再取消就行。
*本文相关信息来自但不限于移动APP爱家活动页面、移动资费公示专区、社交媒体等公开渠道。所有内容均为个人理解,与移动官方无任何关联,不对活动做任何保证,具体以官方活动为准。
2026-10-31 21:43:10
这些年因为各种原因遇到了非常多的“钓鱼”网站,有些“钓鱼”网站已经做得非常的逼真了,加上现在AI技术的发展,“钓鱼”网站的制作效率也大大提高。
期间很多次想要总结分享这些年防范“钓鱼”网站的技巧,但总因为这样那样的原因就此搁置,直到最近一段时间,这个想法又开始愈发的强烈,于是开始动笔,写下了本文。
本文是一篇面向所有人的科普文章,文章中所有提到的专属名词都会以大白话的形式讲述,内容虽然较长,但请放心食用。
在进入正题之前,我们先了解一些概念。
什么是IP地址?
相信大家之前在各种地方都有听到过IP地址这个词,在电视剧里,我们常常看到通过IP地址定位到一个人使用的电子设备。这里我们不需要知道它具体的概念,只要知道它类似于我们使用的身份证号码,具有身份标识的作用,通过身份证号我们能识别到一个人,通过IP地址我们能标识一个时间段使用这个IP地址的设备。
什么是域名?
就像我们平常不会直接叫对方身份证号一样,一般情况下访问网站我们也不会直接访问IP地址,因为IP地址是一串数字和点的组成,例如“192.168.1.1”,它不利于平常的记忆,不方便日常访问,于是在IP地址之外,我们又取了个“名字”叫域名,域名的命名可以使用英文、数字和连接符(-),这样我们就可以根据品牌等特性组成好记的前缀。简单理解域名就是IP地址的名字,只是这个名字具有唯一性,而我们平常的名字则存在重复。
什么是ICP备案?
ICP备案是我们国家对非经营性互联网信息服务实行的备案管理制度,依据相关的规定,境内所有非经营性互联网信息服务提供者都需要如实填报信息进行备案,未经备案不得提供服务。虽然规定的是非经营性互联网信息服务才需要进行ICP备案,但在实践层面,经营性互联网信息服务也会进行ICP备案。最终产生的效果就是,绝大部分情况下,只要是国内平台提供的国内互联网服务,那么就会进行ICP备案,否则连网站都无法被正常访问。
什么是公安联网备案?
依据相关规定,相关单位自网络正式联通之日起30日内,需到所在地的省、自治区、直辖市人民政府公安机关指定的受理机关办理备案手续。因为各种各样的原因,部分网站可能未进行公安联网备案。
通过前面的科普,我们简单了解了一下IP地址、域名、ICP备案制度和公安联网备案,我们知道了绝大部分情况下,国内的互联网服务都需要进行ICP备案,那么我们只要通过查询当前网站的ICP备案信息,那么就可以在一定程度上判断这到底是不是一个仿冒假冒“钓鱼”网站。下面介绍具体的步骤:
1.提取主域名
因为工信部的ICP备案系统只能进行精确搜索,输入非主域名以外的其他内容,会显示暂无数据,所以我们先要提取主域名,但主域名的识别对非专业人员来说还是有些繁琐的,这里推荐大家使用一键工具,可在任意搜索引擎输入:“在线主域名提取”,就可找到该类工具。然后将需要提取主域名的链接放入该类工具中,复制提取后的主域名即可。
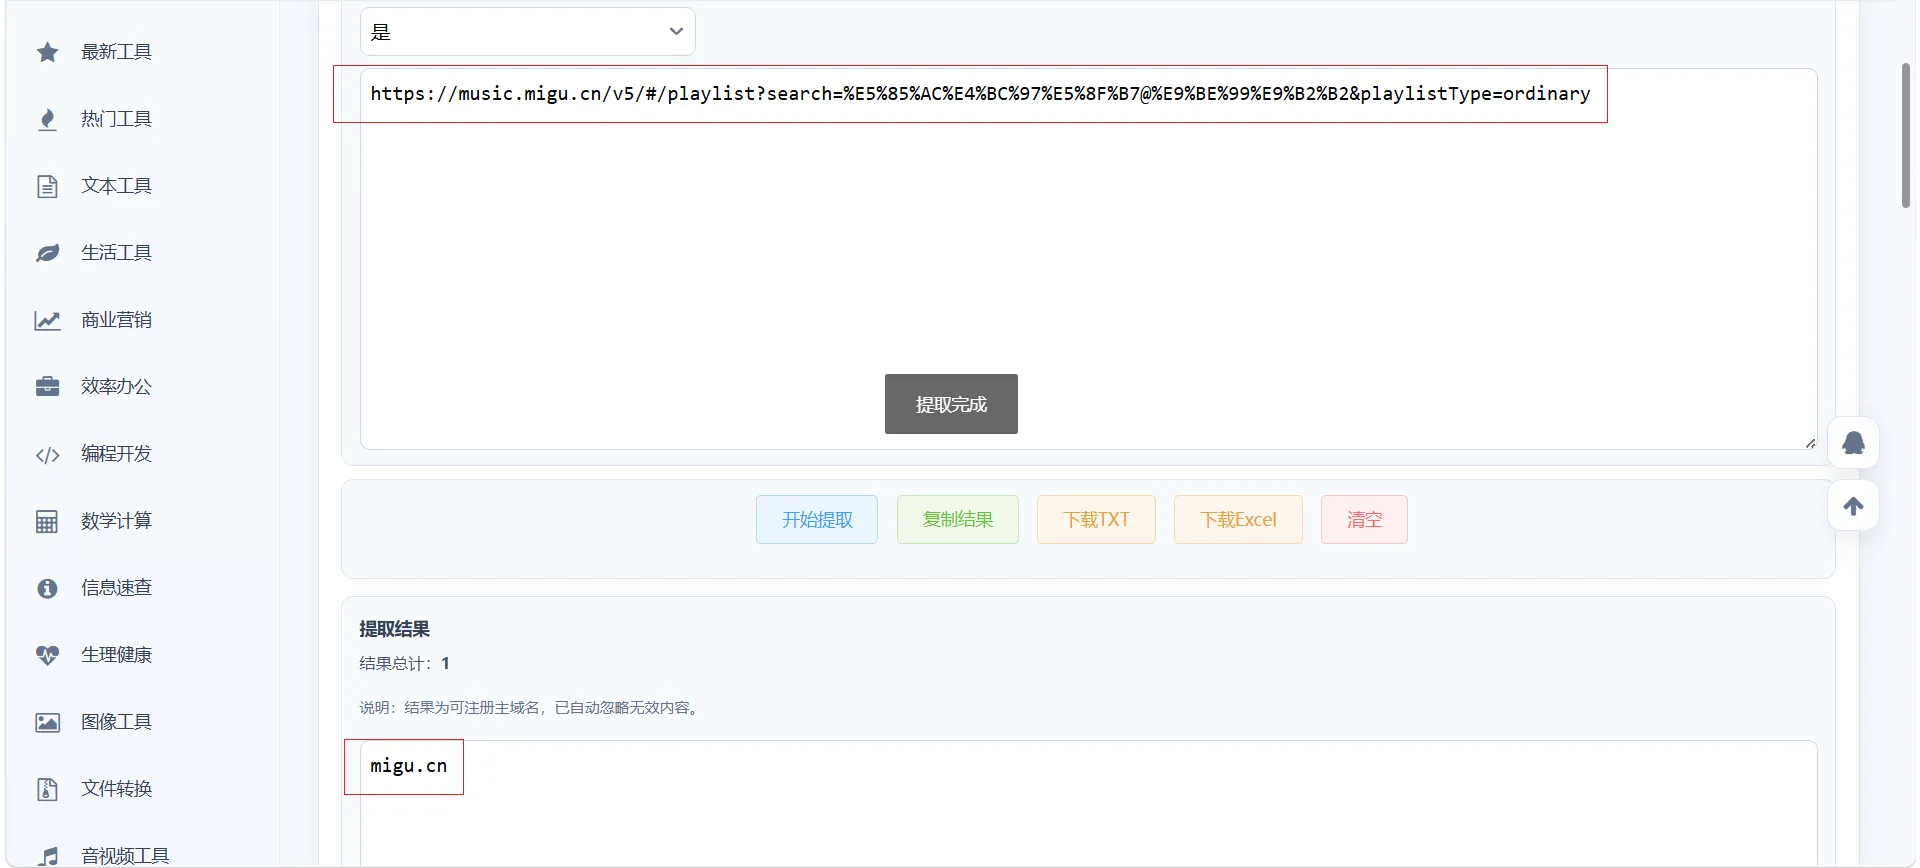
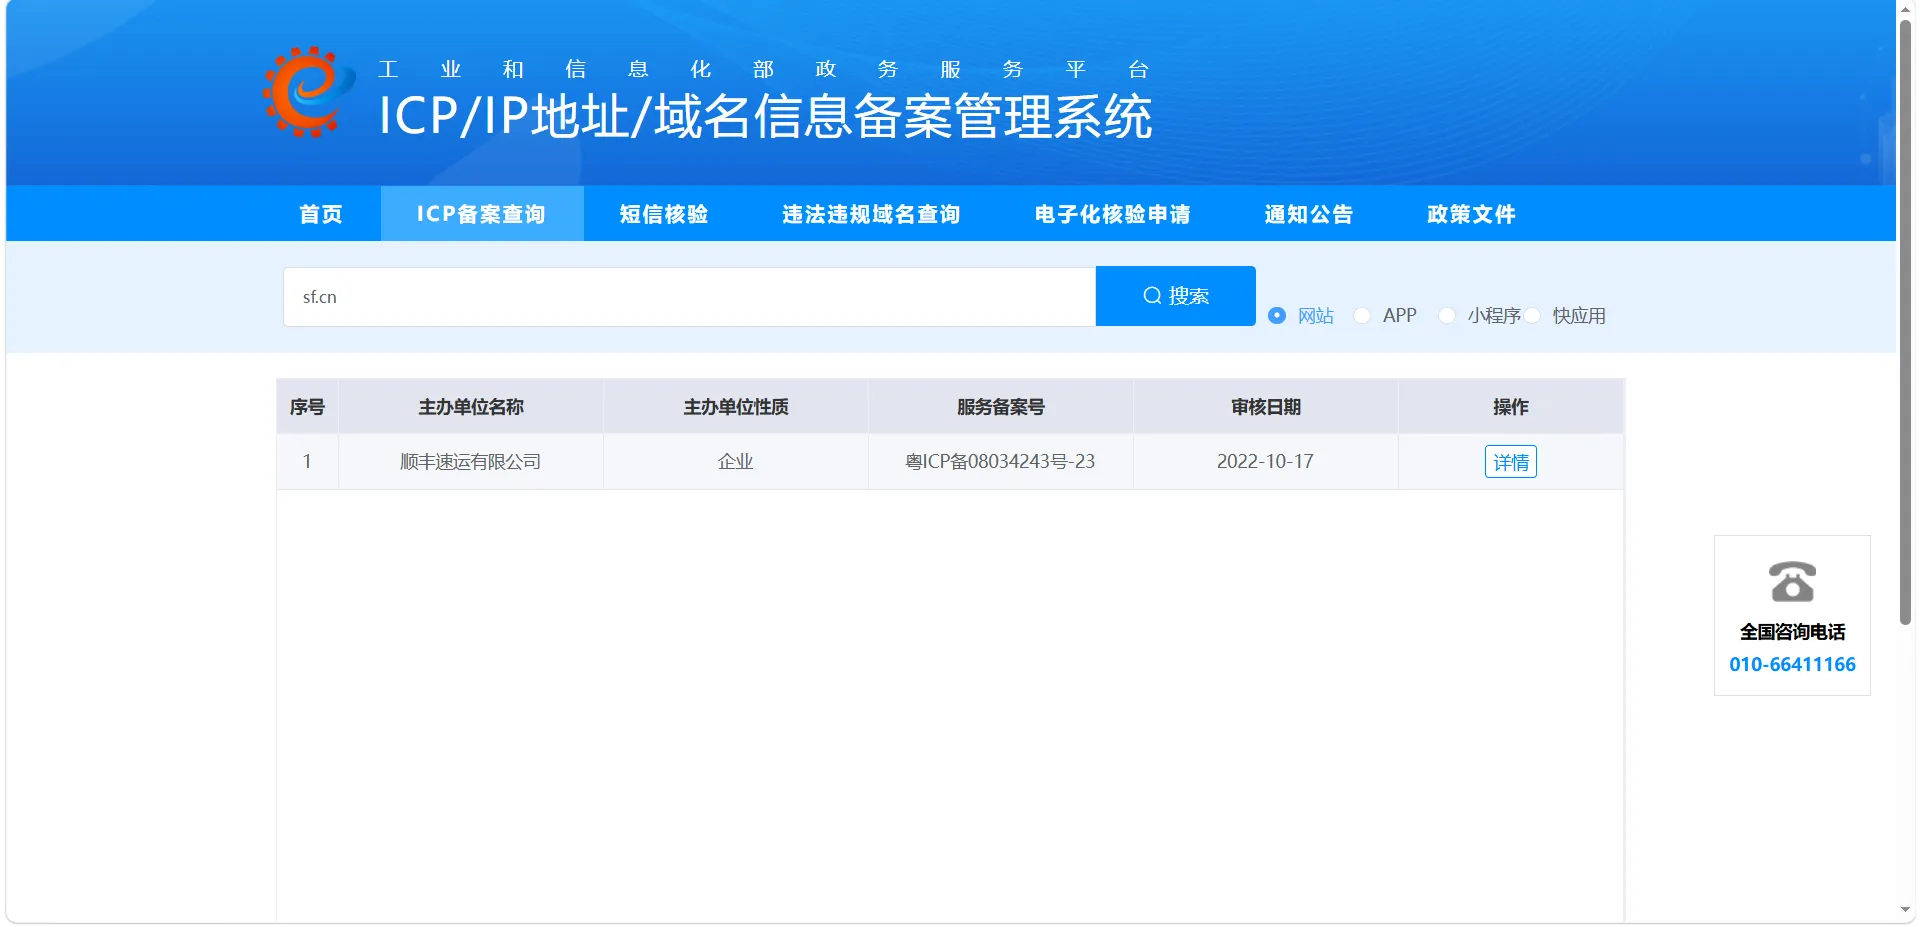
2.通过工信部ICP备案系统查询
打开工信部ICP/IP地址/域名信息备案管理系统https://beian.miit.gov.cn/ ,输入上方提取的主域名搜索即可查询到该网站的主办单位。
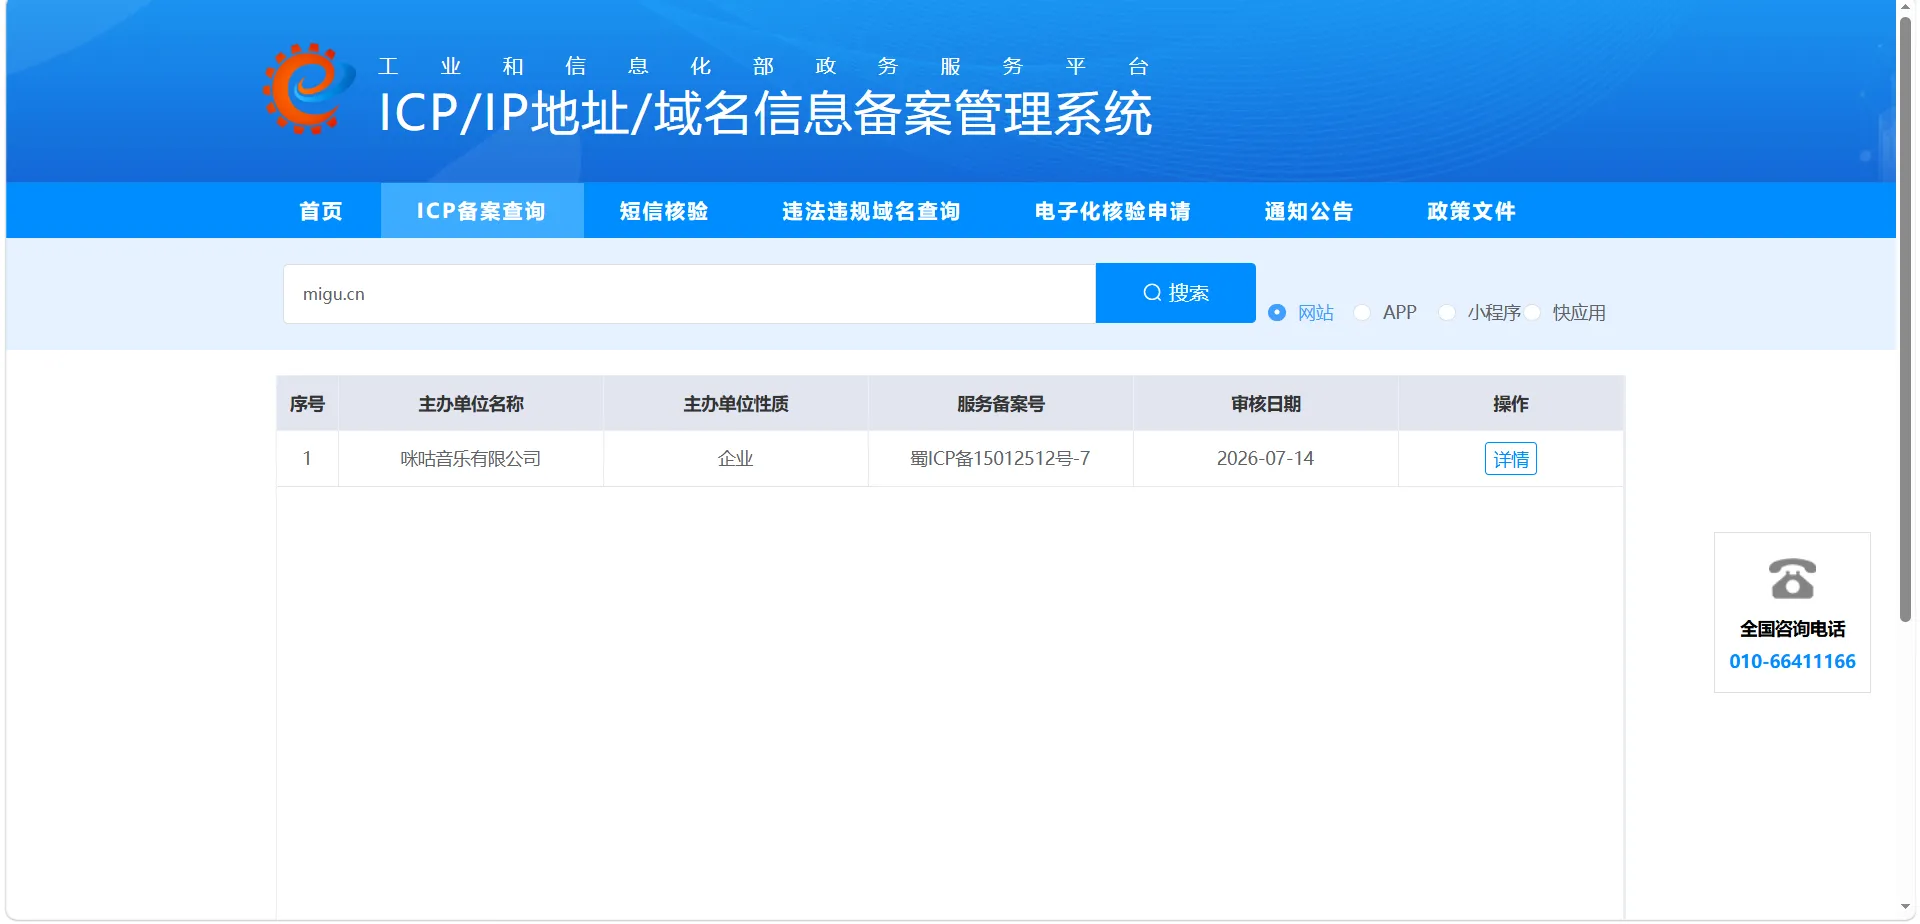
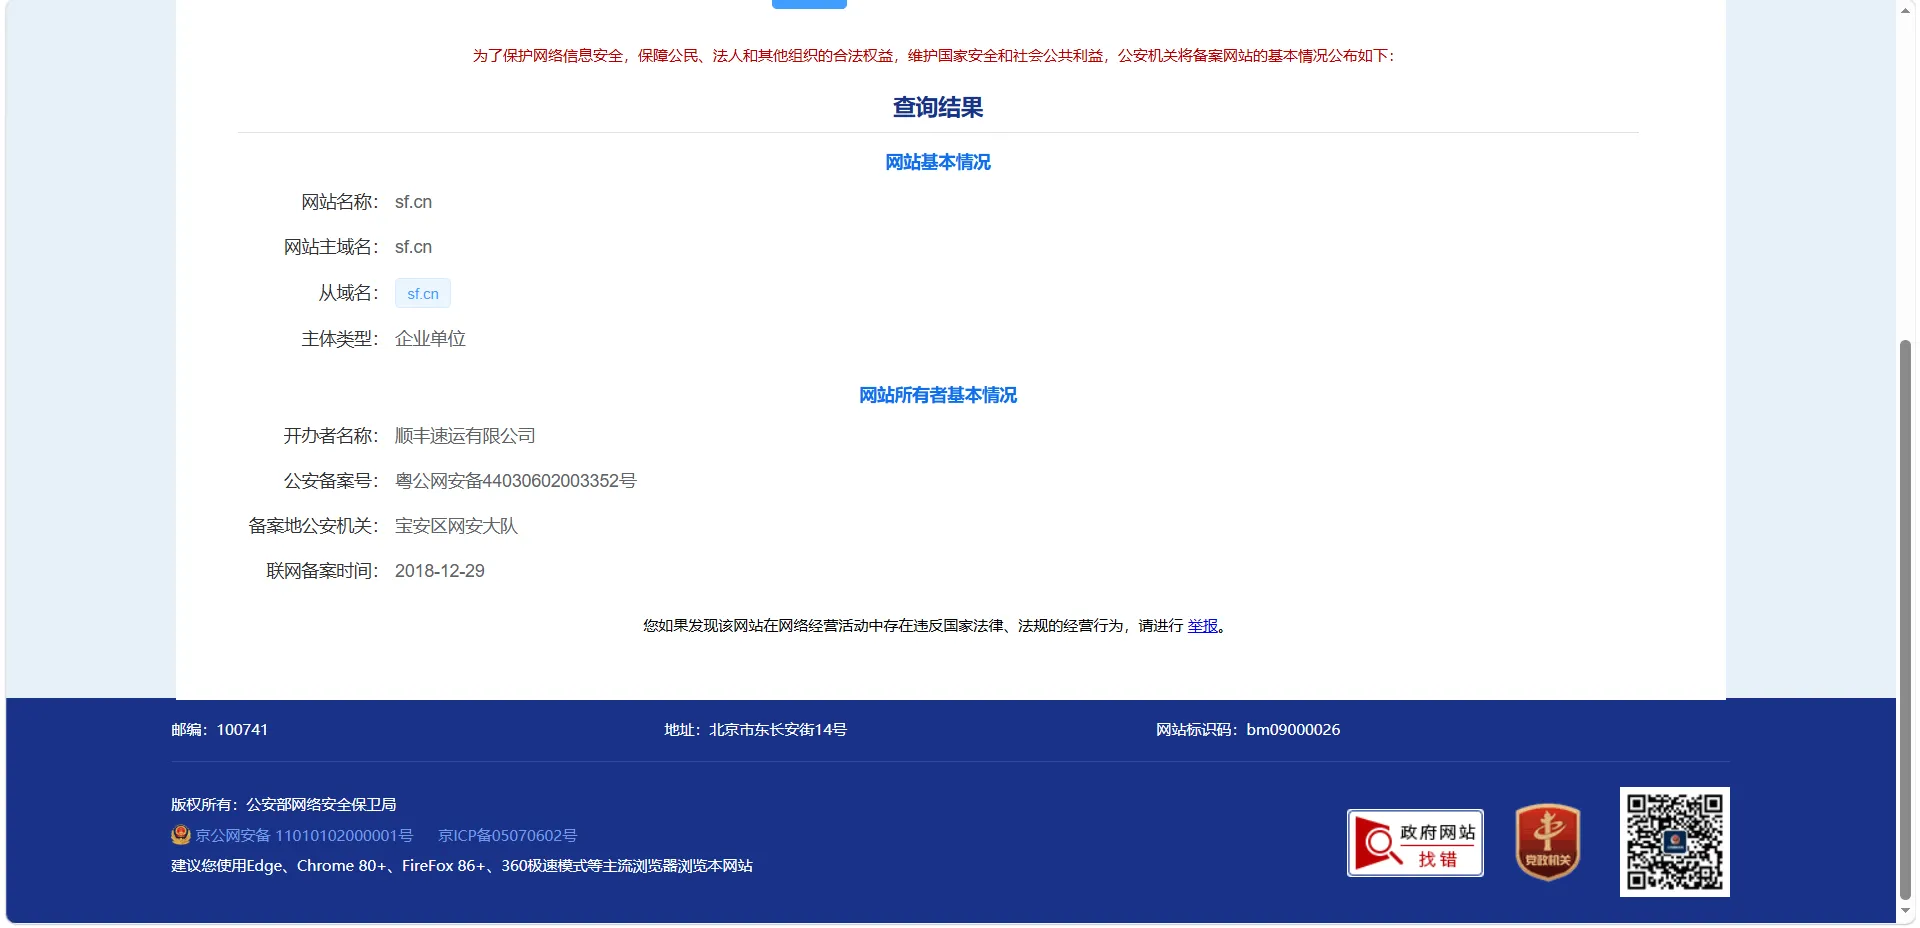
3.公安联网备案查询
打开公安部全国互联网安全管理服务平台公共查询https://beian.mps.gov.cn/#/query/webSearch ,输入上方提取的主域名查询,即可查询到该网站的网站所有者基本情况。
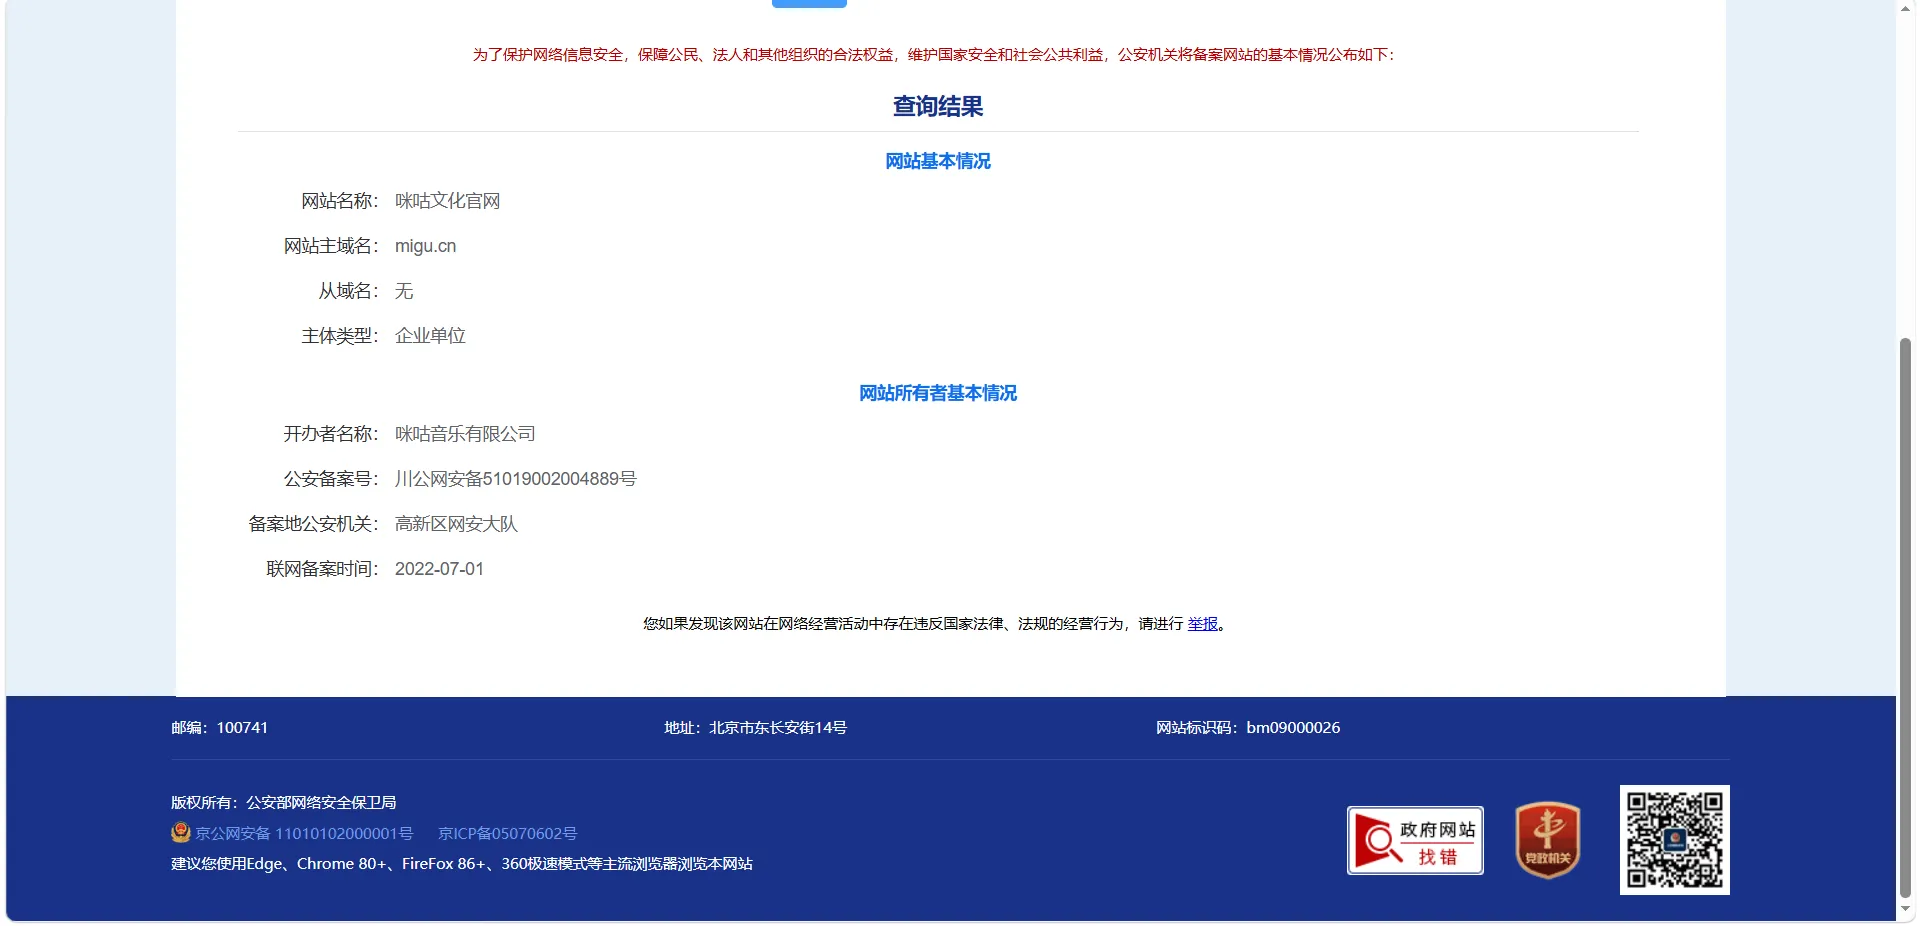
4.合理性判断
当我们已经查询到该网址的主办单位,这时候就需要进行合理性判断,例如这是一个外卖类的链接,但ICP/公安联网备案显示是一家建筑公司,又或者网页显示这是国内某家大厂的活动,但域名的ICP/公安联网备案的主办单位却是某省某市某县某镇某村的一家个体工商户,这时候就需要警觉了。判断技巧为网页内容与公司业务是否符合,网页显示任一的主办单位、承办单位、协办单位等与ICP/公安联网备案主办单位是否一致。
本来教程到这里就已经结束了,可能因为最近查询了很多这方面的资料和案例,导致一些平台也开始给我推送类似的内容,例如下图的分享。
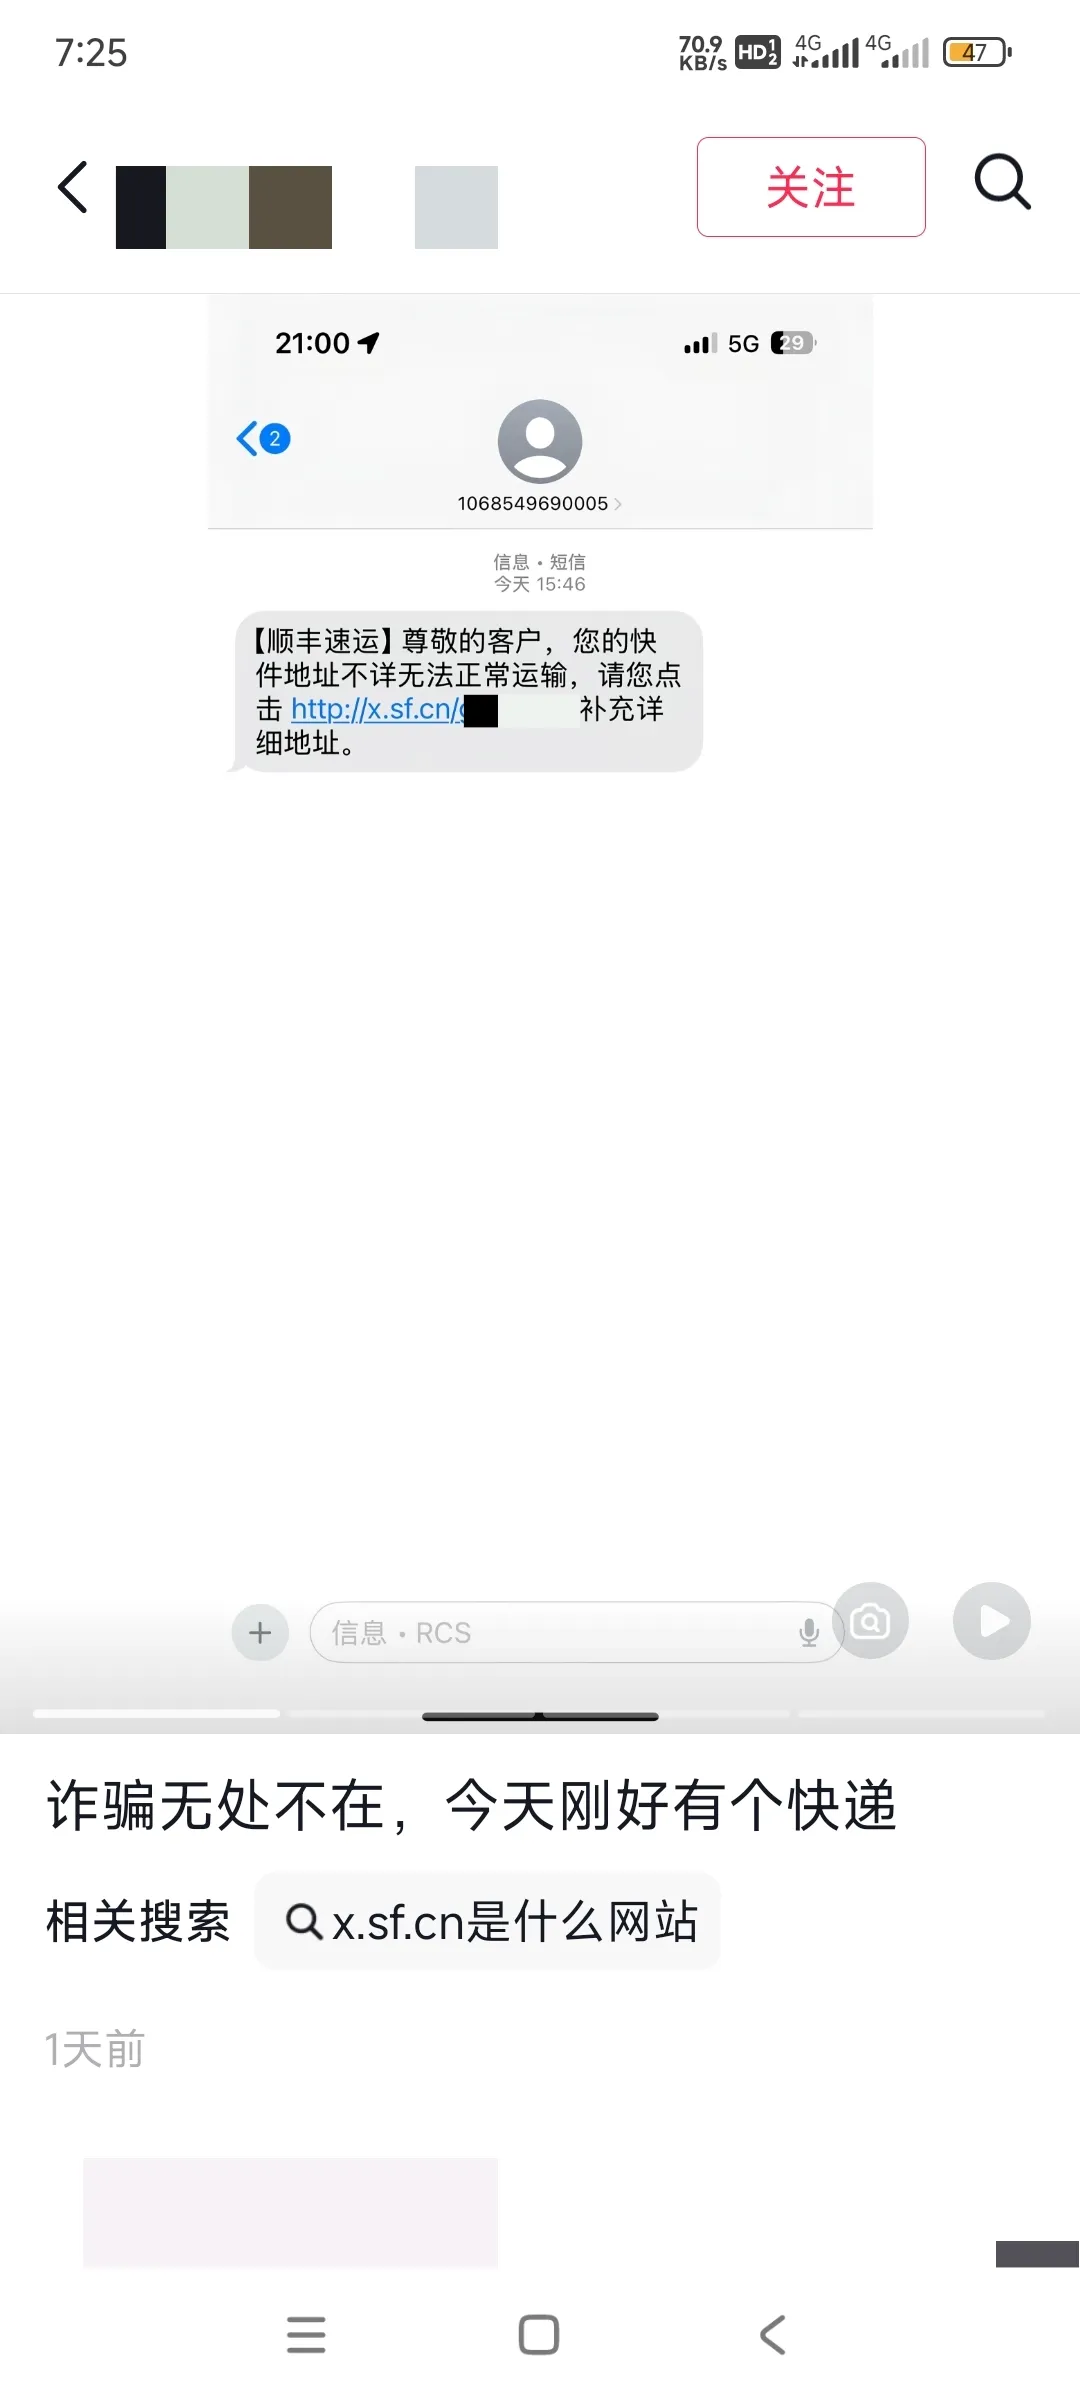
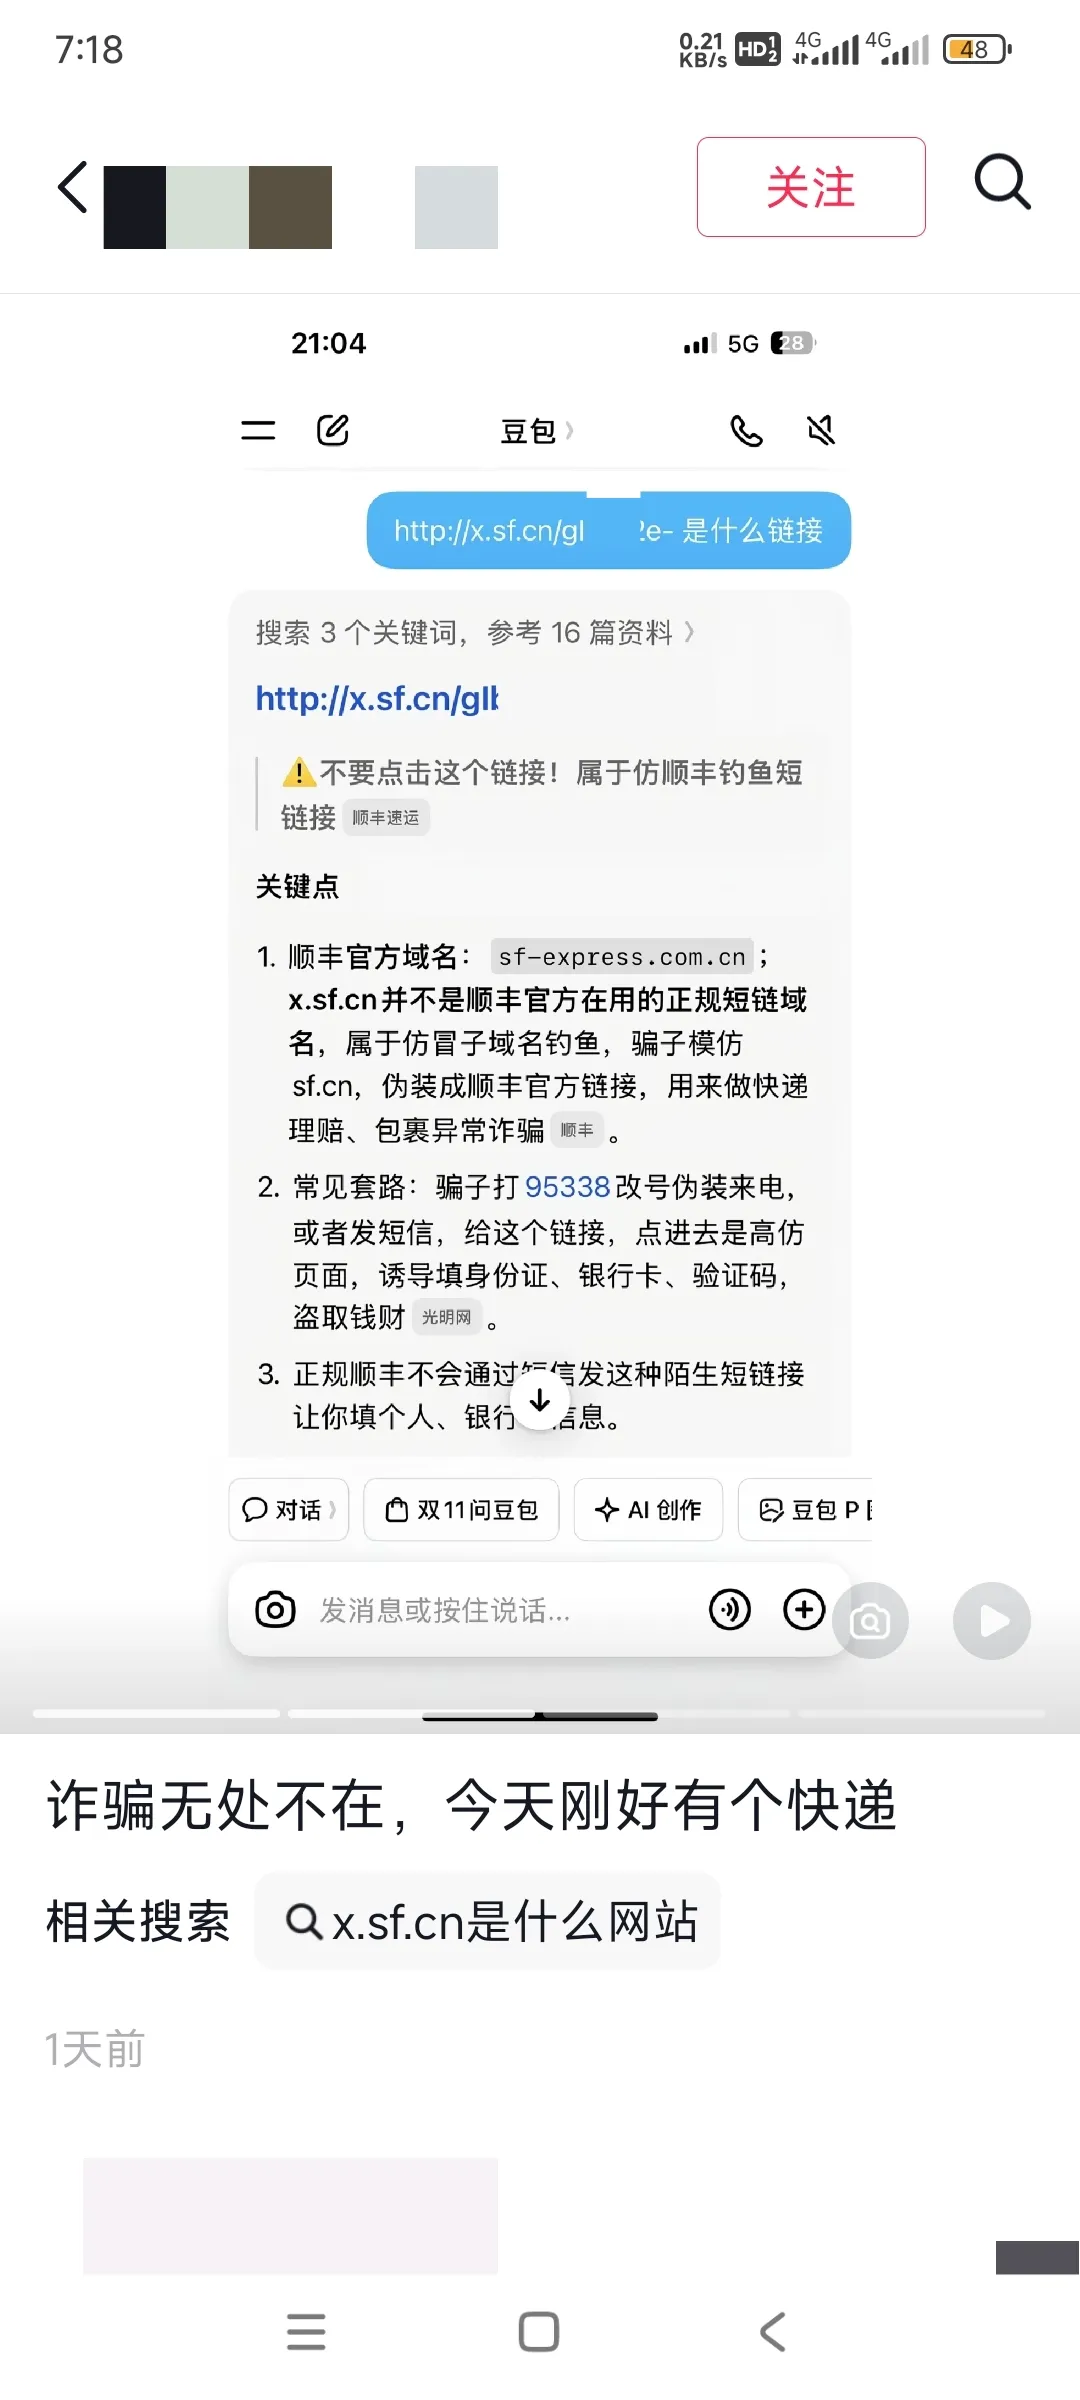
并且评论区还引发了不小的讨论,甚至还有相关的从业者现身说法,说这个网址有问题,公司正常流程不会这么处理。
这里面问题有点多,我们一个问题一个问题来说。首先就是网址问题,如果了解域名的人来说,在什么都不做的情况下,光看域名就知道它很难是个仿冒假冒“钓鱼”网站。因为这是一个两字母的cn域名,常见后缀的两字母域名价值极高,骗子如果用它来“钓鱼”,什么都还没做,几十万可能就已经花出去了(这还是保守估计,这类带品牌效应的域名溢价极高),但可能不到一天时间域名就会被封禁。
当然,上面只是个人经验,真正的排查还是得靠ICP/公安联网备案查询。
1.提取主域名
主域名是sf.cn。
2.通过工信部ICP备案系统查询
3.公安联网备案查询
4.合理性判断
短信内容是顺丰补充详细地址,域名主办单位/所有者是顺丰速运有限公司,短信内容与公司业务相符,虽然网页已无法打开,但仍可初步判断为顺丰正常业务链接,非仿冒假冒“钓鱼”网站。保险起见可联系顺丰客服进行进一步核实。
至此本教程完结。
2026-10-20 19:11:09
今天看到消息,说湖南移动的全民百G业务下架了,然后去核实了一下,当时好像还有部分渠道可以线上办理,资费专区的公示也还在,就没太在意,后来看到移动的公告信息,才确认这个业务彻底下架了。
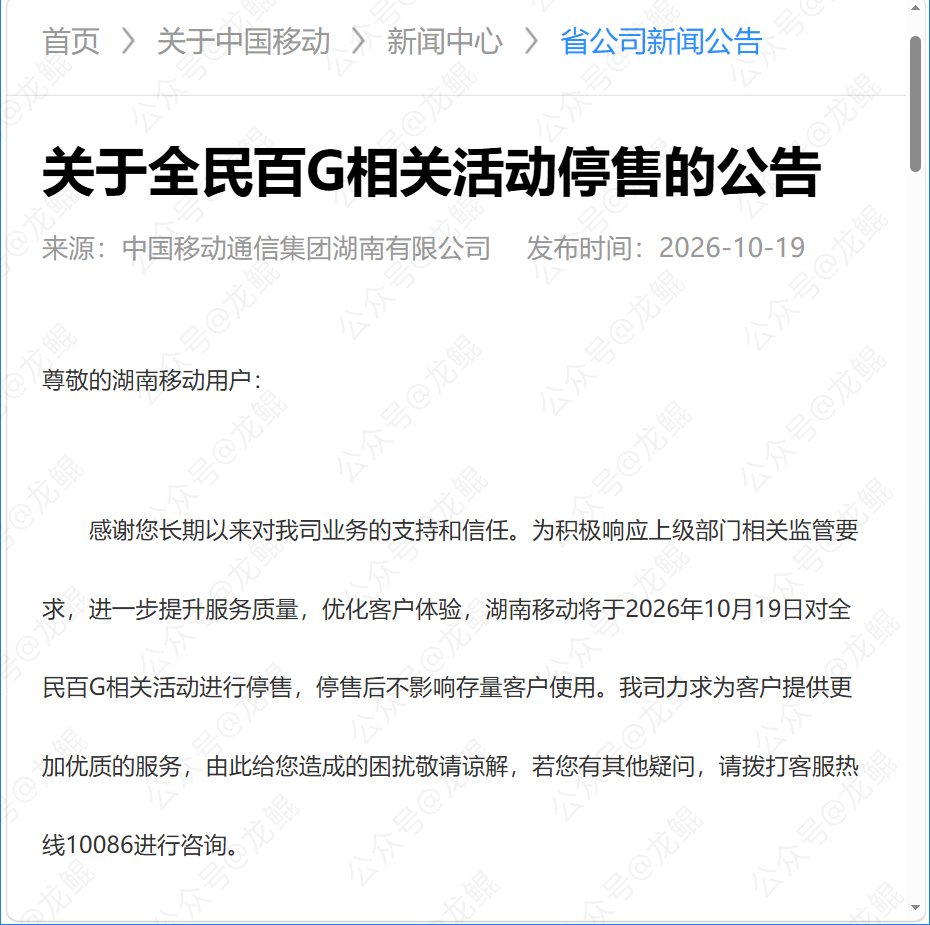
(公告链接:https://www.10086.cn/aboutus/news/pannounce/hn/index_731_746_detail_56014.html)
其实早在上个月,在互联网上就看到了类似的消息,说这个业务要下架,结果一直也没下架了,以为会按照公示信息延续到年底,结果今天就看到下架的消息,只能说参加活动要趁早,以免夜长梦多。
今天这个联通智家AI云套餐畅越版互联网上其实流传有一段时间了,只是一直没时间去写一个详细的评测,当时也就是互联网上浏览消息,说可以办理这么一个套餐,感觉性价比挺高的,于是就尝试了一下,确实是可以的,这里记录具体过程,以备日后查阅。
因为这个套餐有很多档位,本文主要评测的是99元档位(资费标准:99元/月),也是互联网流传比较广的一个档位,个人觉得也是这个套餐性价比比较高的一个档位。
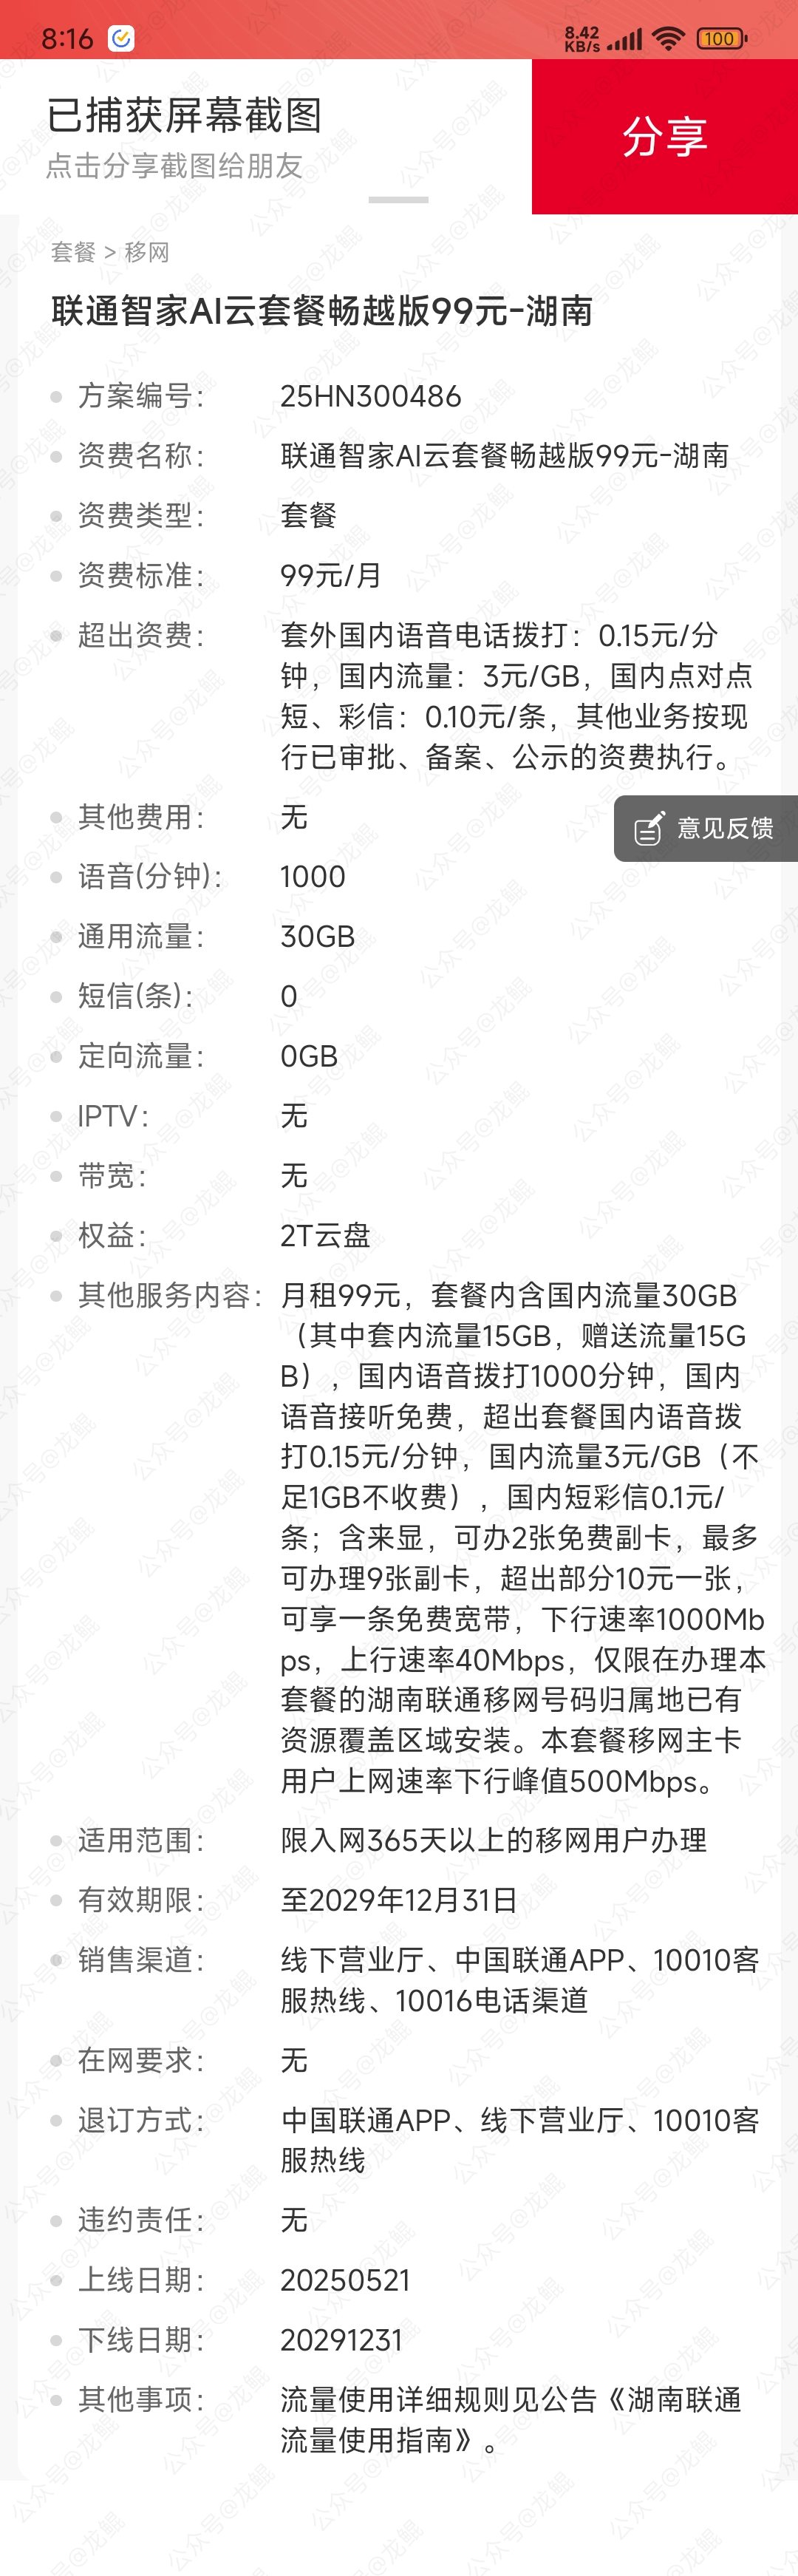
该套餐的名称全称叫:联通智家AI云套餐畅越版99元-湖南(方案编号:25HN300486)。
套餐内含有一条免费宽带,下行速率1000Mbps,也就是我们常说的千兆宽带。
99元档语音为1000分钟,通用流量为30GB,可免费办理2张副卡。
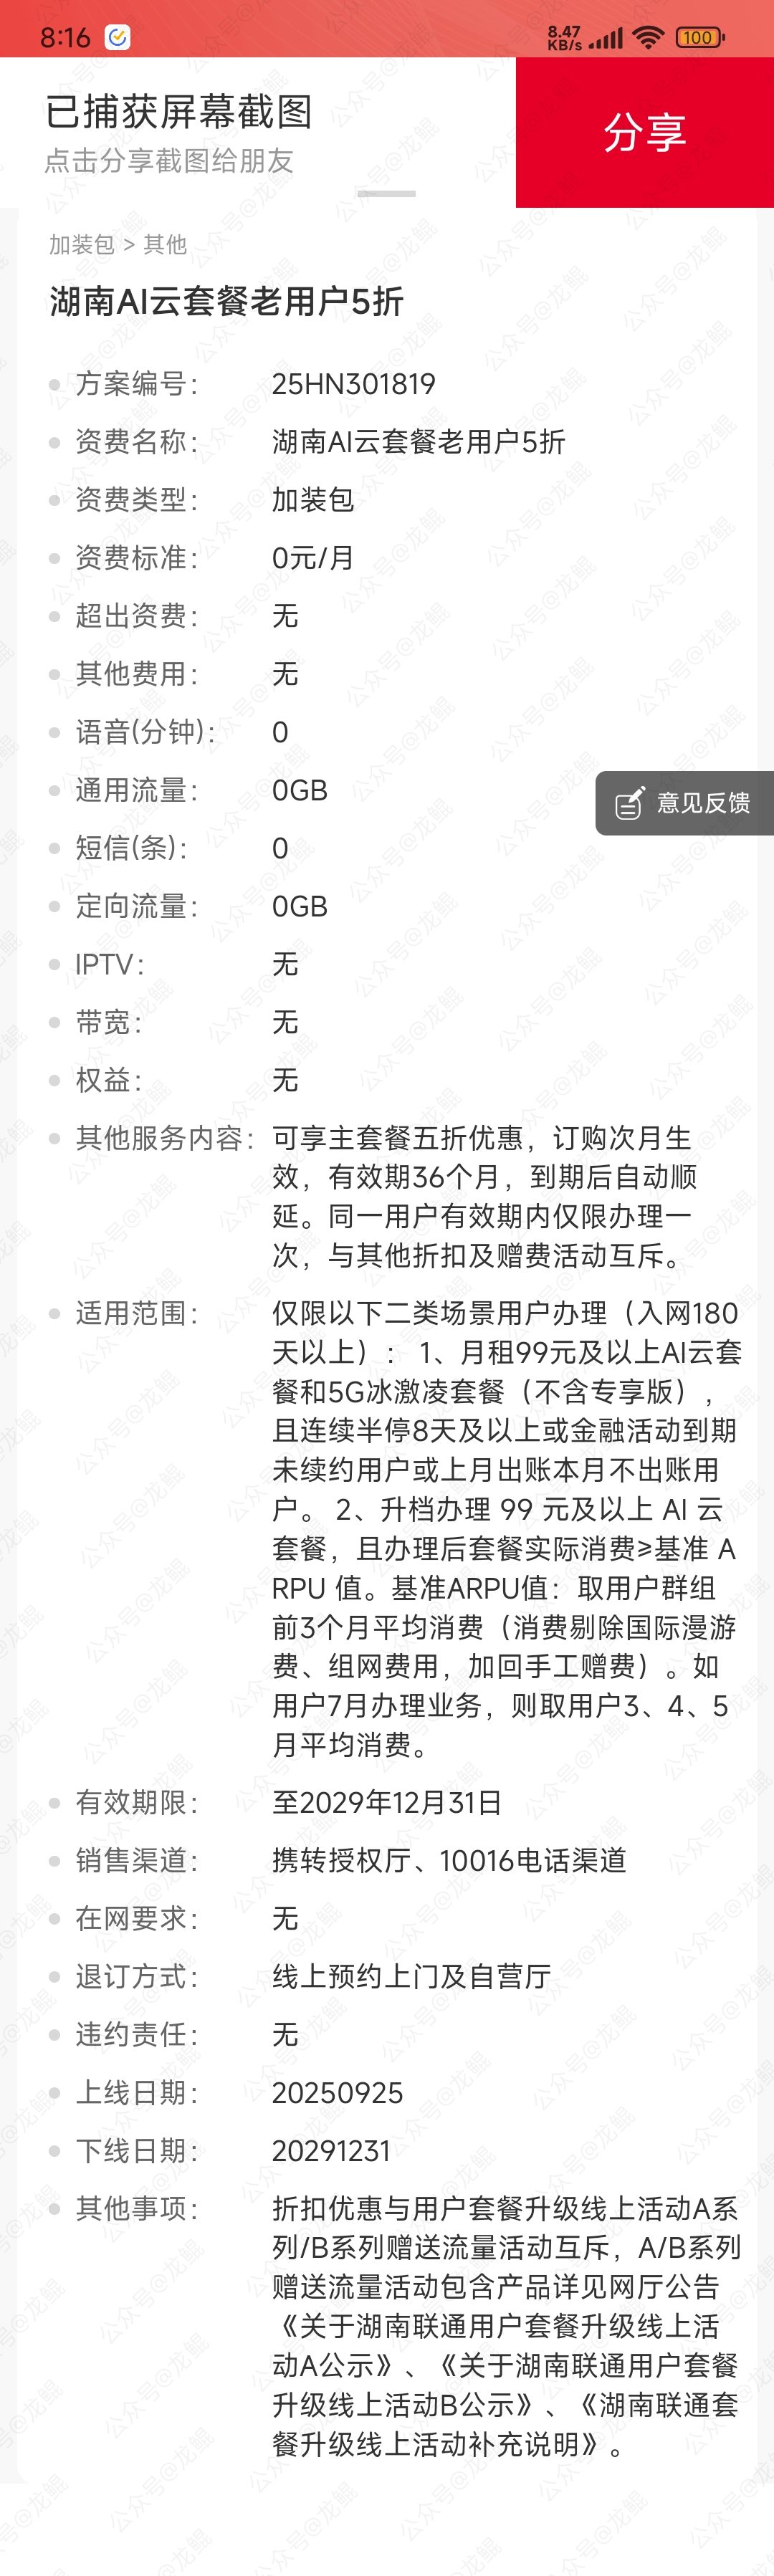
套餐原本资费为99元/月,办理湖南AI云套餐老用户5折优惠包后(方案编号:25HN301819),实付49.5元/月。
PS:资费专区也有新用户办理该套餐的优惠活动,具体自行联系官方客服了解,不清楚是否还能够参加。
安装使用该宽带前的准备:
1.查看是否为千兆光猫(光猫背面有具体型号,通过具体型号搜索即可)。
2.查看所有网线是否支持千兆宽带。
部分用户是通过光猫连接路由器,再从路由器连接电脑,这种情况会使用两根网线,任意一根网线不支持千兆宽带都无法跑满下行1000Mbps。简单的分辨技巧就是通过线身上的标识进行查看,例如CAT5 E、CAT6、CAT7和CAT8,这些都是支持千兆宽带的。
3.查看路由器是否支持千兆带宽(路由器背面有具体型号,通过具体型号搜索即可)。
PS:该宽带上行速率仅40Mbps,默认情况下有极大几率跑不满,如果发现下行达标的情况下,上行不达标,可以联系客服,让宽带维修师傅上门处理。
宽带安装地址的要求:
简单来说就是,一个长沙的号码办理了该套餐,那么该宽带就只能安装在长沙,并且是资源覆盖区域(一般都是)。
宽带安装之后的测速:
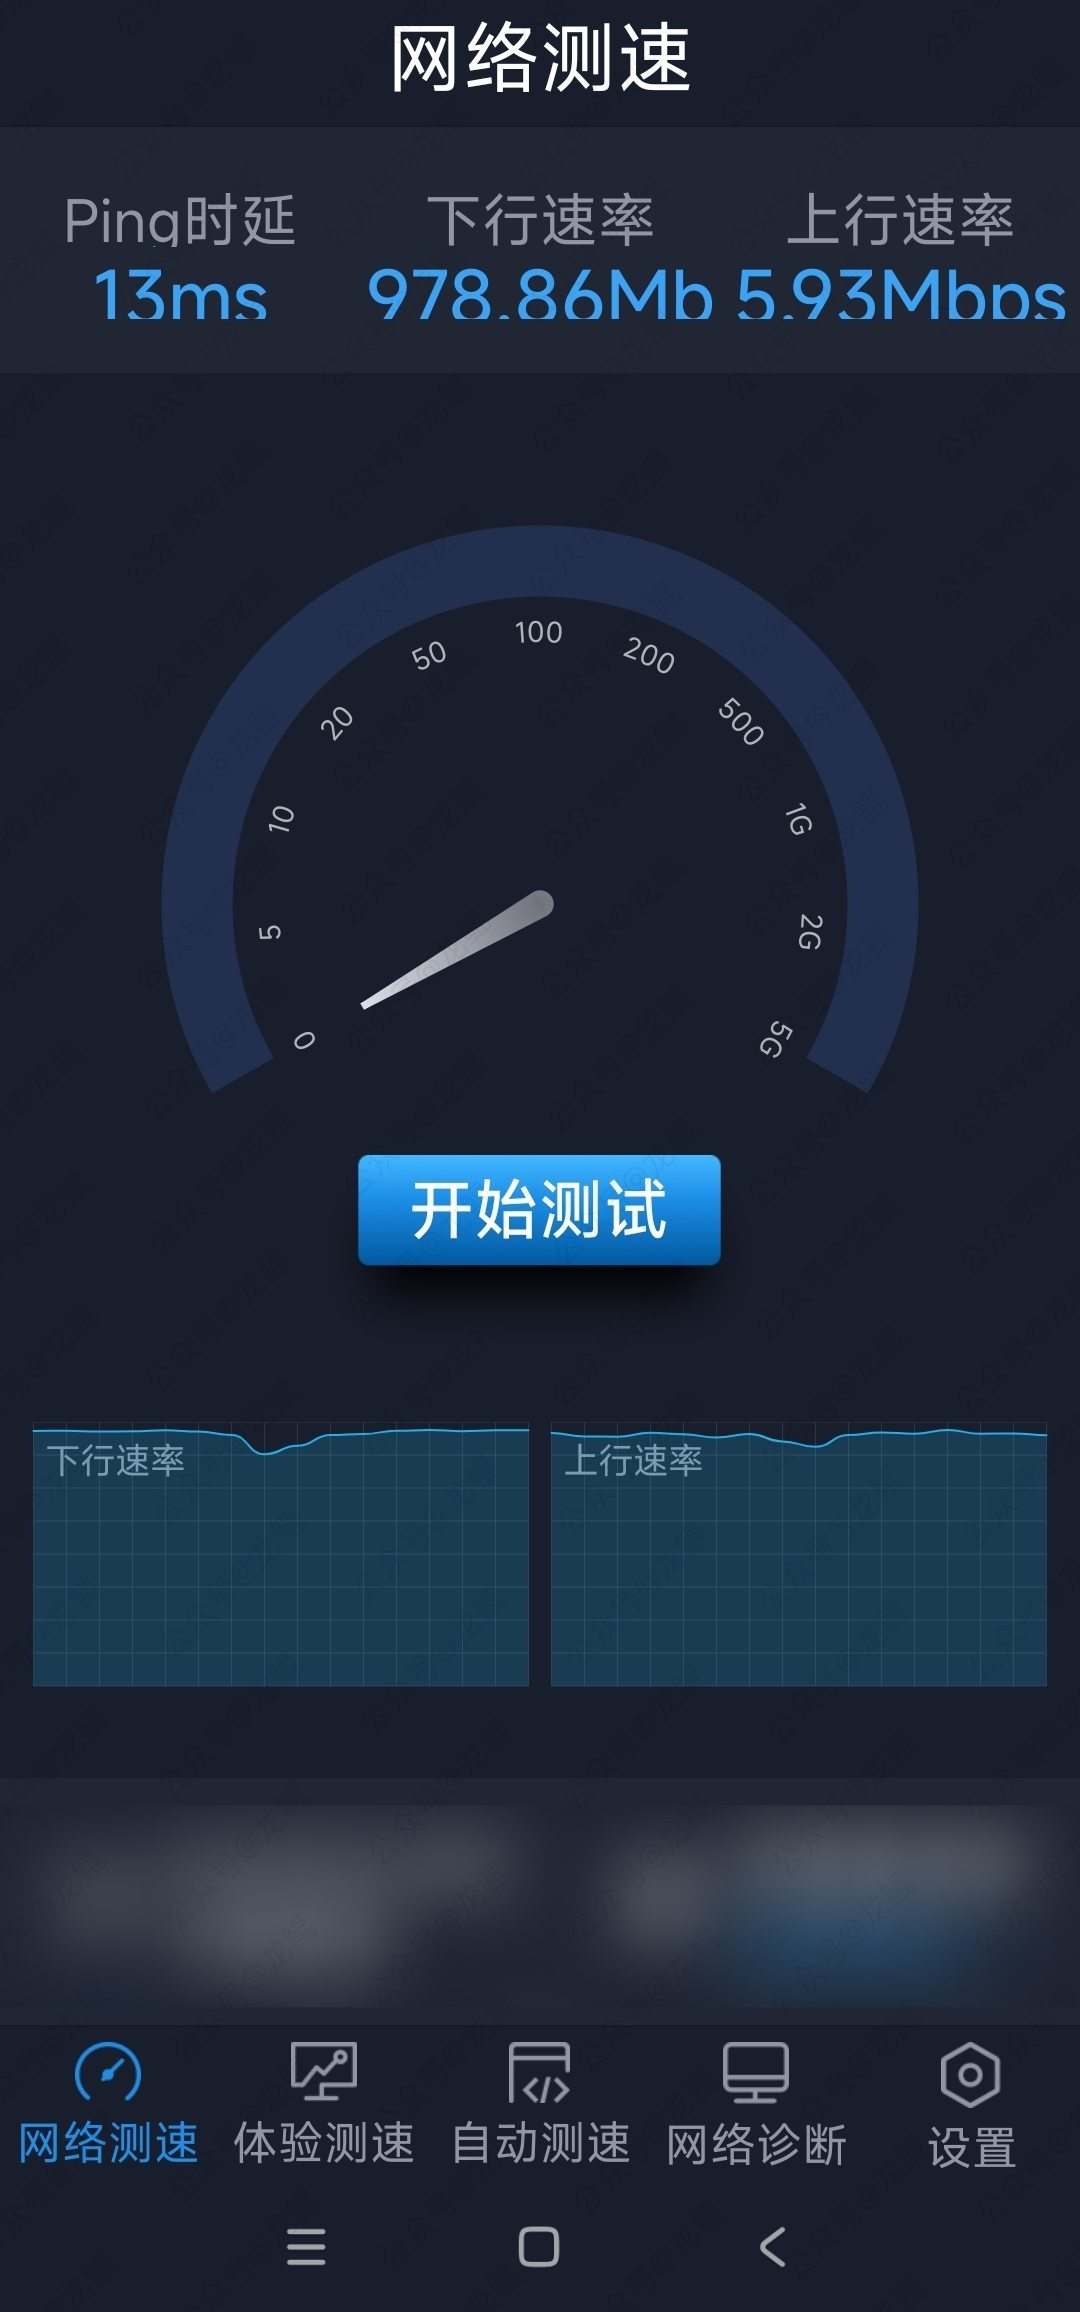
因为现在有测速需求的人越来越多,但测速的产品却不增反减,早年间运营商官方都提供网页端的测速功能,现在基本上找不到,根据我自己的实际测试,推荐测速的平台有:
测速网(https://www.speedtest.cn/):支持多端测试,但由于使用人数较多,千兆宽带高峰期基本跑不满。
全球网测APP(应用市场下载):中国信息通信研究院研发产品,仅支持APP端,实测WIFI 5G频段可以跑满千兆。
高校测速:这里以中国科学技术大学测速网站(https://test.ustc.edu.cn/)为主,类似的还有南京大学测速站(https://test.nju.edu.cn/)、南京航空航天大学测速网站(https://speed.nuaa.edu.cn/)等,实测也很难跑满。
至于其他的,网页端还有SPEEDTEST(没有国内节点,很不稳定),speedtest.im(没有自己的测速节点,容易弹下载链接),APP端还有花瓣测速(非华为手机无法直接安装),基本都很难稳定跑满千兆。
除了专门的测速工具,其实还可以变相测出峰值网速,就是开启设备网速显示后,通过下载大文件(游戏、视频等)来测试此时的最高网速,一个大文件跑不满,同时多下载几个大文件,一个平台跑不满,多用几个平台,毕竟带宽的网速还是要应用在体验上的,这样也会更加直观。
已安装宽带注意事项:
若主卡下本身已安装宽带,记得在新套餐生效后在中国联通APP查看宽带速率是否更新,若未更新记得联系官方客服处理。
套餐内每月含有1000分钟语音通话,主副卡共享。这个语音不算多,但在折后这个价位也不算少,如果没有特殊需要,一般家庭都是够用的。即使超出,套外国内语音电话拨打也只需要0.15元/分钟 。
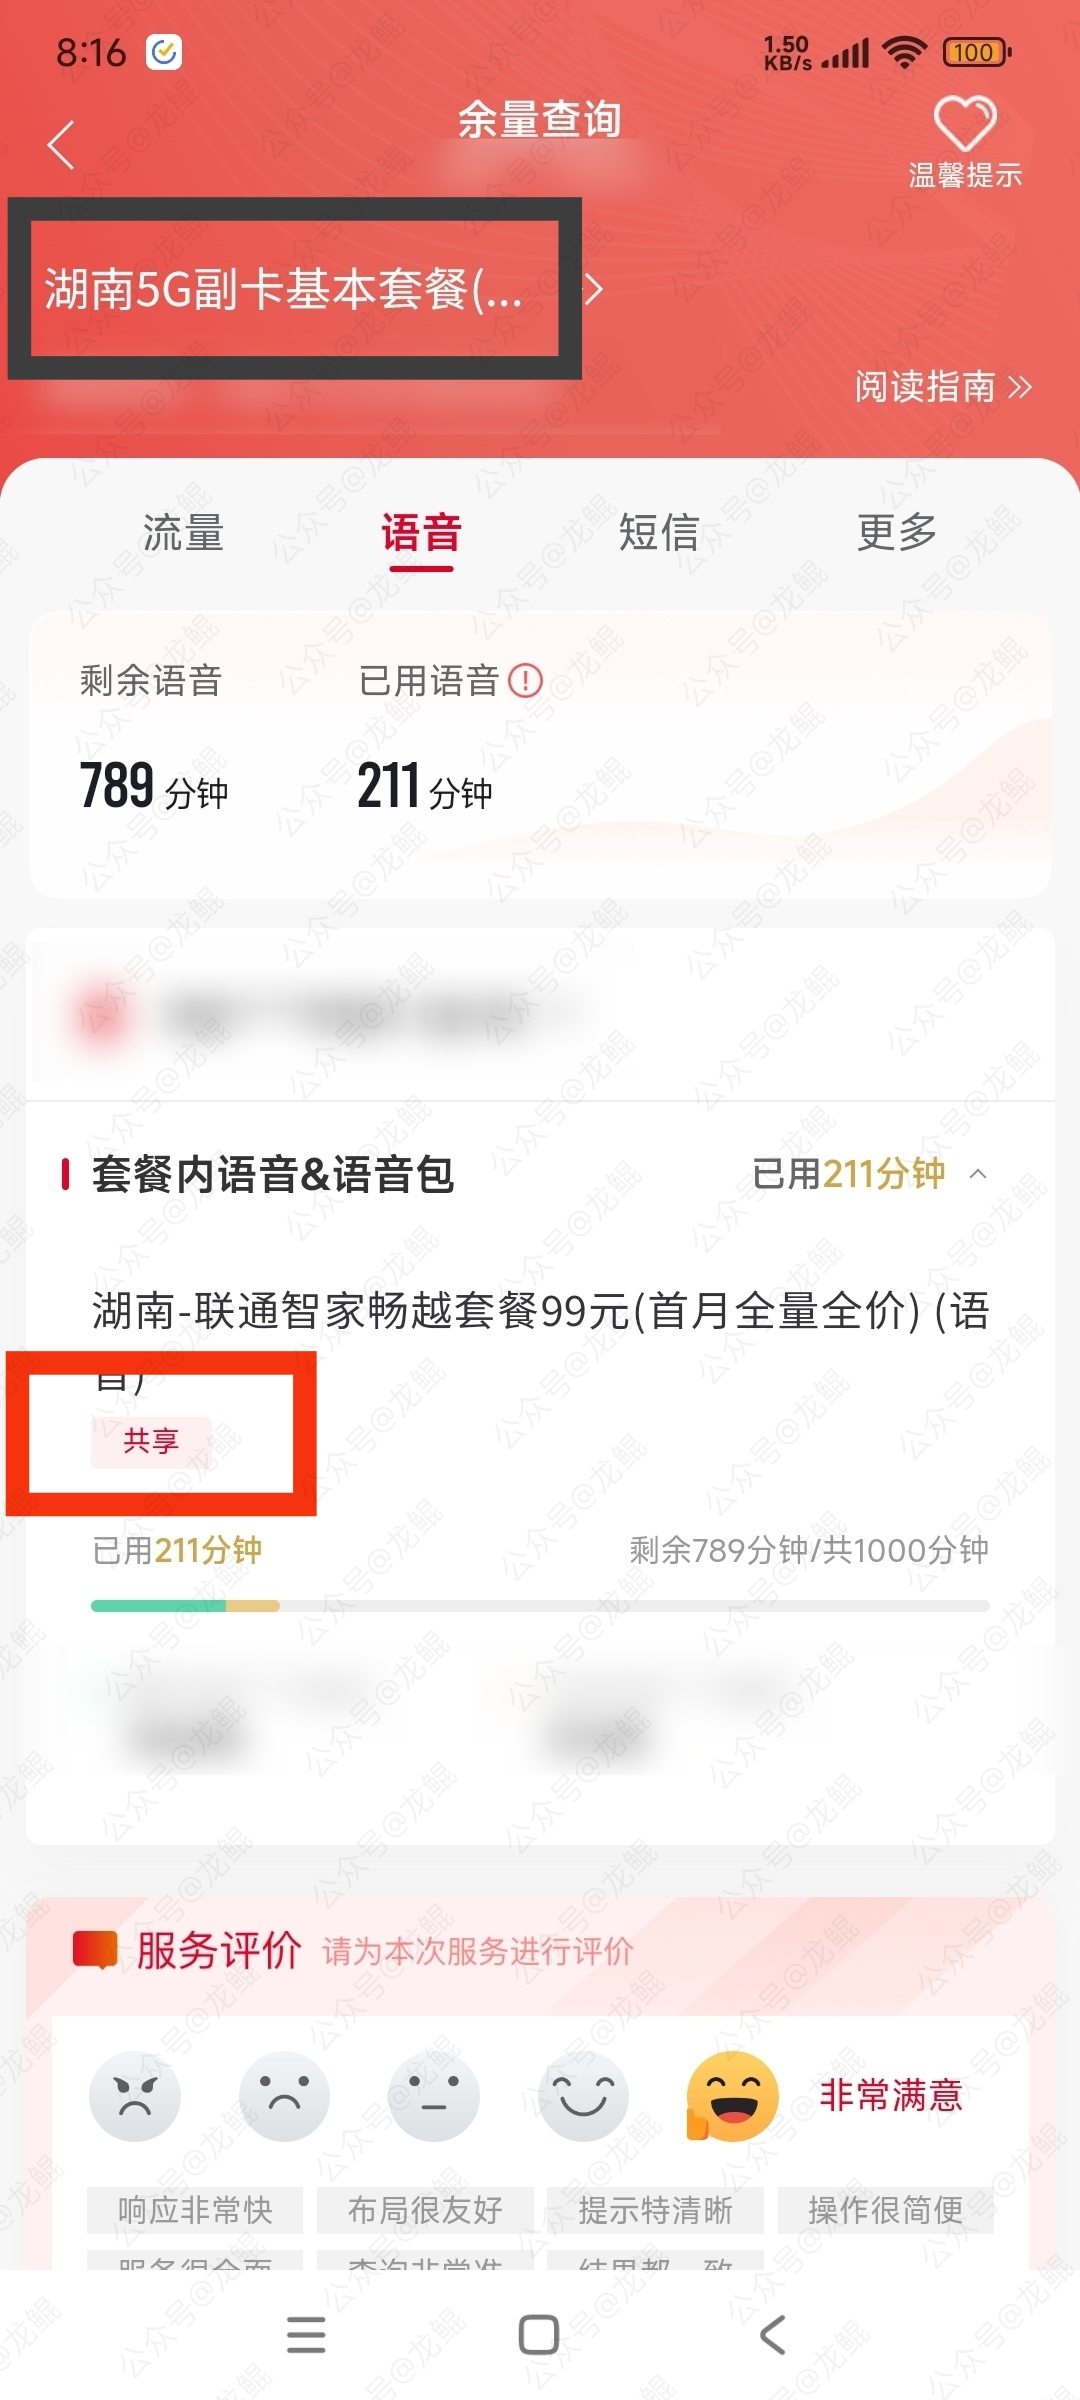
这算是这个套餐唯一的短板,其中套内流量15GB,赠送流量15GB,共两个包,主副卡均可共享,超出后国内流量3元/GB。目前没看出分成两个包的意义在哪,可能涉及结转或者流量使用优先级等问题,但使用这个套餐的人应该是没有太多流量需求的,不然会比较的不划算。
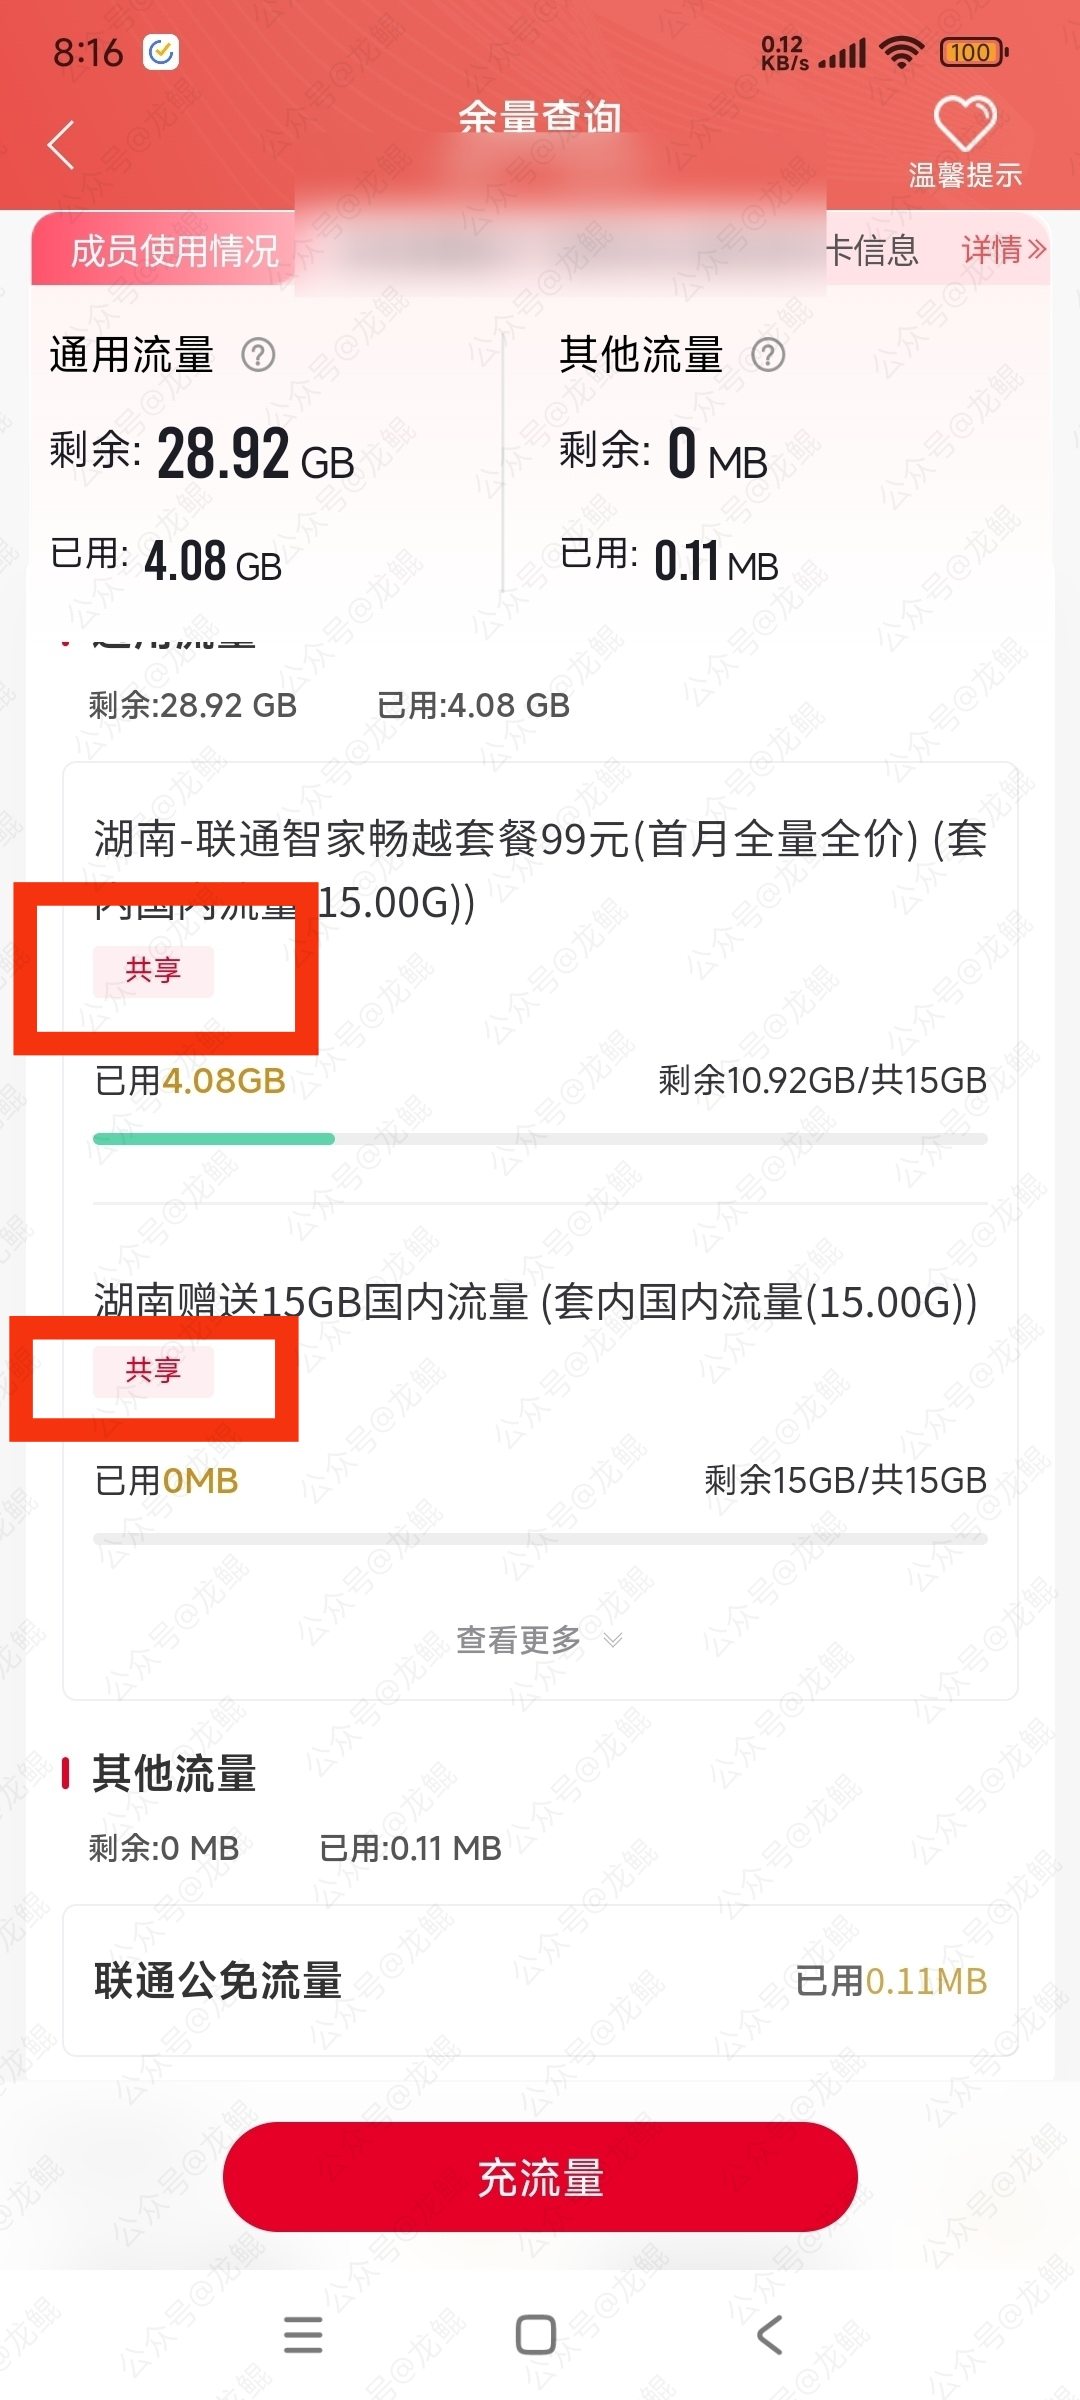
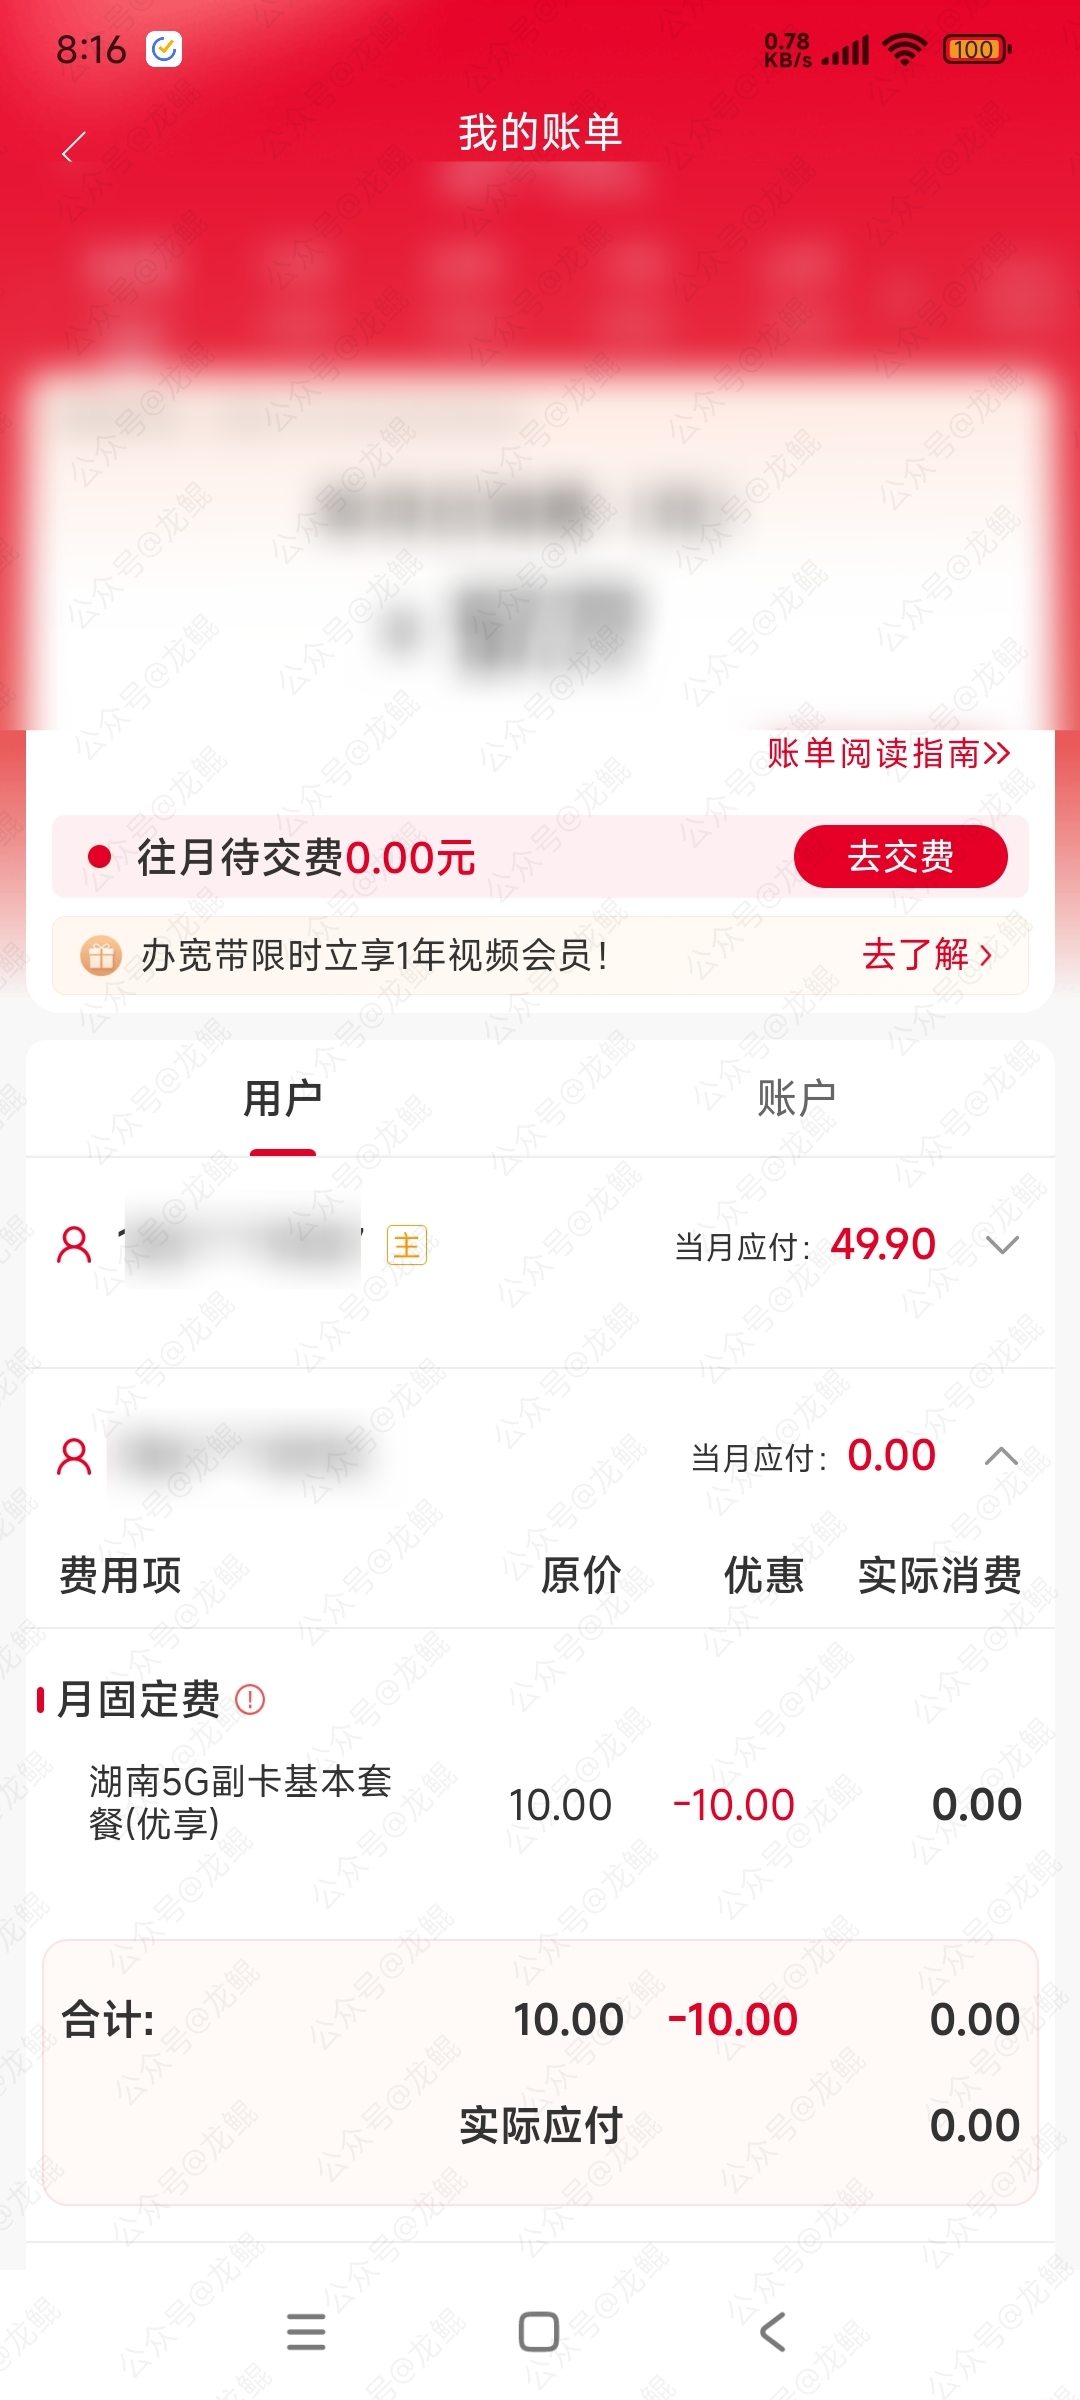
套餐自动减免2张副卡费用,联通正常一张副卡的费用在10元/月,而这个套餐可以自动减免两张副卡的费用,本身套餐折后就只要49.5元,减免两张副卡后,折算下来的费用就非常的低了。
PS:如果原有主卡下就有一张副卡,更换为该套餐后,原有副卡费用会自动减免。如果家人(非同一实名)有联通套餐,可以在更换套餐时一并纳入副卡,既减免了基本套餐费用,也可以共享主卡通话和流量。
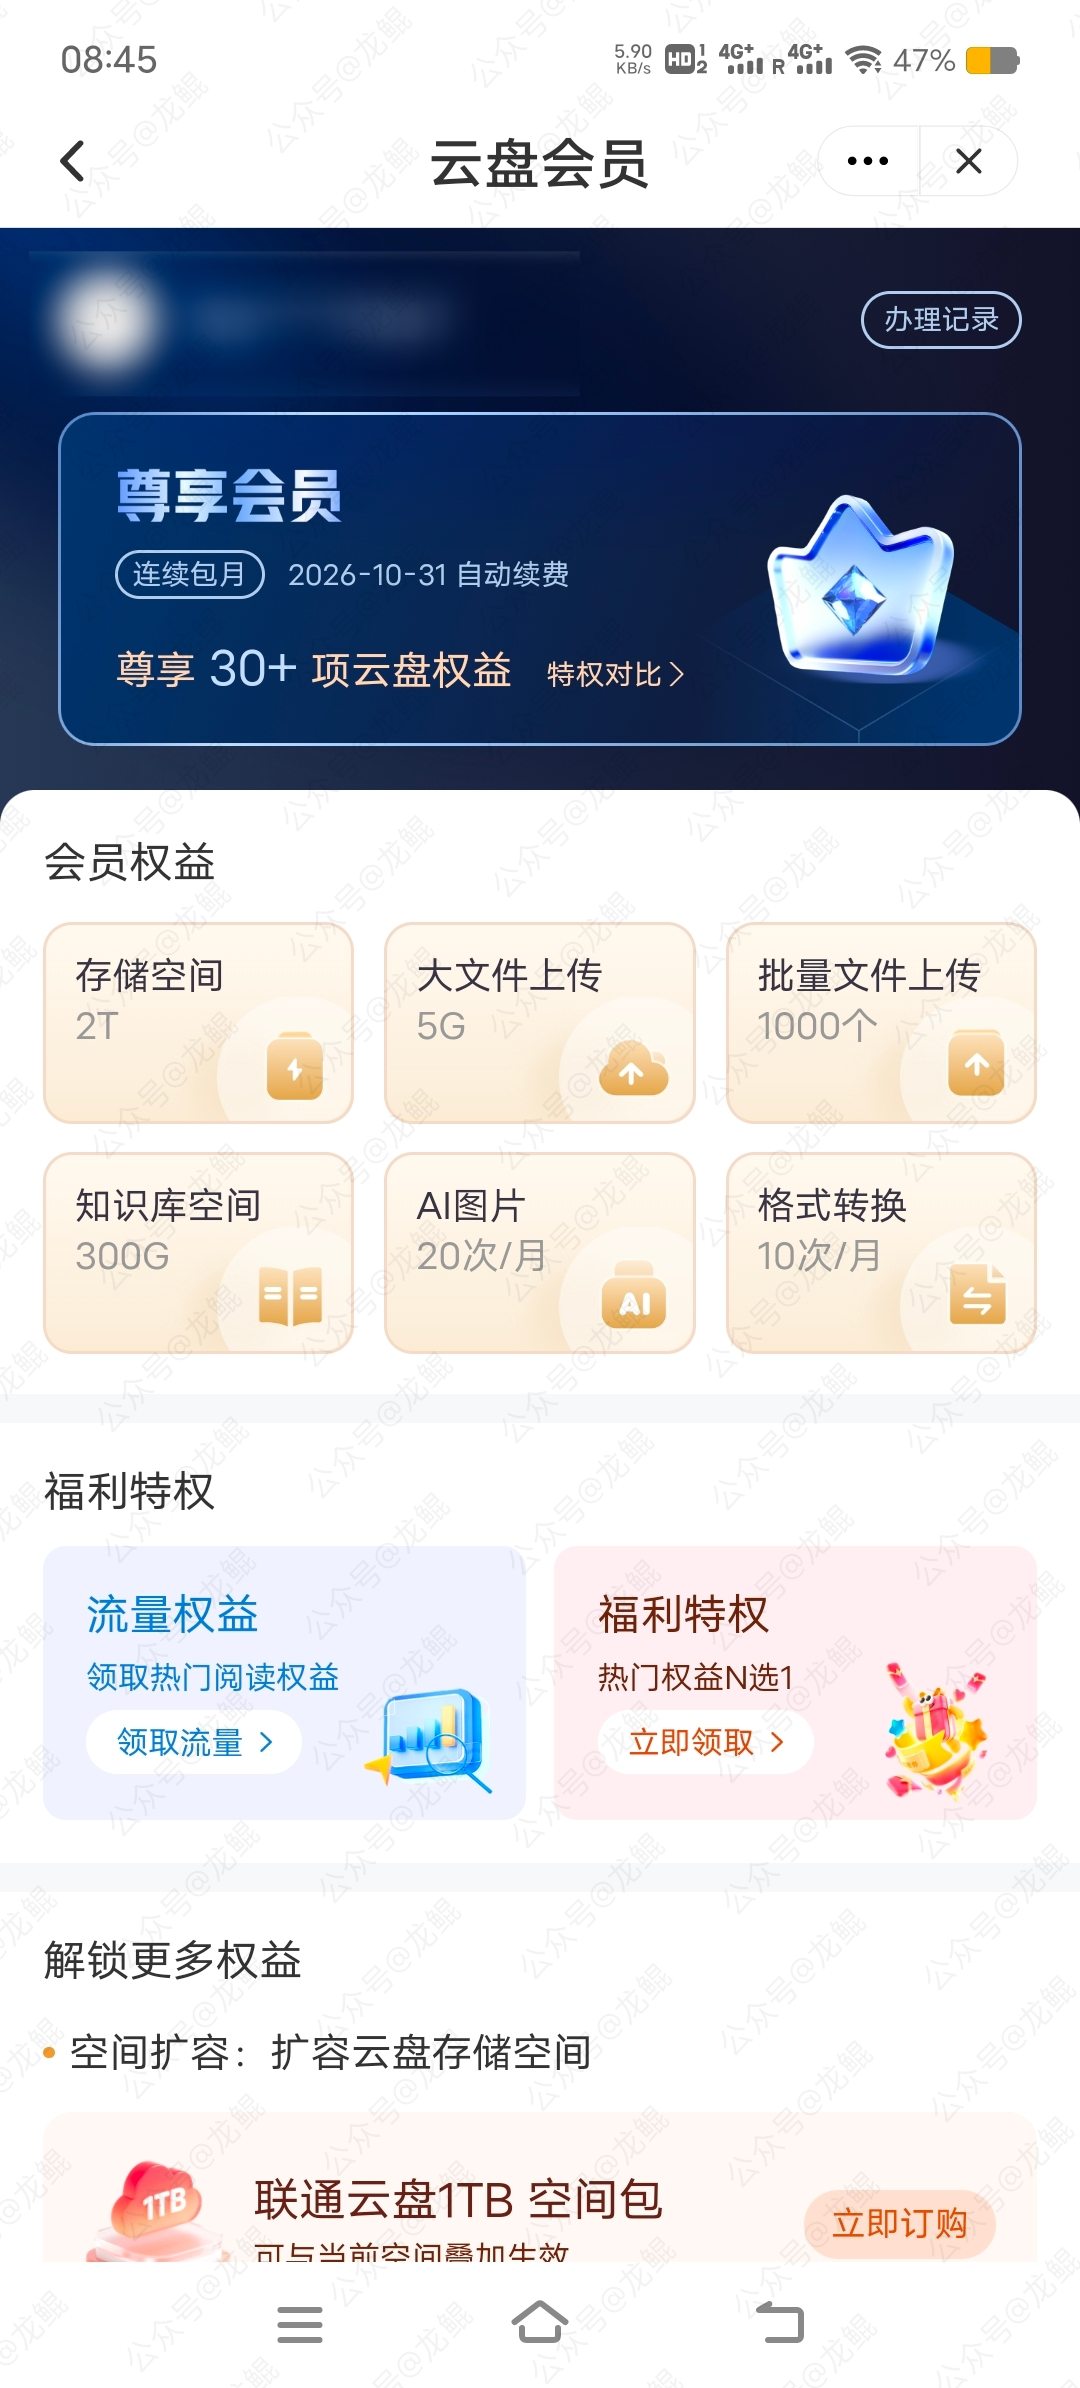
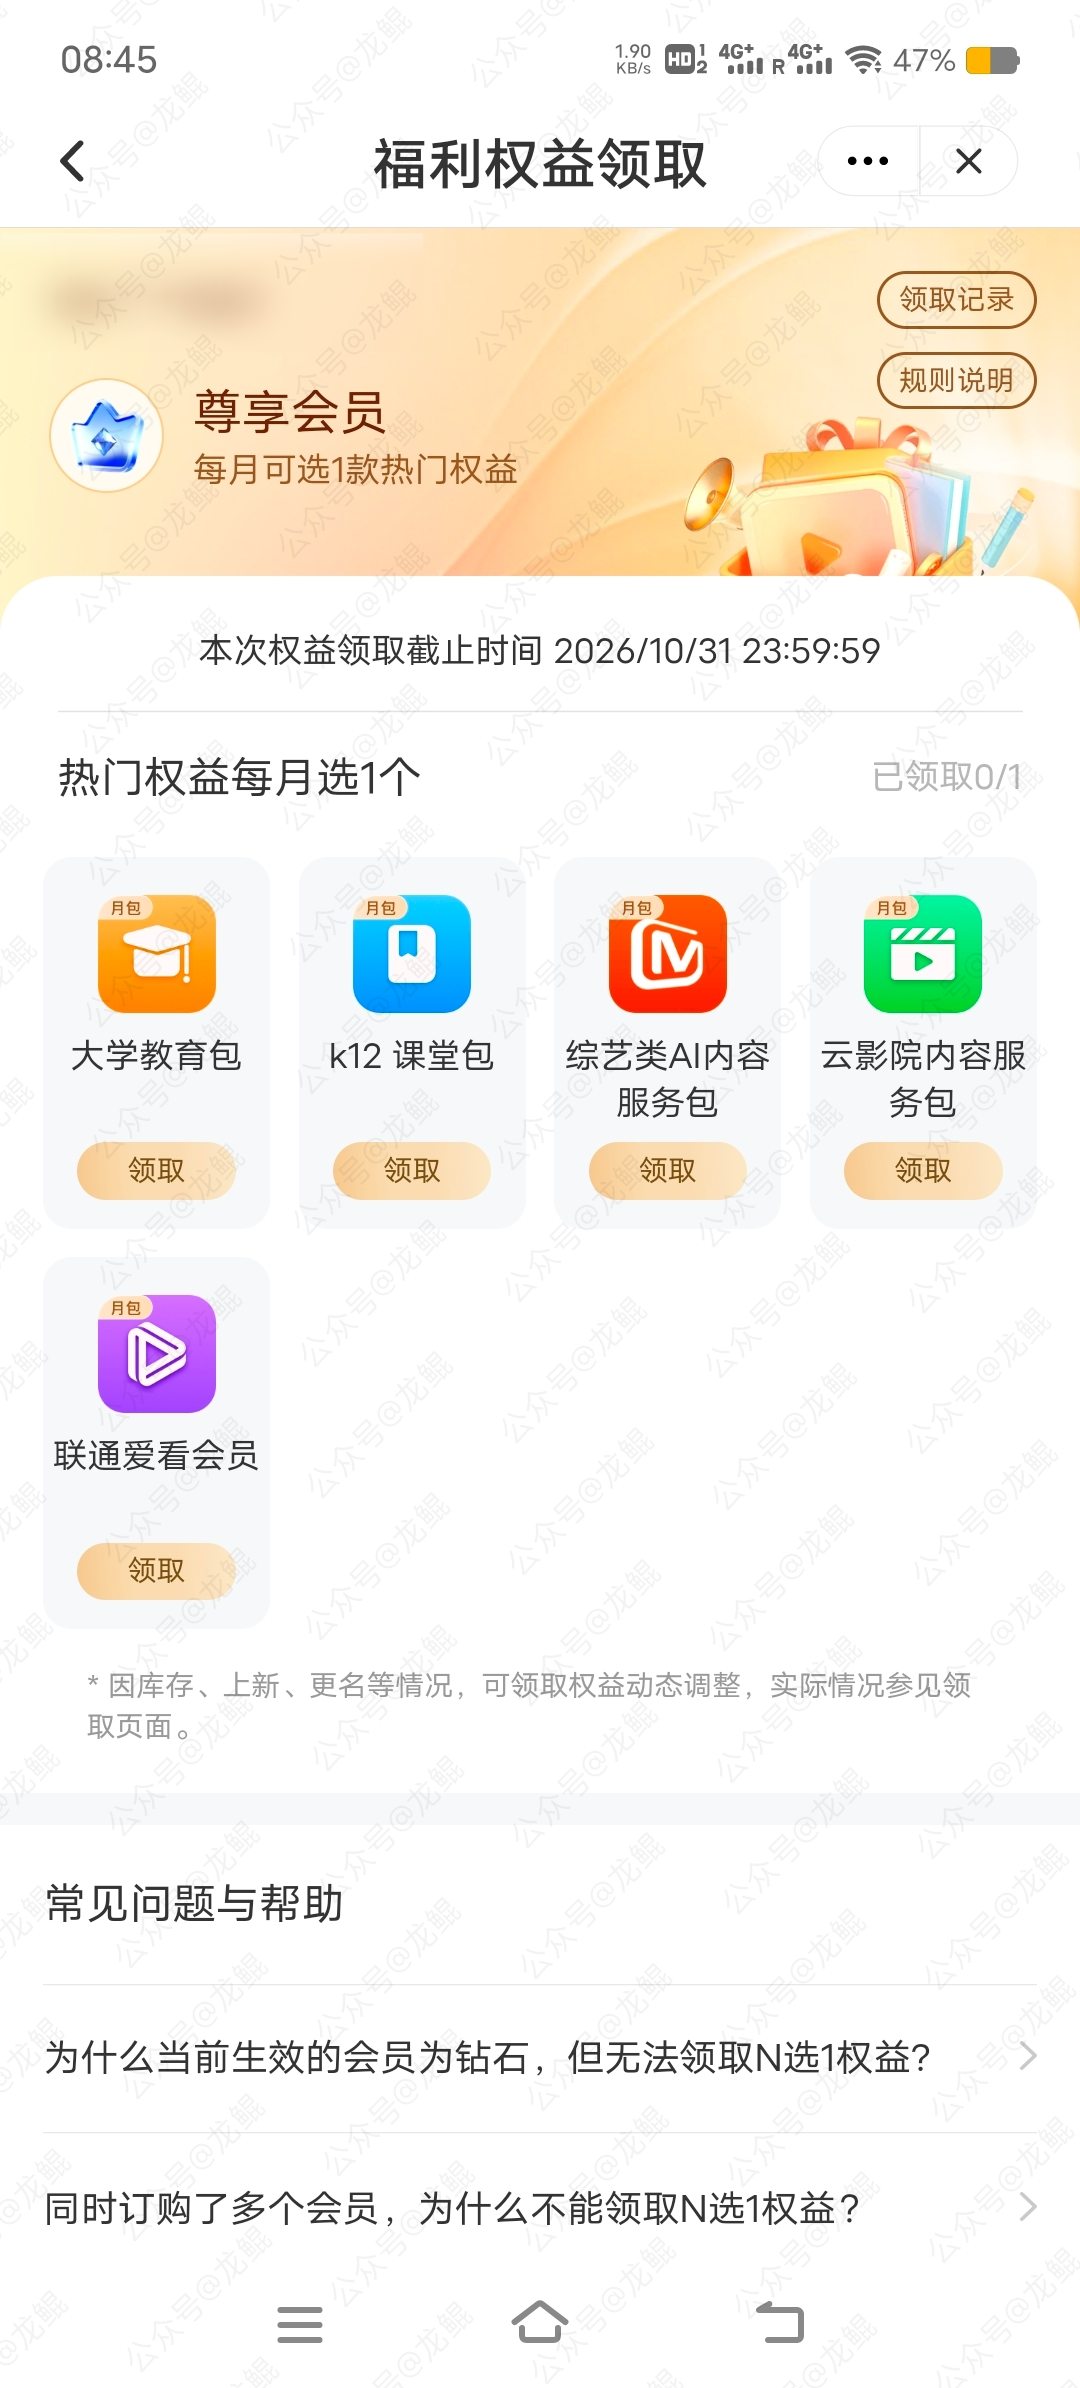
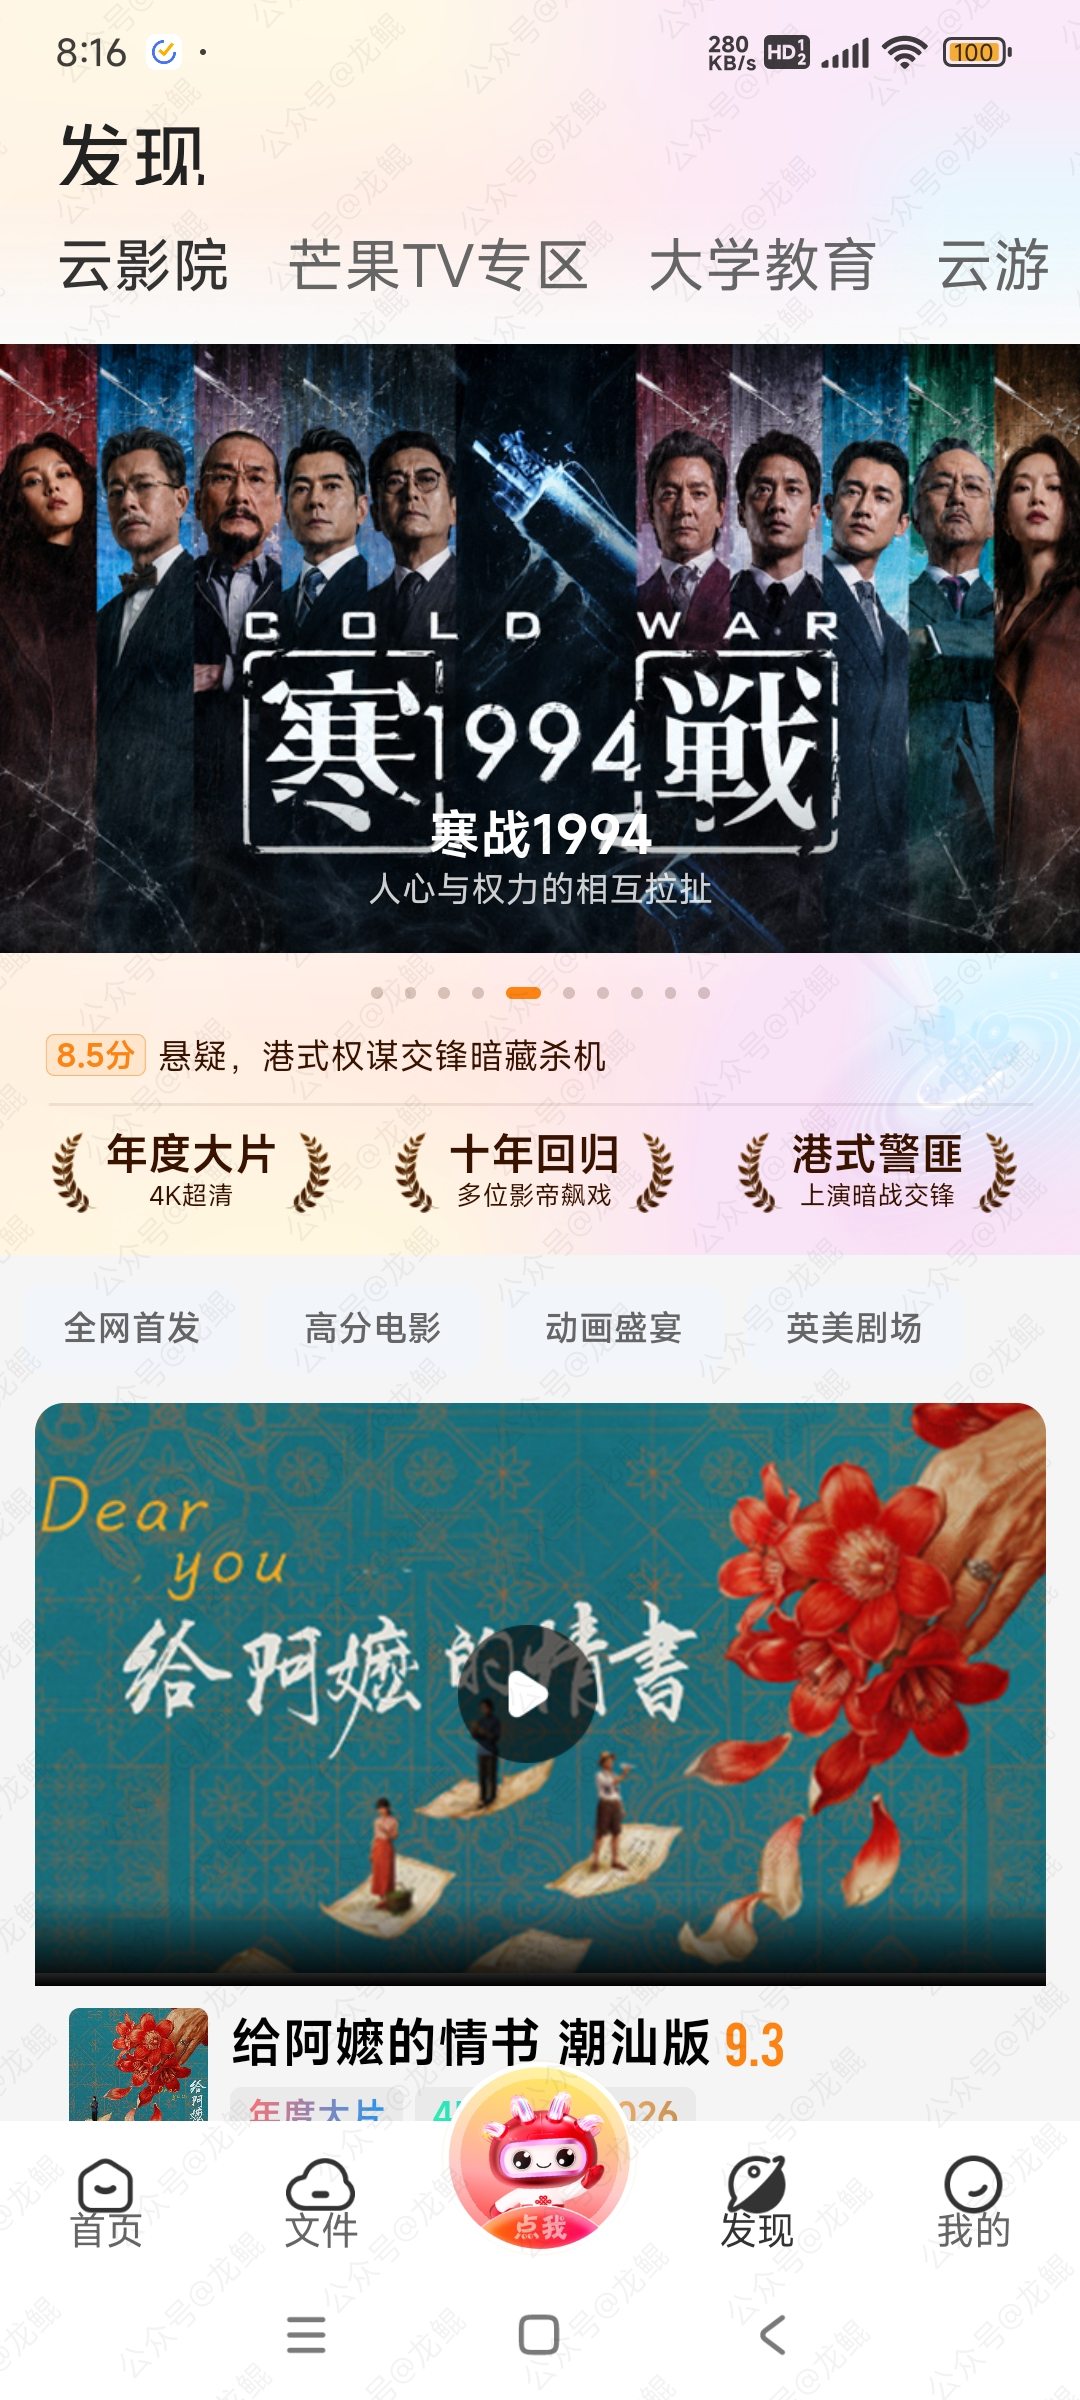
套餐自带2T联通云盘,上传下载均不限速,实际测试下来送的是联通云盘尊享会员,官方资费是10元/月,而且不同于活动赠送的联通云盘会员,这个属于营业厅订购的云盘会员,可以额外领一个热门权益N选1,热门权益大部分都是定制过的内容,和原版会有些出入,例如云影院功能,它的影片资源是由5G宽视界提供,虽然不能搜索,但它提供最近几个月热门影片的正版资源和很多高分的影片,个人感觉比那种放N年前影视资源的权益要好很多。
办理其实没有太多技巧,就是打联通客服电话或者联系在线客服,说自己要办理联通智家AI云套餐畅越版99元,还有5折优惠包,这时候在线客服一般会帮你反馈专员,电话客服会说自己最高权限只有多少折,你继续表示你要办理5折优惠包,她就会帮你反馈给专员,然后等待专员回电即可,如果回电专员仍然无法支持你的诉求,就要求联系携转专员。
这个套餐和折扣优惠包的出现有一段时间了,互联网上有很多办理成功的分享贴,加上最近湖南移动的全民百G活动,以及湖南电信星卡40G流量包的加持,基本上没有太大难度,毕竟它的短板也很明显,就是流量非常少,当然你可能会看到本套餐+折扣优惠包带流量包和权益包的截图,但那个目前是办理不了的,基本可以不用尝试。
个人觉得这个套餐方案目前还是比较有性价比的,特别适合家里有老人,对流量要求没那么高的用户,虽然流量少,但是也有30GB,偶尔出门应急绰绰有余,不至于一用流量就扣话费,如果对流量有需求,可以适当增加档位,看联通客服是否有相应流量包添加,但即使有流量也不会太多,加上还有两张副卡,流量需求高的情况下,该套餐方案不适合,另外该套餐方案没有合约限制,套餐和优惠都是长期有效。
2026-10-16 16:51:43
接触Ai之后,频繁看到Skill这个词,但每次都是浅尝辄止,稍微了解了一下就没深入了,这次趁着2026华为开发者大赛·小红书Skill创新赛,详细了解了一下Skill是什么,并且编写了自己的第一个Skill,这里记录详细的开发过程,以备日后查阅。
目前主要获取信息的渠道还是搜索引擎,但由于搜索引擎的权重等问题,有时候即使提炼关键词后,搜索的结果仍然不尽人意,需要查找许久才能找到需要的信息,这时候如果搜索的是政务类、教育类的信息,会使用搜索语法来限制搜索范围,但使用搜索语法每次都要手动输入语法,并且人为进行筛选,效率比较的低,需要编写一个Skill,代替人为筛选网页。
在我国互联网域名体系下,根据不同的用途,在.CN域名下设置专门的二级域名,例如政府机构GOV、教育机构EDU、科研机构AC。此时通过通用搜索语法,限制在该二级域名下搜索,就能保证搜索到的网页权威可靠。例如:关键词 site:gov.cn,则代表在所有政务类的网页中进行查找;关键词 site:edu.cn,则表示在所有教育机构(仅限使用edu.cn域名的教育机构,极少教育机构未使用该域名)的网页中进行搜索。
有了需求和手动实现流程的原理,我们通过华为云码道智能体 https://codearts.huaweicloud.com/ 发送我想编写一个Skill,这时就会进入Skill开发流程,根据智能体的提问进行回答,就可以一键进行开发了。
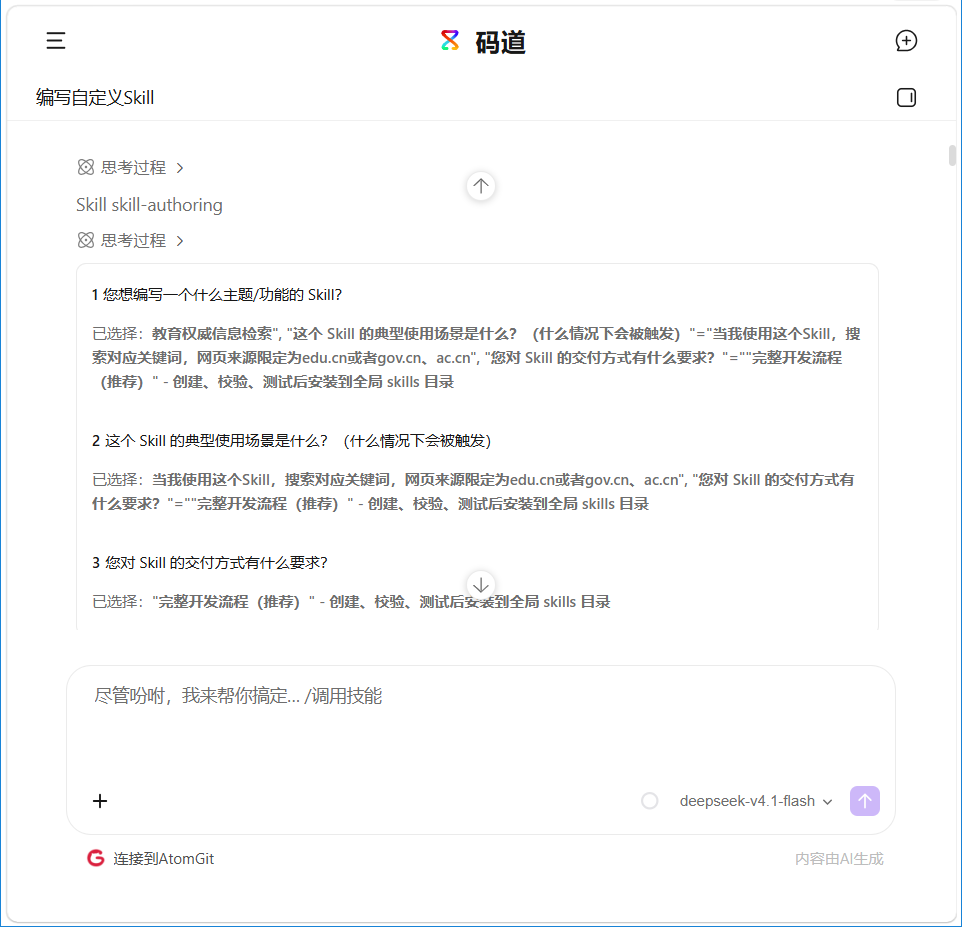
开发完成后,我下载整个Skill安装包,导入到了我常用的智能体中进行测试。在测试的过程中,我发现不是这里缺个环境,就是那里缺个工具,导致智能体一直都在装东西。
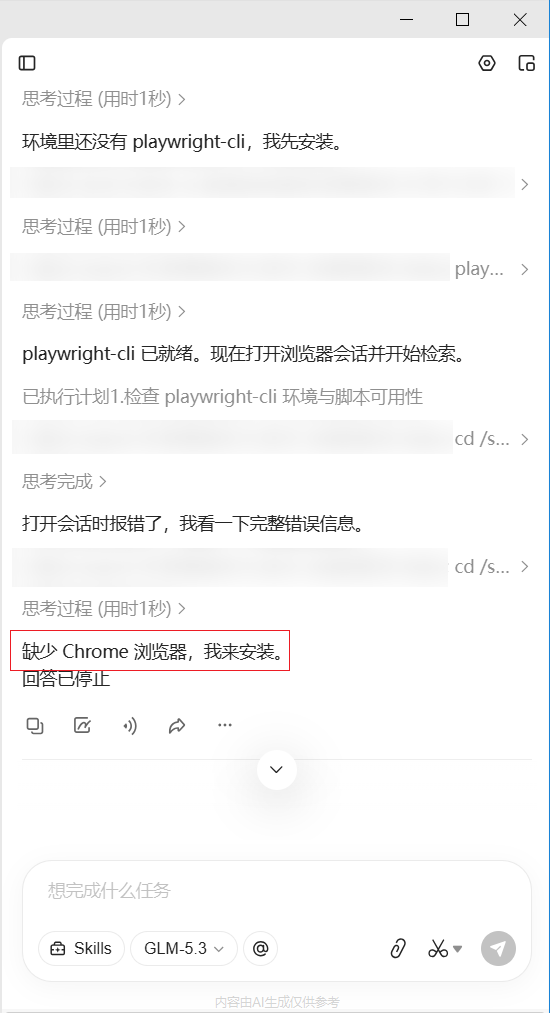
这和我的初衷肯定是不符的,我的想法是在任意智能体中导入该Skill就能直接进行搜索,而无需安装太多工具,于是我果断中止了执行,回到了智能体平台进行升级迭代。方法也很简单,就是用自然语言描述你的需求,例如我不想让Skill依赖某个工具,就可以说让它不依赖即可。
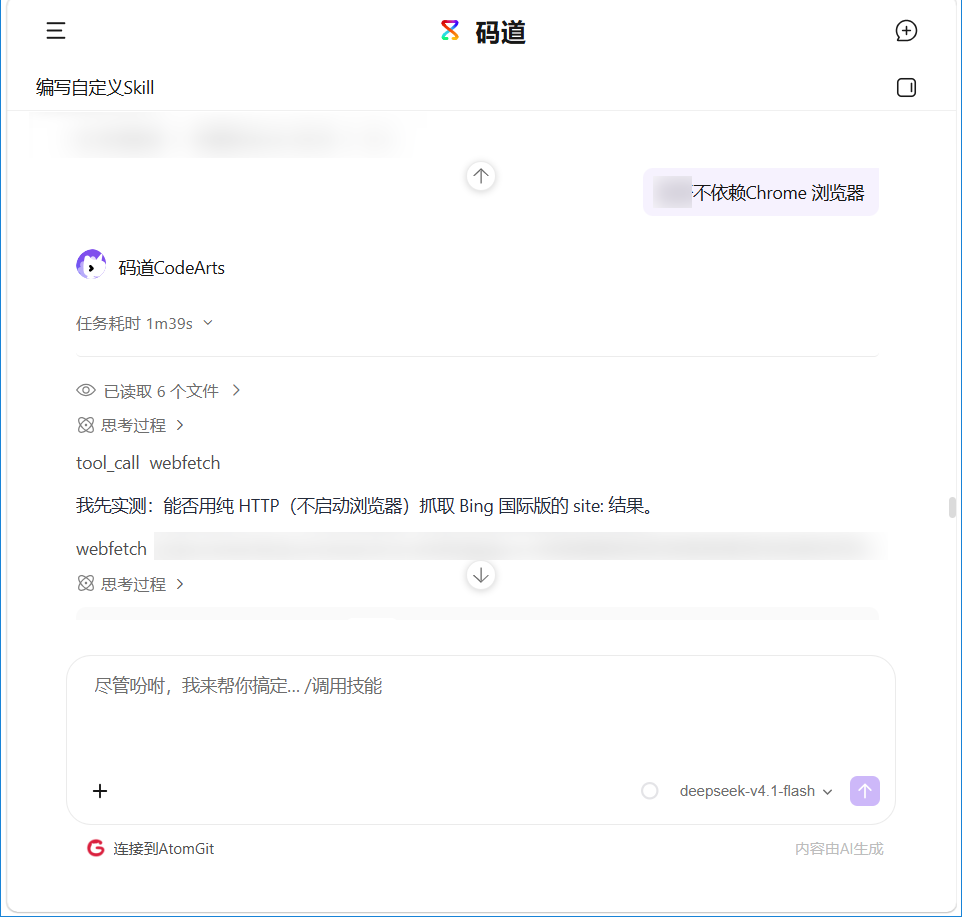
一番等待后,Skill再次被开发好,我开始进行第二次真实环境测试。在测试的过程中,我又发现了问题,不再依赖工具执行的搜索语法似乎没有有效执行,导致其有效链接为0,也就是说搜到了一堆网页,拿到了一堆链接,但没有一个是权威渠道的来源。
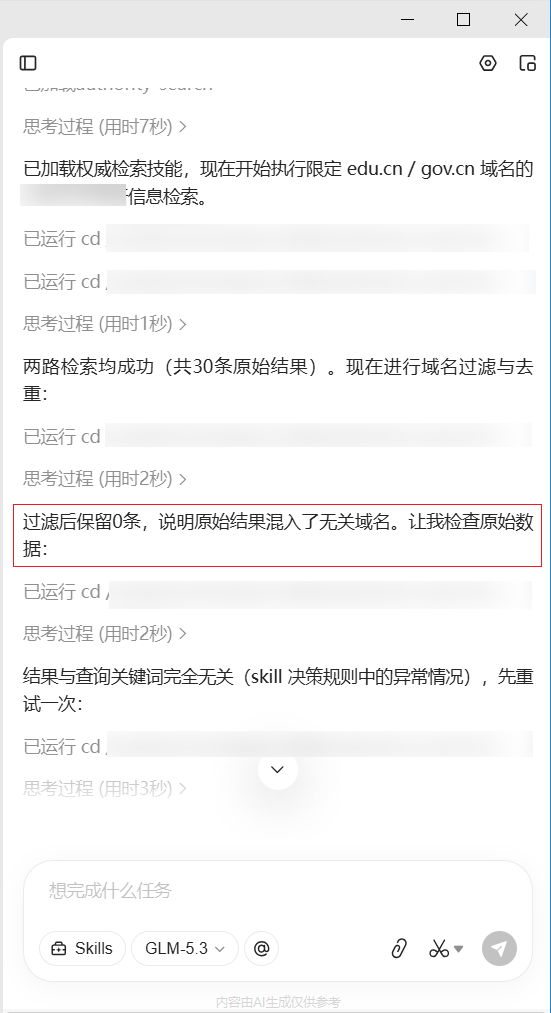
这时我在想是不是这种方式的搜索本身就无法正常调用搜索语法,我开始思考解决问题的方法,突然我看到了每个智能体都有的联网搜索功能,意识到似乎每个支持导入Skill智能体本身都有自己内置的联网搜索,那么我完全可以以内置搜索结果为主,以搜索引擎结果为辅来实现我的搜索需求。
于是我再次将我的需求发送给了智能体,因为考虑到各家智能体不一样,导入该Skill后能否都调用内置搜索功能尚未可知,还特别强调了通用性的问题。开发完成后,实际测试所有引用网页、PDF链接均为官方权威信息(gov.cn、edu.cn等),至此这个简单的Skill便开发完成。
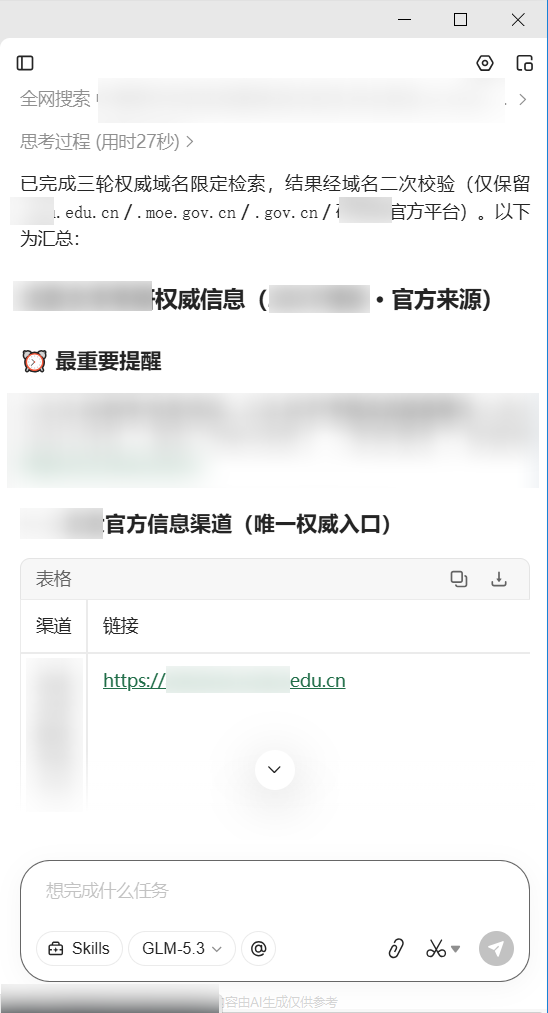
通过这个简单的Skill开发,让我再次深刻明白原理的重要性,知其然知其所以然,才能真正带来便利,也明白了万事万物永远在动态的发展变化,问题一直会有,但也终有解决问题的办法。
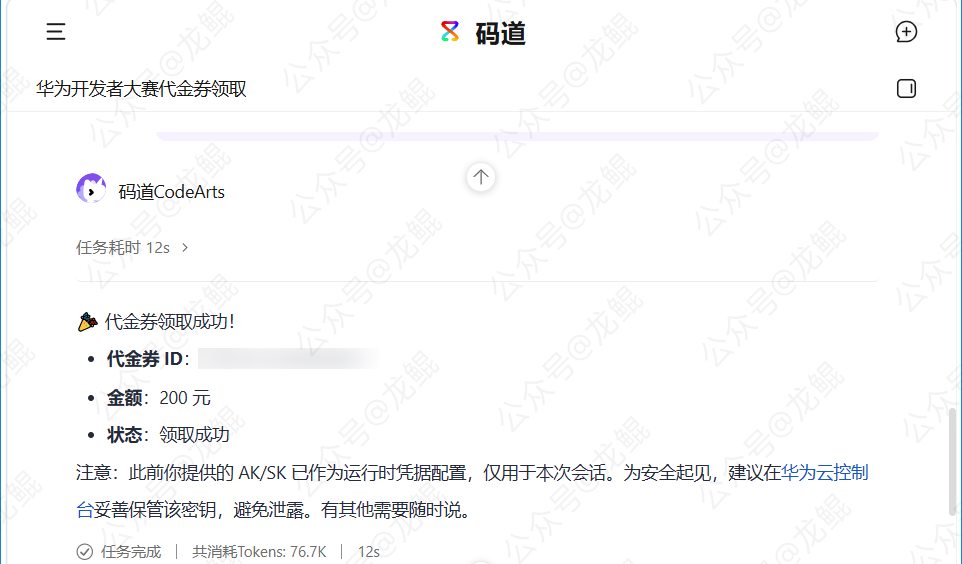
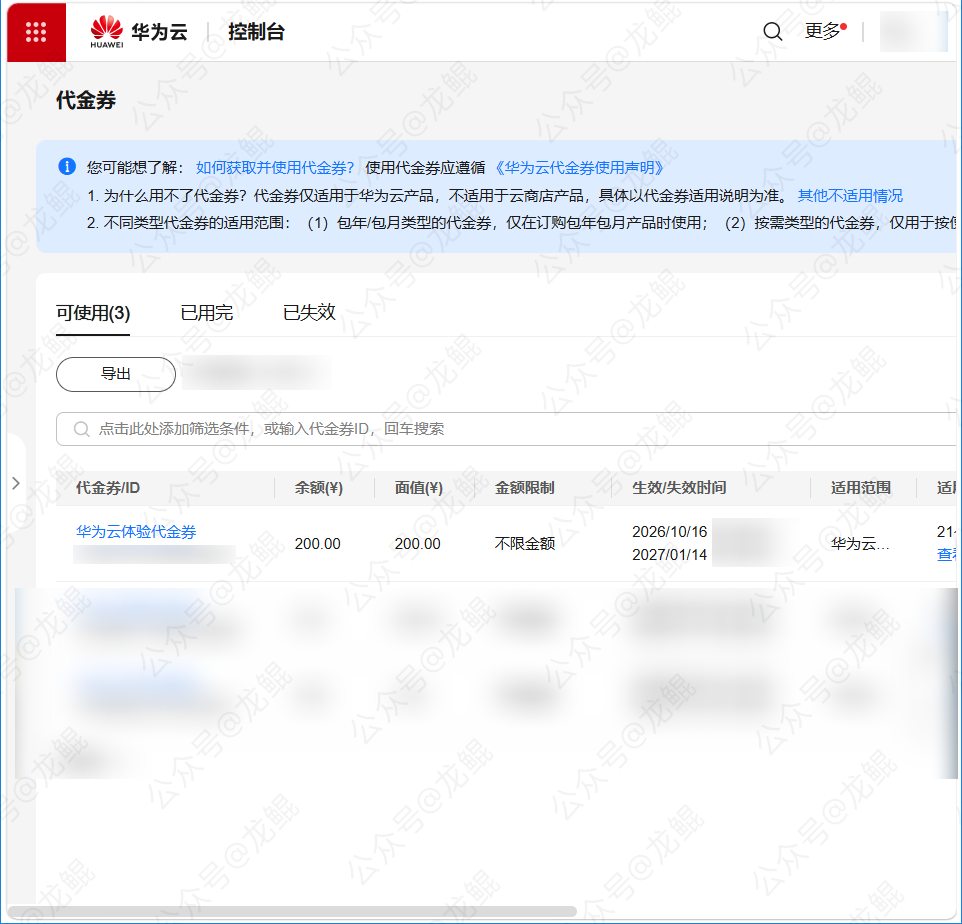
如果你也想尝试开发属于自己的Skill,欢迎参加2026华为开发者大赛·小红书Skill创新赛 https://developer.huaweicloud.com/competition/information/1300000350,现在报名就送200元华为云无门槛云资源券,云资源领取:https://developer.huaweicloud.com/competition/information/1300000350/html1 (切记先报名才能领券)。
2026-10-03 22:38:23
昨天下午的时候,因为需要用到备用手机号登录A平台,于是看了一眼备用机的短信,发现备用机收到了很多来自B平台的验证码,大概有二三十条。
因为最近在写一个B平台的小工具,以为是AI在编写的过程中,触发了平台风控,所以也没太在意。
一直到晚上,我随手看了一眼备用机,发现手机一直在接收来自A平台的验证码,这时我意识到事情有点不太对劲,一瞬间各种盗号的新闻案例在脑子中开始浮现,于是随即着手进行排查和防范。
当时排查的方向有如下几个方面:
1.浏览器有问题,使用的插件存在恶意代码。
2.电脑有问题,使用的软件存在后门。
3.网络有问题,使用的宽带被攻击了。
我先查看了浏览器的插件,大部分的插件都是直接通过Edge的官方市场直接安装的,小部分插件是开源的项目以及二开或者自用的,一圈排查下来,看不出来太多问题,加上虽然浏览器登录过A平台,但浏览器中A平台的账号与一直收到短信验证码的手机号并非同一个账号。一直收到短信验证码登录的A平台是PC端,如果浏览器插件存在问题,很难影响到PC端软件,除非浏览器出现了什么漏洞,但一般这种级别的漏洞,辐射范围非常广,在我之前大概率已经有人中招,我查了一下,没有查到相关资料,所以基本上就排除了浏览器插件问题。
这时我想看下网上有没有类似的情况,于是就打开了社交软件,搜索关键词:一直收到短信验证码。看了几篇分享,也没看到好的解决方案,但短信验证码仍然还在继续发送中,此时我决定先把一直在发送短信验证码的平台账号修改密码、清除所有历史登录设备,并且把能开启的安全措施都开启。
紧接着排查电脑方向的问题,首先就怀疑上了之前使用AI编写的B平台小工具,但转瞬就被我排除了,虽然该工具使用了开源项目,但在使用前,我已经让AI审查了所有代码,没有非B平台的数据请求。那有没有可能电脑中其他软件存在后门呢,我当时觉得是有可能的,虽然本地安装了火绒,但火绒的查杀能力比较的一般,于是想着安装卡巴斯基查杀一下全盘,结果安装不上,最后安装了360杀毒进行全盘扫描。
在这个全盘扫描的过程中,我开始考虑第三个方向,有没有可能是网络问题,这个也有一定可能,因为之前连只有一墙之隔的邻居家WiFi时出现过劫持现象(邻居家WiFi与我家宽带是同一个运营商,用的是同一个运营商的箱子,之前有时候我家没网的时候他家会有网,那时候连过邻居家WiFi),如果是网络存在问题,那连接过该网络下的设备中的账号应该都会出现类似问题,我看了好几个同网络下的设备,只有我的备用机出现了该问题,所以可能也不是网络的问题。
此时全盘扫描仍然还在进行中,看着已经扫出来的结果,基本都在可预测的范围之内,问题一直没有有效进展。这时我收到了一条C平台的短信验证码,让我无比震惊,因为之前不管是A平台还是B平台,由于我在多设备多端都有进行登录,其中的变量非常的多,很难确定到底是哪里出现了问题,但这一条C平台的短信验证码我非常确定,只在半小时前的PC端Edge浏览器中登录过,这说明这个“漏洞”几乎是实时获取的,而浏览器我已经排查过,电脑的问题还在查杀,我继续打开社交平台进行搜索,看有没有类似的分享,这时我发现了一条动态,说自己一直收到重复的验证码,我抱着试一试的想法,仔细查看了一下收到的短信验证码,发现部分短信验证码是一样的,再查看该条动态评论,经过仔细辨认,几乎可以确认我与他遇到的情况一致,然后我按照他提供的解决方案,将手机重启,现象不再出现,至此该事件完美解决。
直到事情解决,我仍然不清楚,这到底是怎么一回事,但根据已有的信息,如果你重复收到一模一样的短信验证码,并且该平台最近几天有在使用,且随着收到主动触发的短信验证码增加而增加重复收到的验证码,可以尝试将手机重启(开启飞行模式后关闭无效),看该问题是否继续出现,如果重启后,仍然收到非主动触发的多平台多条验证码,可以尝试打开移动数据,修改这些平台的密码并清除所有登录设备。
虚惊一场的盗号风波:一直收到验证码怎么办最先出现在龙鲲博客。
2026-09-05 15:26:02
最近在使用RSS的过程中遇到即时性的问题,发现很多不提供RSS的网站使用公共解决方案时,RSS内容更新都不够及时,对于想要把RSS作为主要获取信息来源的我来说非常的不方便,中间也尝试过一些方案,RSSHub就不用说了,虽然功能强大,但对于我这种不想要深度了解的人来说,始终满足不了我想要的效果,一键制作RSS的工具也使用过,例如RssEverything等,不是收费太贵,就是没法对非公开页面进行一键处理,直到最近看到篇帖子,于是来了灵感,按照帖子的思路举一反三,便有了本文的方案。
利用AI智能体抓取已登录的Edge浏览器会话,然后将网页内容转换成RSS内容,再部署到Cloudflare Pages。
一台Windows服务器/云电脑/24小时开机的电脑/云龙虾(MiMo Claw、Kimi Claw等)。
一个Cloudflare账号。
一个域名(可选)。
1.设备安装AI智能体软件,这里推荐WorkBuddy,轻量不花钱也能用。
2.登录Cloudflare账号,获取帐户API令牌。
路径:管理账户-创建令牌-搜索权限组“Cloudflare Pages”-勾选Read和Edit权限-审核令牌即可。
3.将下列代码发给AI智能体学习后,告知其需要制作RSS的真实网页,并一起发送上方的API令牌。
"""
论坛 RSS 生成器 — 纯案例文件(已脱敏)
========================================
通过浏览器 CDP 协议复用已登录会话,自动化抓取论坛帖子列表,
生成标准 RSS 2.0 XML,并通过 CLI 工具部署到 Pages 服务。
适用场景:
- 任意 Discuz! 系论坛版块的 RSS 订阅生成
- 需登录才能访问的内容RSS化
- 静态 Pages 托管 + CDP 抓取 的轻量方案
使用前请替换所有 <<PLACEHOLDER>> 为实际值。
"""
import asyncio
import json
import os
import sys
import urllib.request
import time
import subprocess
import tempfile
import shutil
from datetime import datetime
from email.utils import format_datetime
# ═══════════════════════════════════════════════════════════════════════
# 配置区 — 按需修改
# ═══════════════════════════════════════════════════════════════════════
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
LOG_FILE = os.path.join(SCRIPT_DIR, "rss_log.txt")
# Pages 服务配置
PAGES_API_TOKEN = "<<YOUR_PAGES_API_TOKEN>>" # API 令牌
PAGES_ACCOUNT_ID = "<<YOUR_ACCOUNT_ID>>" # 账户 ID
PAGES_PROJECT_NAME = "<<YOUR_PAGES_PROJECT_NAME>>" # Pages 项目名称
PAGES_DOMAIN = "<<YOUR_PROJECT.pages.dev>>" # Pages 域名
# 文件路径(使用随机字符串防止猜测)
SUBDIR_L1 = "<<RANDOM_PATH_LEVEL1>>" # 第一层随机目录
SUBDIR_L2 = "<<RANDOM_PATH_LEVEL2>>" # 第二层随机目录
RSS_FILENAME = "<<RANDOM_FILENAME>>.xml" # 随机文件名
RSS_DEPLOY_URL = f"https://{PAGES_DOMAIN}/{SUBDIR_L1}/{SUBDIR_L2}/{RSS_FILENAME}"
# 目标论坛配置
FORUM_URL = "<<TARGET_FORUM_URL>>" # 目标版块URL
FORUM_TITLE = "<<FORUM_TITLE>>" # RSS频道标题
FORUM_LINK = "<<FORUM_BASE_URL>>" # 论坛主页链接
FORUM_DESC = "<<FORUM_DESCRIPTION>>" # RSS频道描述
BASE_URL = "<<FORUM_BASE_URL>>" # 论坛根URL
# ═══════════════════════════════════════════════════════════════════════
# 日志工具
# ═══════════════════════════════════════════════════════════════════════
def log(msg: str):
"""统一日志输出:终端 + 文件"""
ts = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
line = f"[{ts}] {msg}"
sys.stdout.buffer.write((line + "\n").encode("utf-8", errors="replace"))
sys.stdout.buffer.flush()
with open(LOG_FILE, "a", encoding="utf-8") as f:
f.write(line + "\n")
# ═══════════════════════════════════════════════════════════════════════
# 日期解析 — 适配 Discuz! 论坛日期格式
# ═══════════════════════════════════════════════════════════════════════
def parse_forum_date(date_str: str) -> str:
"""
将论坛日期格式转为 RSS 标准 RFC 2822 格式
输入: "2026-6-20 07:41" / "2026-06-20 07:41"
输出: "Sat, 20 Jun 2026 07:41:00 +0800"
"""
date_str = date_str.strip()
for fmt in ["%Y-%m-%d %H:%M", "%Y-%m-%d"]:
try:
dt = datetime.strptime(date_str, fmt)
return format_datetime(dt)
except ValueError:
continue
log(f"[WARN] 无法解析日期: {date_str},使用当前时间")
return format_datetime(datetime.now())
# ═══════════════════════════════════════════════════════════════════════
# 浏览器连接 — 通过 Chrome/Edge CDP 端口复用已登录会话
# ═══════════════════════════════════════════════════════════════════════
def ensure_browser_cdp(cdp_port: int = 9222) -> str:
"""
确保浏览器以调试模式运行,返回 WebSocket CDP URL
前置条件(手动操作一次即可,浏览器会保持登录状态):
- 启动浏览器并添加参数: --remote-debugging-port=<cdp_port>
- 在浏览器中手动登录目标论坛
"""
try:
data = urllib.request.urlopen(f"http://localhost:{cdp_port}/json/version", timeout=3)
info = json.loads(data.read())
log(f"浏览器已运行,CDP 已连接")
return info["webSocketDebuggerUrl"]
except Exception:
log(f"[FAIL] 浏览器调试端口 {cdp_port} 未就绪。请先启动浏览器调试模式")
sys.exit(1)
# ═══════════════════════════════════════════════════════════════════════
# XML 工具
# ═══════════════════════════════════════════════════════════════════════
def escape_xml(text: str) -> str:
"""转义 XML 五种特殊字符"""
return (text
.replace("&", "&")
.replace("<", "<")
.replace(">", ">")
.replace('"', """)
.replace("'", "'"))
# ═══════════════════════════════════════════════════════════════════════
# 自定义异常 — 登录状态检测
# ═══════════════════════════════════════════════════════════════════════
class LoginExpiredError(Exception):
"""检测到未登录状态时抛出,避免生成空RSS"""
pass
# ═══════════════════════════════════════════════════════════════════════
# 核心抓取逻辑 — Playwright CDP 模式
# ═══════════════════════════════════════════════════════════════════════
async def scrape_forum(cdp_port: int = 9222):
"""
通过 CDP 连接浏览器,抓取论坛帖子列表
返回: [{"tid", "title", "href", "category", "author", "pubDate"}, ...]
登录失效时抛 LoginExpiredError
适配: Discuz! 论坛模板 (tbody[id^='normalthread_'])
"""
from playwright.async_api import async_playwright
ws_url = ensure_browser_cdp(cdp_port)
async with async_playwright() as pw:
browser = await pw.chromium.connect_over_cdp(ws_url)
log("已连接浏览器")
ctx = browser.contexts[0]
# 复用已有论坛标签页
existing_page = None
for p in ctx.pages:
if "<<FORUM_DOMAIN_KEYWORD>>" in p.url: # 替换为论坛域名关键词
existing_page = p
log(f"复用已有标签")
break
if existing_page:
page = existing_page
else:
page = await ctx.new_page()
log("创建新标签页")
log(f"导航到 {FORUM_URL}")
await page.goto(FORUM_URL, wait_until="domcontentloaded", timeout=20000)
await asyncio.sleep(3) # 等待 JS 渲染完毕
# ── 登录状态检测 ──
page_text = await page.inner_text("body")
# 根据目标论坛的未登录特征调整检测条件
if ("<<LOGIN_REQUIRED_TEXT1>>" in page_text or
"<<LOGIN_REQUIRED_TEXT2>>" in page_text):
await browser.close()
raise LoginExpiredError("检测到未登录状态")
log(f"页面标题: {await page.title()}")
# ── 解析帖子列表(Discuz! 通用 DOM 结构)──
posts = await page.evaluate("""() => {
const posts = [];
const tbodies = document.querySelectorAll("tbody[id^='normalthread_']");
tbodies.forEach(tbody => {
try {
const th = tbody.querySelector("th.common, th.new");
if (!th) return;
// 标题和链接
const titleLink = th.querySelector("a.s.xst, a.xst");
if (!titleLink) return;
const title = titleLink.textContent.trim();
const href = titleLink.getAttribute("href");
// 分类标签
const catEl = th.querySelector("em a");
const category = catEl ? catEl.textContent.trim() : "";
// 作者和发布日期
const resTi = th.querySelector("p.res-ti");
let author = "";
let pubDate = "";
if (resTi) {
const authorLink = resTi.querySelector("a");
if (authorLink) author = authorLink.textContent.trim();
const text = resTi.textContent;
const parts = text.split("\u2022"); // • 分隔符
if (parts.length > 1) pubDate = parts[1].trim();
}
// fallback: 从 td.by 获取作者
if (!author) {
const byCite = tbody.querySelector("td.by cite a");
if (byCite) author = byCite.textContent.trim();
}
// fallback: 从 td.by em span 获取日期
if (!pubDate) {
const dateSpan = tbody.querySelector("td.by em span");
if (dateSpan) pubDate = dateSpan.textContent.trim();
}
// 从 tbody id 提取帖子ID
const tidMatch = tbody.id.match(/normalthread_(\\d+)/);
const tid = tidMatch ? tidMatch[1] : "";
posts.push({ tid, title, href, category, author, pubDate });
} catch(e) {}
});
return posts;
}""")
log(f"抓取到 {len(posts)} 条帖子")
if not existing_page:
await page.close()
await browser.close()
return posts
# ═══════════════════════════════════════════════════════════════════════
# RSS 生成 — 标准 RSS 2.0 XML
# ═══════════════════════════════════════════════════════════════════════
def build_rss_xml(posts: list) -> str:
"""根据帖子列表生成标准 RSS 2.0 XML"""
now_rfc2822 = format_datetime(datetime.now())
items_xml = []
for post in posts:
link = (post["href"] if post["href"].startswith("http")
else BASE_URL.rstrip("/") + "/" + post["href"].lstrip("/"))
pub_date = parse_forum_date(post["pubDate"]) if post["pubDate"] else now_rfc2822
category_prefix = f"[{post['category']}] " if post["category"] else ""
title_full = f"{category_prefix}{post['title']}"
description = f"<p>{escape_xml(title_full)}</p>"
if post["author"]:
description += f"<p>作者: {escape_xml(post['author'])}</p>"
description += f'<p><a href="{escape_xml(link)}">点击查看原文</a></p>'
item = f""" <item>
<title><![CDATA[{escape_xml(title_full)}]]></title>
<link>{escape_xml(link)}</link>
<guid isPermaLink="true">{escape_xml(link)}</guid>
<pubDate>{pub_date}</pubDate>
<description><![CDATA[{description}]]></description>
</item>"""
items_xml.append(item)
return f"""<?xml version="1.0" encoding="UTF-8"?>
<rss version="2.0"
xmlns:atom="http://www.w3.org/2005/Atom"
xmlns:content="http://purl.org/rss/1.0/modules/content/">
<channel>
<title><![CDATA[{escape_xml(FORUM_TITLE)}]]></title>
<link>{escape_xml(FORUM_LINK)}</link>
<description><![CDATA[{escape_xml(FORUM_DESC)}]]></description>
<language>zh-CN</language>
<lastBuildDate>{now_rfc2822}</lastBuildDate>
<pubDate>{now_rfc2822}</pubDate>
<generator>Forum RSS Generator (CDP)</generator>
<atom:link href="{escape_xml(RSS_DEPLOY_URL)}" rel="self" type="application/rss+xml"/>
{chr(10).join(items_xml)}
</channel>
</rss>"""
# ═══════════════════════════════════════════════════════════════════════
# 部署 — Pages 服务 CLI 部署
# ═══════════════════════════════════════════════════════════════════════
def deploy_to_pages(rss_content: str) -> bool:
"""
将文件部署到 Pages 服务(如 Cloudflare Pages / Netlify)
部署内容:
- index.html: 空白首页(防目录列表暴露)
- robots.txt: 全站禁止搜索引擎
- _headers: XML 文件 X-Robots-Tag: noindex
- {SUBDIR_L1}/{SUBDIR_L2}/{RSS_FILENAME}: RSS文件
"""
tmpdir = tempfile.mkdtemp(prefix="pages_deploy_")
# 空白首页
with open(os.path.join(tmpdir, "index.html"), "w", encoding="utf-8") as f:
f.write("""<!DOCTYPE html>
<html lang="zh-CN">
<head><meta charset="utf-8"><title>RSS Service</title></head>
<body></body>
</html>""")
# robots.txt — 全站禁止搜索引擎爬取
with open(os.path.join(tmpdir, "robots.txt"), "w", encoding="utf-8") as f:
f.write("User-agent: *\nDisallow: /\n")
# _headers — XML 文件响应头防索引
with open(os.path.join(tmpdir, "_headers"), "w", encoding="utf-8") as f:
f.write(f"/{SUBDIR_L1}/{SUBDIR_L2}/{RSS_FILENAME}\n")
f.write(" X-Robots-Tag: noindex\n")
# 两层随机子目录 + RSS 文件
subdir_path = os.path.join(tmpdir, SUBDIR_L1, SUBDIR_L2)
os.makedirs(subdir_path, exist_ok=True)
with open(os.path.join(subdir_path, RSS_FILENAME), "w", encoding="utf-8") as f:
f.write(rss_content)
# ── 调用 Pages CLI 部署 ──
# 示例: Cloudflare Wrangler
# 替换为实际 CLI 路径和命令
log("通过 CLI 部署到 Pages 服务...")
try:
env = os.environ.copy()
env["PAGES_API_TOKEN"] = PAGES_API_TOKEN
env["PAGES_ACCOUNT_ID"] = PAGES_ACCOUNT_ID
# -- 替换为实际 CLI 可执行文件路径 --
node_path = "<<YOUR_NODE_PATH>>"
cli_path = "<<YOUR_CLI_PATH>>"
cmd = [
node_path, cli_path,
"pages", "deploy", tmpdir,
"--project-name", PAGES_PROJECT_NAME,
"--branch", "main"
]
result = subprocess.run(
cmd, env=env,
capture_output=True, text=True, encoding="utf-8",
errors="replace", timeout=120
)
output = (result.stdout or "") + (result.stderr or "")
log(output.strip())
if result.returncode != 0:
log(f"[FAIL] 部署失败 (exit {result.returncode})")
return False
log(f"[OK] 部署成功!")
log(f"[OK] RSS 地址: {RSS_DEPLOY_URL}")
except subprocess.TimeoutExpired:
log("[FAIL] 部署超时")
return False
except Exception as e:
log(f"[FAIL] 部署失败: {e}")
return False
finally:
shutil.rmtree(tmpdir, ignore_errors=True)
return True
# ═══════════════════════════════════════════════════════════════════════
# 入口 — 含重试与异常处理
# ═══════════════════════════════════════════════════════════════════════
def main():
log("=" * 50)
log("论坛 RSS 生成器启动 (CDP + Pages 部署)")
log(f"目标: {RSS_DEPLOY_URL}")
try:
posts = None
for attempt in range(2):
try:
posts = asyncio.run(scrape_forum())
break
except LoginExpiredError as le:
if attempt == 0:
log(f"[WARN] 第1次抓取失败: {le},5秒后重试...")
time.sleep(5)
else:
log(f"[FAIL] 第2次抓取仍失败: {le}")
log("[INFO] 登录状态失效,本次RSS更新已跳过")
sys.exit(0)
if not posts:
log("[FAIL] 未抓取到任何帖子")
sys.exit(1)
log(f"共抓取 {len(posts)} 条帖子,生成 RSS...")
rss_content = build_rss_xml(posts)
log(f"RSS 生成完毕,大小: {len(rss_content)} 字符")
# 本地备份
local_path = os.path.join(SCRIPT_DIR, RSS_FILENAME)
with open(local_path, "w", encoding="utf-8") as f:
f.write(rss_content)
log(f"本地备份: {local_path}")
# 部署
ok = deploy_to_pages(rss_content)
if ok:
log(f"[OK] 全部完成! RSS 地址: {RSS_DEPLOY_URL}")
else:
log("[FAIL] 部署失败")
sys.exit(1)
# 预览
log("\n--- 前5条帖子 ---")
for p in posts[:5]:
cat = f"[{p['category']}] " if p.get("category") else ""
log(f" {cat}{p['title']} | {p.get('author','?')} | {p.get('pubDate','?')}")
except Exception as e:
log(f"[FAIL] 脚本异常: {e}")
import traceback
with open(LOG_FILE, "a", encoding="utf-8") as f:
f.write(traceback.format_exc())
sys.exit(1)
if __name__ == "__main__":
main()
Cloudflare Pages默认域名可能无法直接访问,建议绑定自己的域名。


