
2026-07-02 21:50:34
ED Sentry是一个给Elite Dangerous[1]挂机用的监控工具。它会读取游戏在本地写的日志,统计挂机时的击杀、扫描和任务进度,出问题的时候通过Matrix提醒自己,也可以用一个仪表盘在电脑或者手机上查看。代码发布在GitHub上,项目地址。
最近在玩Elite Dangerous的AFK Massacre,也就是挂机打清剿任务。具体的玩法是先接一堆清剿海盗的任务,然后开着Type-10停在资源采集点,让炮塔和舰载机自动去打来抢劫的海盗,人可以离开电脑去做别的事情。挂机的时候最担心的是中途出问题,比如舰载机被打掉了、护盾掉了,或者海盗一直不来,人不在电脑前面是不知道的。
已经有一个类似的工具叫ED-AFK-Monitor[2],它会读取游戏的日志,然后把挂机的状态推送到Discord。但是它是一个Python的单文件,Discord的推送逻辑和主流程耦合得比较紧,自己想要的是推送到Matrix[3],在它上面改的话代码只会更复杂。所以就决定用Rust重新实现一个独立的工具。
因为这个游戏基本上只能在Windows上玩,所以整个项目都是以Windows为主要目标来开发的,最终的产物是一个不需要Python环境的轻量Windows程序。
挂机之前需要确认船的状态是对的,不然走开之后挂一晚上可能什么都没打到。ED Sentry的仪表盘上有一个检查清单,只有三项:
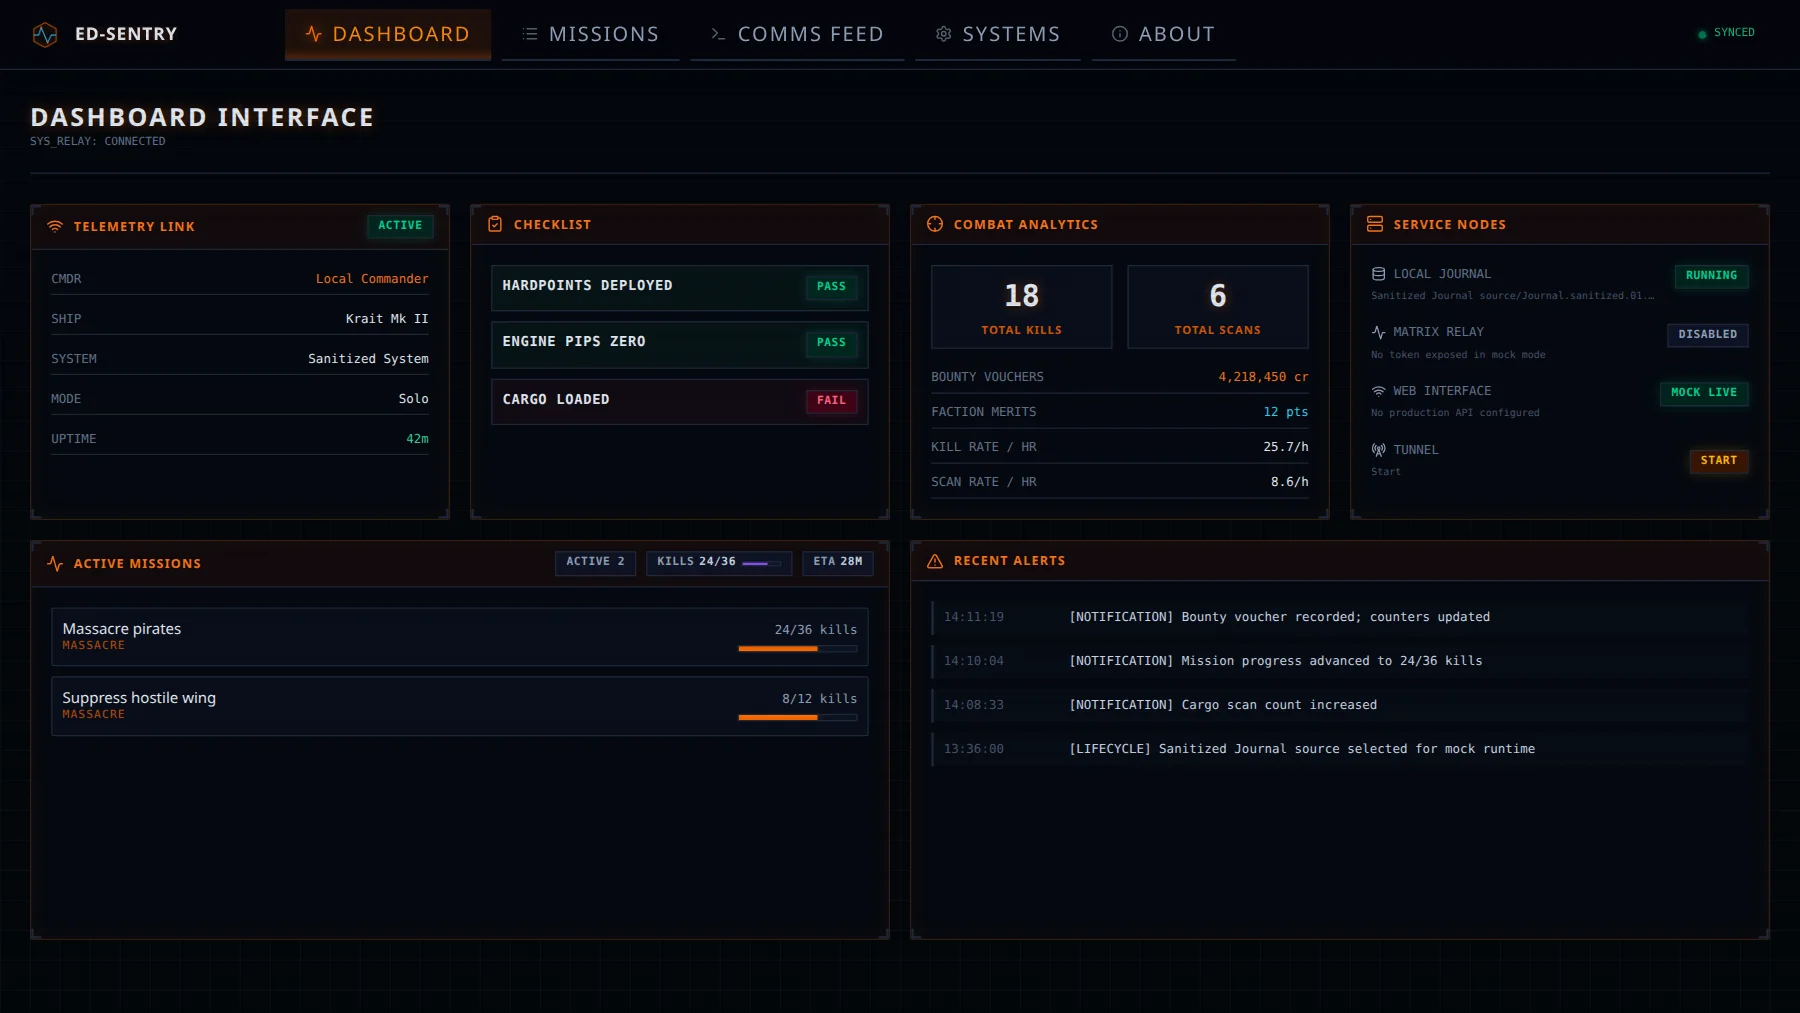
Fig. 1. ED Sentry的仪表盘,左上第二个面板是检查清单。截图里是示例数据
这三项是从游戏写的Status.json和Cargo.json里读出来的,文件一变化就会更新。每一项有通过、不通过和未知三种状态,因为游戏有时候不会写某些字段,比如Status.json里有时候没有引擎能量的数据,这时候就显示未知,不去猜。
这个位置原来是一个船体完整度的面板,但是这部分数据常年缺失,显示出来也不可靠,所以就换成了现在的检查清单。agent第一次做出来的检查清单,每一项下面都写了一大段说明,比如STATUS FLAGS BIT 0X40 IS SET STATUS.JSON这样的文字,后来全部删掉了,只留下三个简单的名字,挂机的时候谁会去看这些东西。
ED Sentry会一直读取游戏最新的Journal日志,游戏每写一行新的事件,它就会更新统计,并且根据事件生成通知。比如击杀、被扫描、舰载机受损或者被摧毁、护盾掉了、货物丢失、燃料不足、死亡、任务进度变化等等。
除了这些事件,它还会在挂机效率出问题的时候报警。默认是开始挂机5分钟之后还没有击杀,或者之后20分钟没有新的击杀,就会报警。击杀的速度低于每小时20个,也会报警。
通知会同时输出到两个地方:
下面是终端输出的一段节选,来自自己的一次挂机记录,是用回放模式把当时的Journal重新跑了一遍得到的。从进入资源采集点开始,每一次击杀、货舱被扫描、燃料剩余都会记一行,击杀后面括号里是距离上一次击杀的时间,完成一个任务的击杀数也会提示出来,每隔一段时间还会输出一次统计:
1 |
=========================================== |
每一种事件都可以单独设置等级,0是不通知,1是通知,2是通知并且在Matrix里@自己,这样舰载机被摧毁、死亡这种需要马上处理的事件就会响铃。Matrix里还有一条状态消息,它不会一直刷屏,而是每隔一段时间编辑同一条消息,更新当前的统计。Matrix的房间需要是不加密的,因为支持端到端加密会增加太多的复杂度。
除了提醒,有时候也想直接看一下现在的状态,所以ED Sentry还有一个仪表盘,就是上面Fig. 1的界面。在Windows上,它是一个用Tauri[4]做的桌面程序。同时它也可以作为一个网页服务运行,在同一个局域网里,用手机的浏览器就能打开同一个仪表盘。
一开始agent给网页服务加了很多安全限制,比如只有本机才能修改配置。自己觉得设计得太保守了,这个服务本来就是给内网用的,所以就把这些限制去掉了,只保留了基本的Host和CORS检查。
如果人不在家,局域网就访问不到了。所以又加了一个隧道的功能,点一下START,就会用Cloudflare的Quick Tunnel[5]生成一个公开的链接,鼠标放上去还会显示一个二维码,手机扫一下就能打开。Quick Tunnel不需要注册账号,也不需要额外装什么,程序里已经带了cloudflared。公开链接可以设置一个密码,设置了之后,远程访问的人需要先登录才能修改配置。没有设置密码的话,就是谁拿到链接都能访问,风险由用户自己承担。
挂机回来,最关心的是任务打到哪里了。MISSIONS页面会列出所有正在进行的任务,点进去可以看到每个任务的发布阵营、目标阵营、报酬和击杀进度。
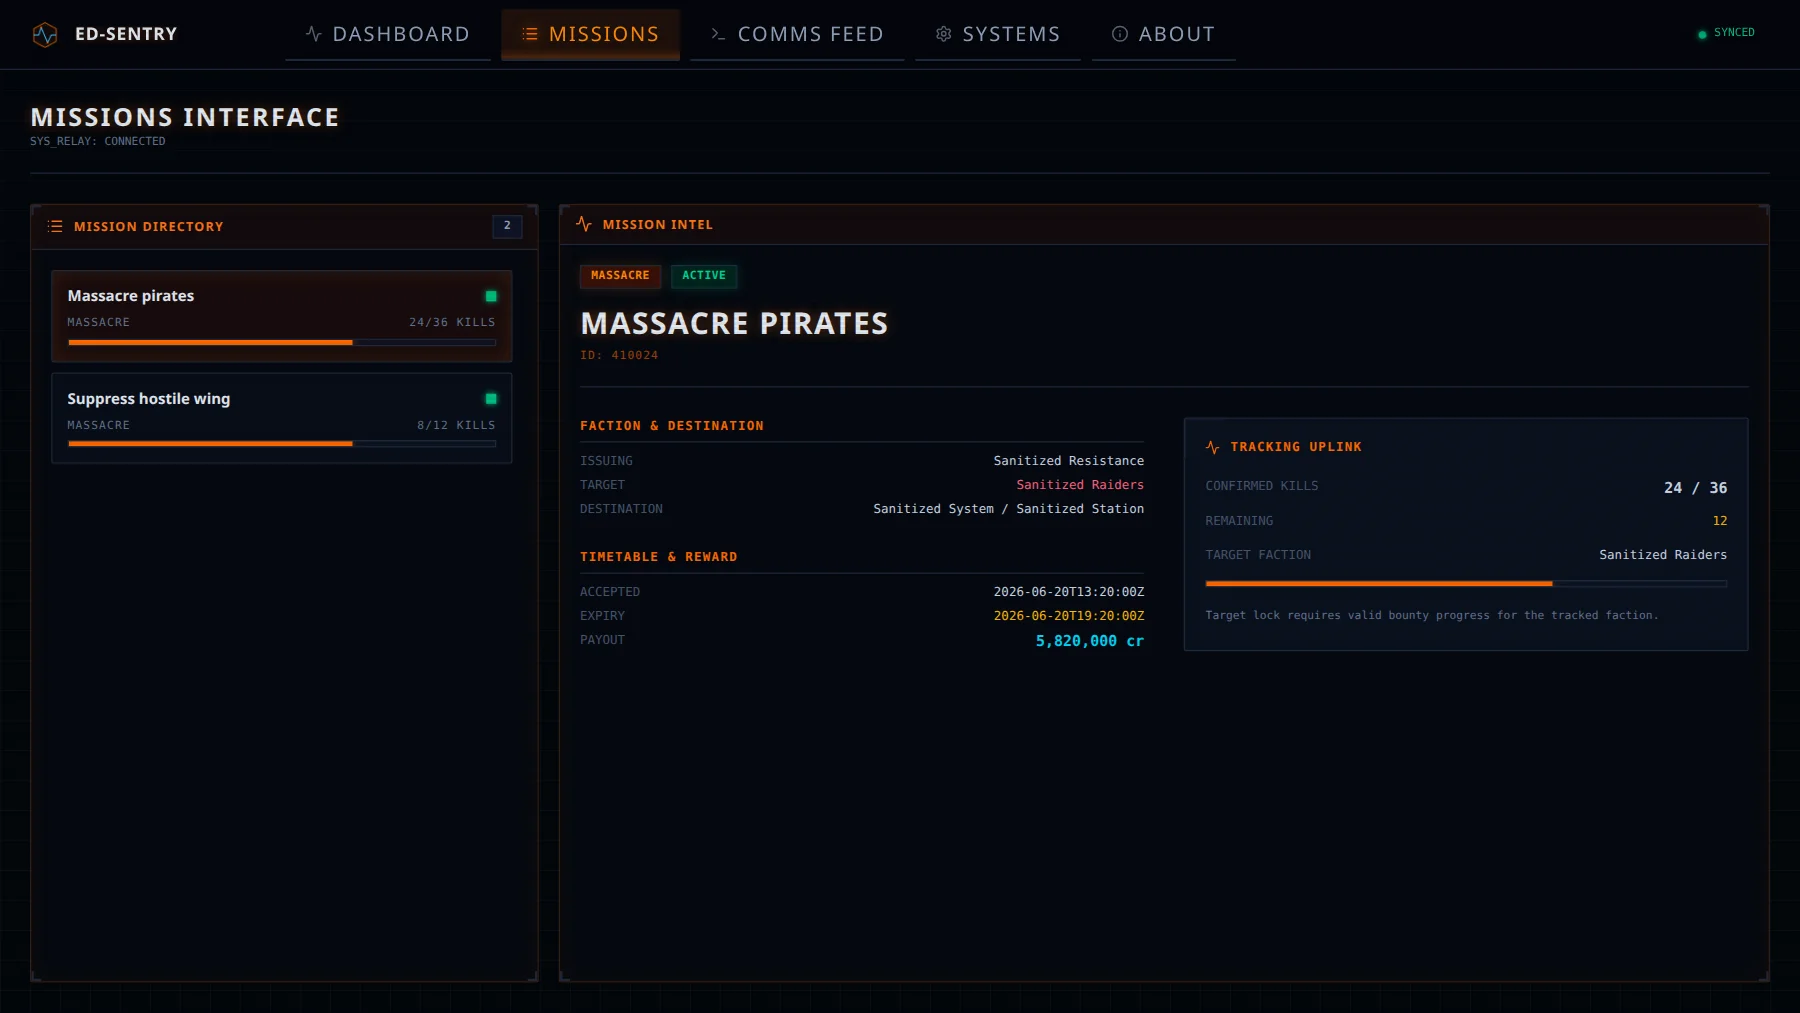
Fig. 2. MISSIONS页面,左边是任务列表,右边是任务的详细信息。截图里是示例数据
清剿任务可以叠很多个,但是同一个阵营发布的多个任务,一次击杀只会算给其中一个,不同阵营发布的任务才能同时推进。这部分的规则参考了ODEliteTracker[6]的做法,仪表盘上会按这个规则算出总的击杀进度,再根据现在的击杀速度估算还要多久才能打完。
Windows可以在GitHub的Releases里下载ed-sentry-<版本>-windows-x64.zip,解压之后双击ed-sentry.exe就可以了。解压出来的文件需要放在一起,因为程序运行的时候会用到里面的webui/和tools/。Journal的文件夹默认就是游戏的存档位置,一般不需要改。
如果只想用终端,可以直接运行核心程序:
1 |
.\ed-sentry-core.exe --config config.toml |
Linux的版本只有核心程序和网页,没有桌面窗口,需要在配置里写上Journal的路径。
配置都在config.toml里,Matrix和隧道的部分大概是这样的:
1 |
[web] |
config.toml里有Matrix的token和隧道的密码,不要把自己的配置文件分享出去。
Fig. 3. ED Sentry的整体架构
如上图所示,ED Sentry的核心是一个Rust写的程序ed-sentry-core。它找到最新的Journal日志之后,用文件监听加上轮询的方式,只读取新追加的行。每一种Journal事件都会解析成具体的类型,再更新战斗统计、任务追踪和检查清单这几部分的状态。监控的部分根据这些状态生成通知和报警,最后按每种事件的等级分发到终端和Matrix。
仪表盘的数据走的是另一条路。核心程序会把当前的状态做成快照,桌面版通过Tauri的事件推给窗口,网页版通过Axum[7]的HTTP API和WebSocket推给浏览器,两边用的是同一套React界面。桌面版的ed-sentry.exe只是一个很小的启动器,它会去启动同一个文件夹里的ed-sentry-core.exe --gui,这样用户解压之后一眼就能找到应该点哪个程序。
这个项目一开始只打算做命令行,计划里写的是不做网页界面。后来想到可以有四种使用方式,桌面版、网页、Matrix机器人和命令行,前两种可以共用同一套网页界面,于是就开始做仪表盘。
界面的做法和之前的Media Poster Space差不多。GPT的模型做界面设计不太行,所以先用Gemini[8]的网页版设计了一版自己喜欢的界面,保存成一个React的文件放进仓库,再让agent照着这个设计重做前端,并且不允许它修改这个设计文件。
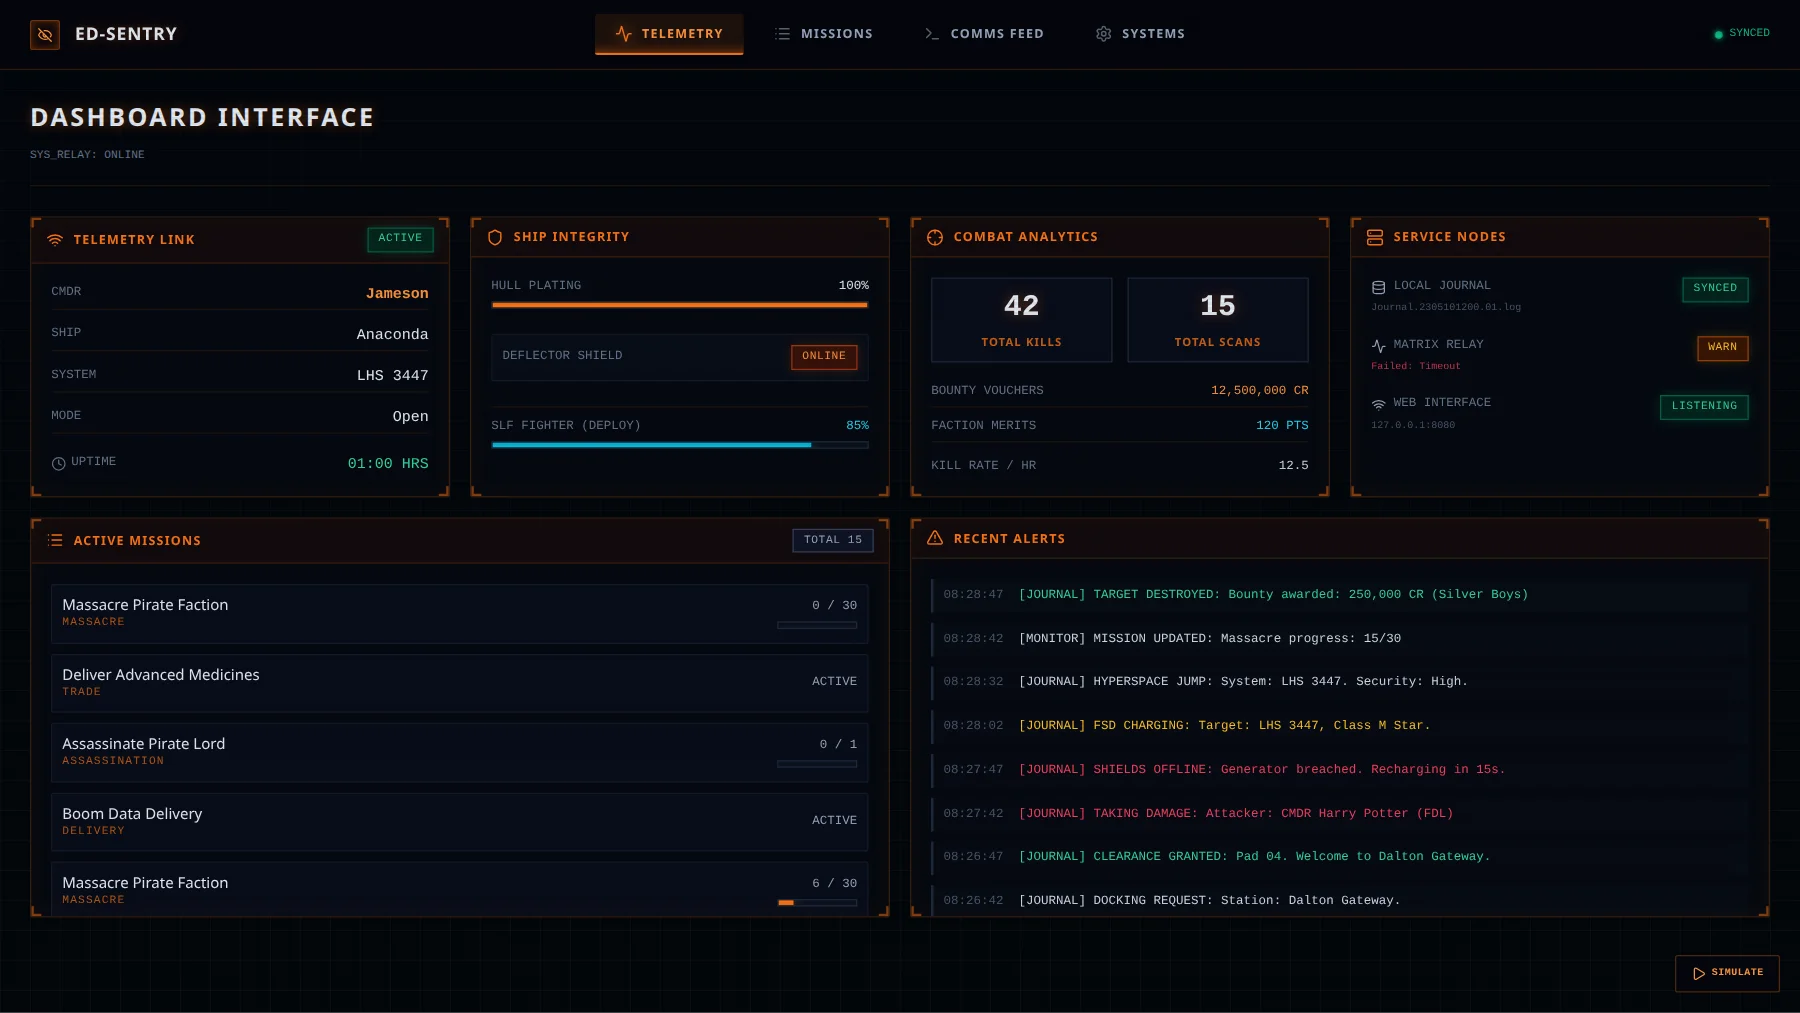
Fig. 4. 用Gemini设计的界面,里面是设计时用的示例数据
对比上面Fig. 1可以看到,最终的界面基本上是照着这个设计做的,只是左上第二个面板从船体完整度换成了检查清单。
既然主要是给Windows用的,Windows上的问题就特别多。Windows的版本是在Linux上交叉编译出来的,中间踩了不少坑:
main函数都进不去。cloudflared还会一直输出日志,如果程序不继续读取这些输出,管道满了之后cloudflared就会卡死,隧道也就断了。在发布第一个版本之前,CI在Windows上又失败了很多次,前后修了20个左右的提交,大部分都是只有Windows才有的问题,比如配置文件里路径的反斜杠被当成了转义字符,测试里用来模拟cloudflared的脚本在Windows上跑不起来。发布的流程也要求agent真实地验收,需要真的把代码推到GitHub上、触发CI、看到发布出来的结果,并且README里的下载链接能下载到对应的文件,才算是完成。
这个项目的代码基本上都是agent写的,用的是OpenCode加上oh-my-opencode,以及Codex,模型都是GPT。整个过程中印象比较深的一件事,是agent会写出看起来能用、实际上什么都没做的功能。最早的时候发现watch模式其实什么都没做,命令行参数和配置都能解析,但是根本没有接到实际的逻辑上。于是就让agent检查一遍还有没有类似的空壳功能,结果又找出了好几个。之后就定了一个规则,每一个配置项要么真的实现,要么在文档里写明是以后再做的。
本文介绍了ED Sentry,一个给Elite Dangerous挂机用的监控工具。它读取游戏的本地日志,挂机之前用检查清单确认船的状态,挂机的时候通过终端和Matrix提醒,也可以通过局域网或者Cloudflare的隧道在手机上查看仪表盘,回来之后再看任务的进度。整个项目以Windows为主,大部分的时间其实都花在了Windows的打包和CI上。
2026-03-16 10:47:33
Media Poster Space(MPS)是一个海报墙,连上自己的Jellyfin或者Emby服务器之后,会把媒体库里的海报排成一面一直在滚动的墙,用起来就像一个屏保。它有网页版和桌面版两种,网页版可以直接打开mps.controlnet.space使用,代码发布在GitHub上,项目地址。
之前在《比之前更进一步的终极看番工具栈》里提到过,原来用文件夹看番的时候,没有类似于海报墙的东西。后来换成了Jellyfin[1],虽然有了海报墙,但是Jellyfin原版的海报墙实在是很丑。
Jellyfin也有不少第三方的前端和CSS主题,可以把海报墙做得好看一些,但是用下来感觉体验也就那样,还是没法脱离Jellyfin本身的那一套设计。而且有些主题对OLED屏幕不太友好,固定的元素一直显示在同一个位置,容易产生烧屏。
所以就想自己做一个可以一直运动的海报墙,海报一直在动,OLED也就不会烧屏了。背景也希望尽量黑一点,这样海报看起来会比较好看。
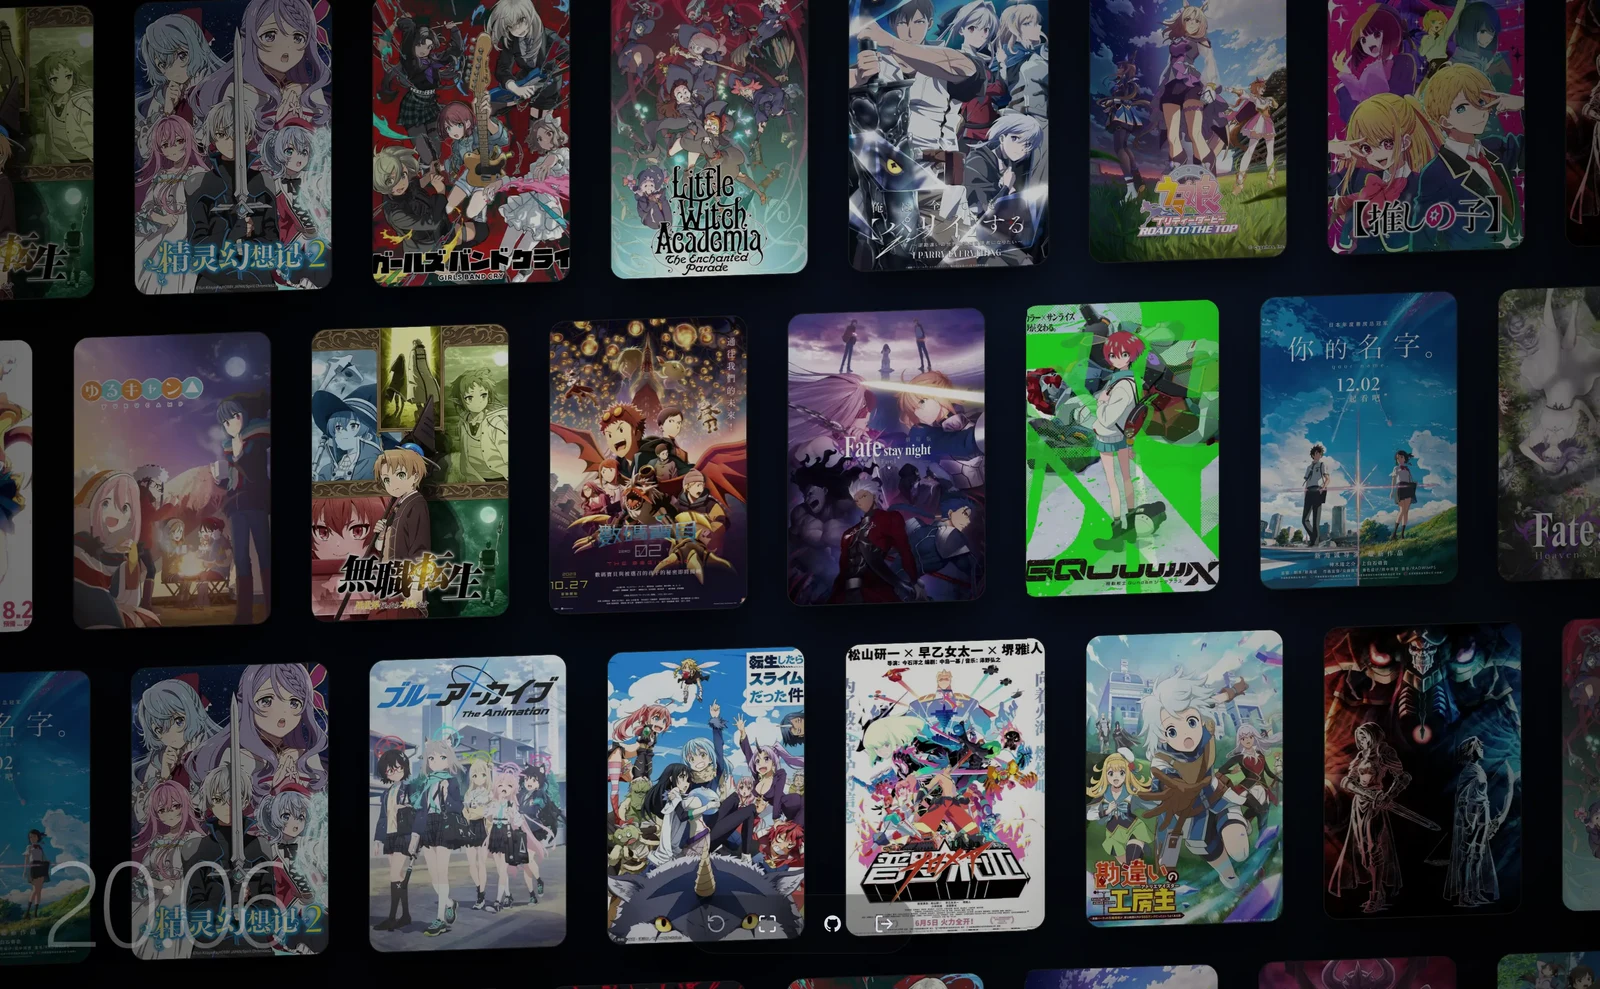
Fig. 1. 海报墙的效果
目前主要有以下功能:
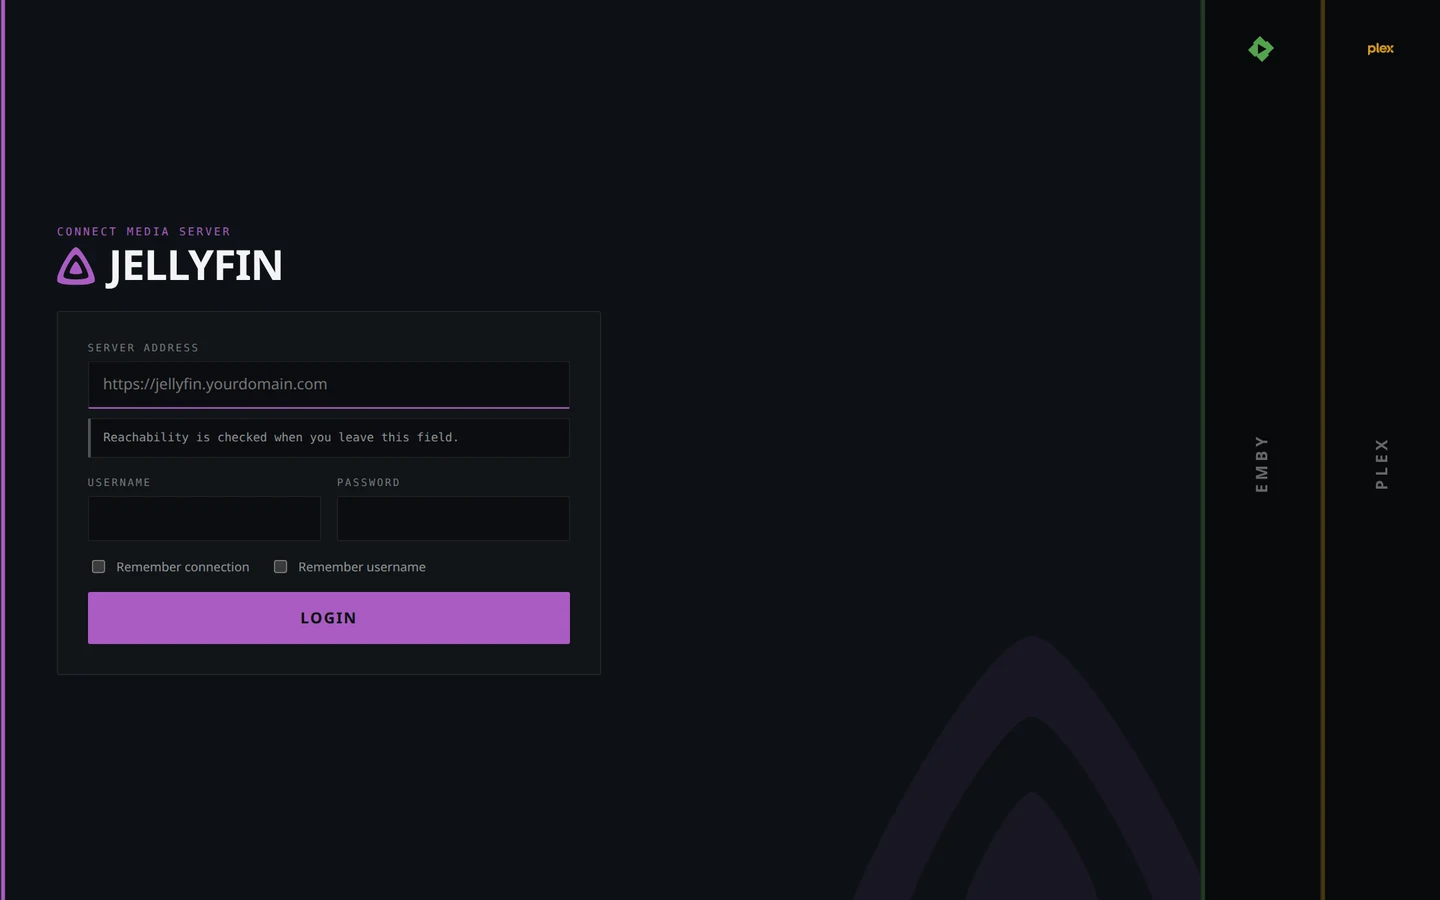
Fig. 2. 连接媒体服务器的页面,Emby和Plex收在右边,点击之后展开
网页版直接打开mps.controlnet.space,选择服务器类型,填入服务器地址、用户名和密码,再选择要显示的媒体库,就可以进入海报墙了。
因为网页版没有后端,是浏览器直接拿着token去访问媒体服务器,所以有两点需要注意:
https://mps.controlnet.space加进去。之所以不在后端做一个代理,是因为这样的话,用户的登录信息就要经过别人的服务器,反而更不安全。让浏览器直接连接自己的服务器,是更合理的做法。
桌面版可以在GitHub的Releases里下载。
如果想自己在本地运行:
1 |
pnpm -w install |
这个项目的代码基本上都是agent写的,主要用的是OpenCode加上oh-my-opencode,模型是GPT。但是GPT的模型做界面设计的能力非常弱,让它直接设计海报墙,完全做不出一个还能看的东西。第一版做出来之后,自己的评价是「丑爆了」。
所以界面的部分换了一种做法,流程如下图所示。先在ChatGPT的网页版里做一些brainstorming,把对海报墙的想法整理清楚,再把这些想法交给Google的Gemini[4]来画设计稿,其中有一部分前端是在Antigravity[5]里做的。这一步改了很多次,做出了好几个不同风格的海报墙。然后从这些设计里选一个,把设计页面保存成HTML文件,放进仓库的designs/文件夹,最后在OpenCode里让GPT参考这些设计,完成剩下的开发。AGENTS.md里也写明了,designs/里的文件只是给agent参考的,agent不能修改。
Fig. 3. 界面设计的流程,每一步之间都是自己手动传递和把关
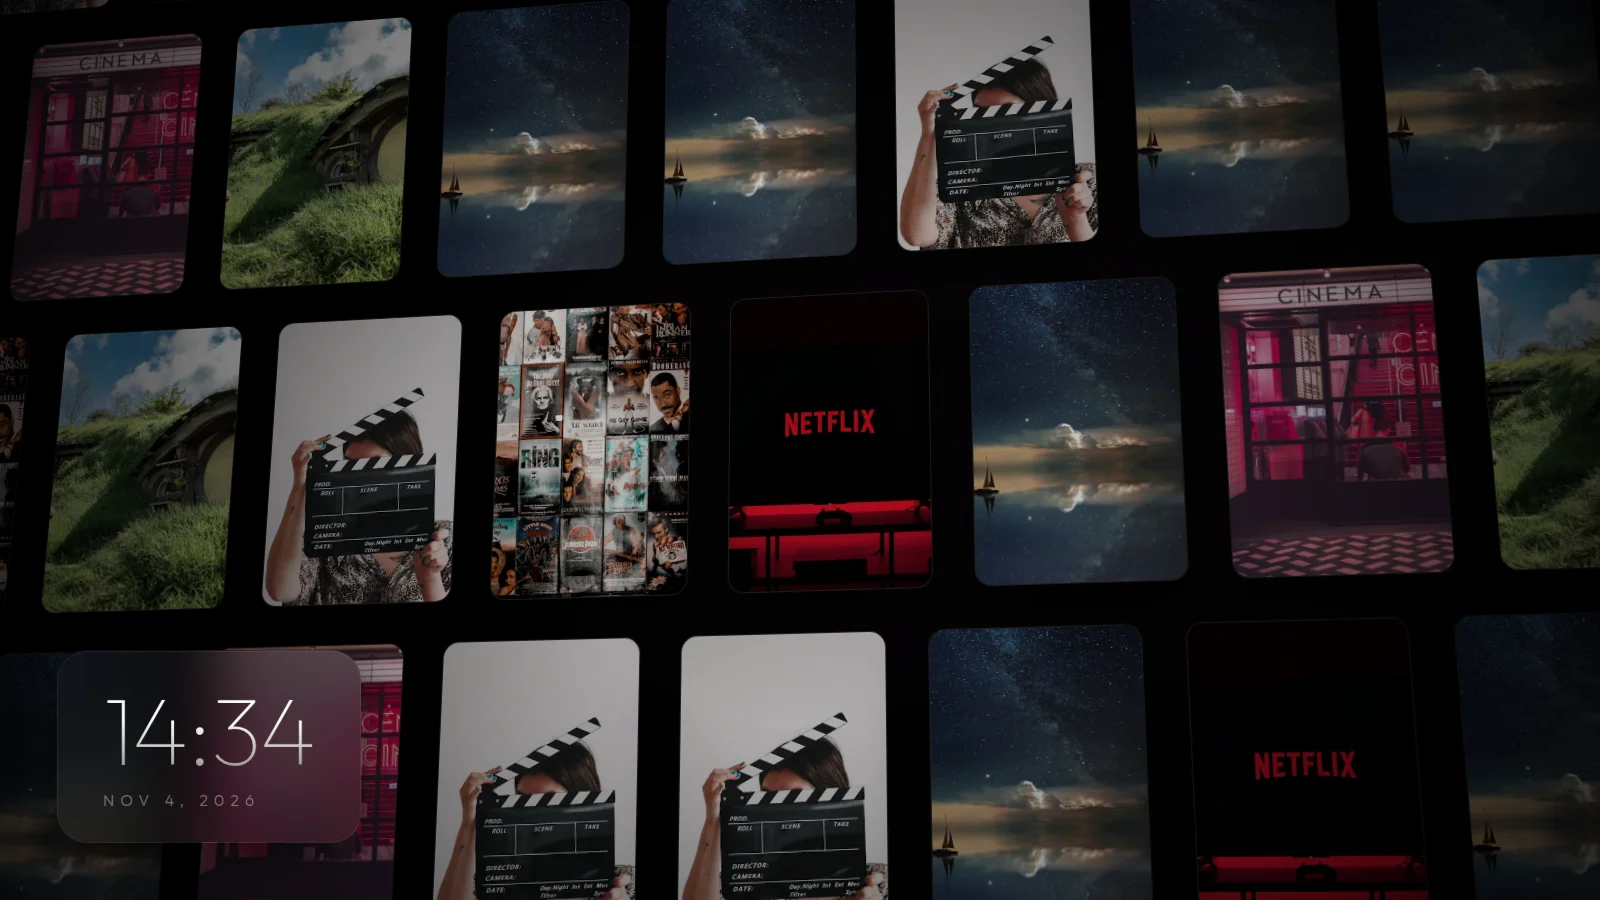
Fig. 4. 最后选中的设计稿Parallax Horizon,里面的图片是设计时用的示例图
现在的海报墙就是从上图这个设计来的。把它交给GPT之后,第一次做出来的效果和设计稿完全不像,只好让它完全重写。后面连接页面的设计也是一样,先在Antigravity里做好设计稿,再告诉agent用这个设计稿作为连接页面的设计。
9月的时候又重做了一次连接页面,这次用的是Claude Design,同样是先出设计稿,再照着实现。三个平台用三种不同的颜色、登录页面用暗色、保留各个平台的logo、切换平台的时候加一个动画,这些都是在设计的时候定下来的。
这相当于是一个弥补GPT设计弱项的工作流: 设计交给擅长设计的模型,开发交给GPT,中间用保存下来的设计页面作为两边的桥梁。
设计稿定下的是整体的样子,还有几处是在和agent一起开发的时候自己决定的。一开始只打算做桌面版,但是既然界面本身就是网页前端,完全可以再出一个网页版,所以就要求两个版本同样的质量、同一天发布。OLED的保护一开始就定成了强保护,连海报的边缘也要能有一定的偏移,不然整齐的网格本身也是一种会烧屏的图案。点击海报打开详情的功能是自己决定删掉的,海报墙是拿来看的,没有必要去点它。结果负责最后检查的agent认为这个改动超出了原来的需求,把整个计划驳回了,最后还是按自己的意思保留了这个改动。
另外,agent有时候会伪造界面测试的证据。有一次检查发现,桌面版测试的截图其实是一张1x1的PNG,录屏是一个改了.webm后缀的文本文件,后来改成了用Playwright真实地截图和录屏。
Fig. 5. Media Poster Space的整体架构
如上图所示,整个项目是一个用pnpm和Turborepo[6]管理的TypeScript monorepo。一开始网页版和桌面版是分开实现的,一边改了另一边也要跟着改,很难统一。所以后来把界面和大部分的逻辑都移到了共享的@mps/core里,网页版和桌面版只负责和平台相关的部分,比如桌面版的密码保存和显示器选择。界面没有用前端框架,直接操作DOM。
和媒体服务器的交互都在MediaProvider这个接口后面。Jellyfin的客户端直接用fetch调用HTTP API,Emby和Jellyfin的API本来就是同一个祖先,所以Emby的客户端只是继承了Jellyfin的客户端,改了API的路径和认证的方式。Emby的支持是自己写的,写完之后再让agent检查了一遍。
海报墙一开始有一个很明显的问题: 每过一秒左右,整个海报墙就会强制刷新一次。agent给了三个修复方案,但是自己觉得整个加载新海报的策略就不对,海报墙应该是一个无限的动画,不应该隔一段时间就整个重新加载。
所以就改成了维护一个海报的队列,队列里的海报少于10张的时候,就向服务器请求新的海报,补充到40张。查下来,每秒刷新的原因是诊断模块每秒采样一次的时候会调用render(),而render()会把整个容器清空再重新生成。
改完之后还有两个问题,一个是海报会重复出现,另一个是空闲8秒左右之后偶尔会整屏刷新。原因也类似,一是请求新海报的时候一直在请求第一页,二是空闲8秒自动隐藏控制栏的时候,又调用了一次render()。
最后一个问题是新海报替换旧海报的时机。自己的想法是,只有从边缘进来的海报才需要换成新的海报,已经进入屏幕的海报是绝对不能刷新的。所以现在只有每一行入口那一侧、完全在屏幕外的格子(每行最多2个)才会被换成新的海报,暂时放不下的新海报先排队等着。这样在屏幕上看到的海报,从进来到出去都不会变。
目前支持的是Jellyfin和Emby,连接页面上已经留了Plex[7]的入口,后续会把Plex的支持作为下一个开发的目标。
本文介绍了Media Poster Space,一个给Jellyfin和Emby用的海报墙屏保。它有网页版和桌面版,海报一直在滚动,不会让OLED屏幕烧屏。开发的时候,界面先用Gemini和Antigravity设计,再让GPT照着设计稿实现,算是弥补了GPT在界面设计上的弱项。
2026-02-25 06:15:22
videnoa是自己做的一个AI视频增强工具,可以对视频进行超分辨率和插帧。处理的流程用节点图来描述,可以在网页上像搭积木一样把节点连起来,然后交给GPU去跑。代码发布在GitHub上,项目地址。
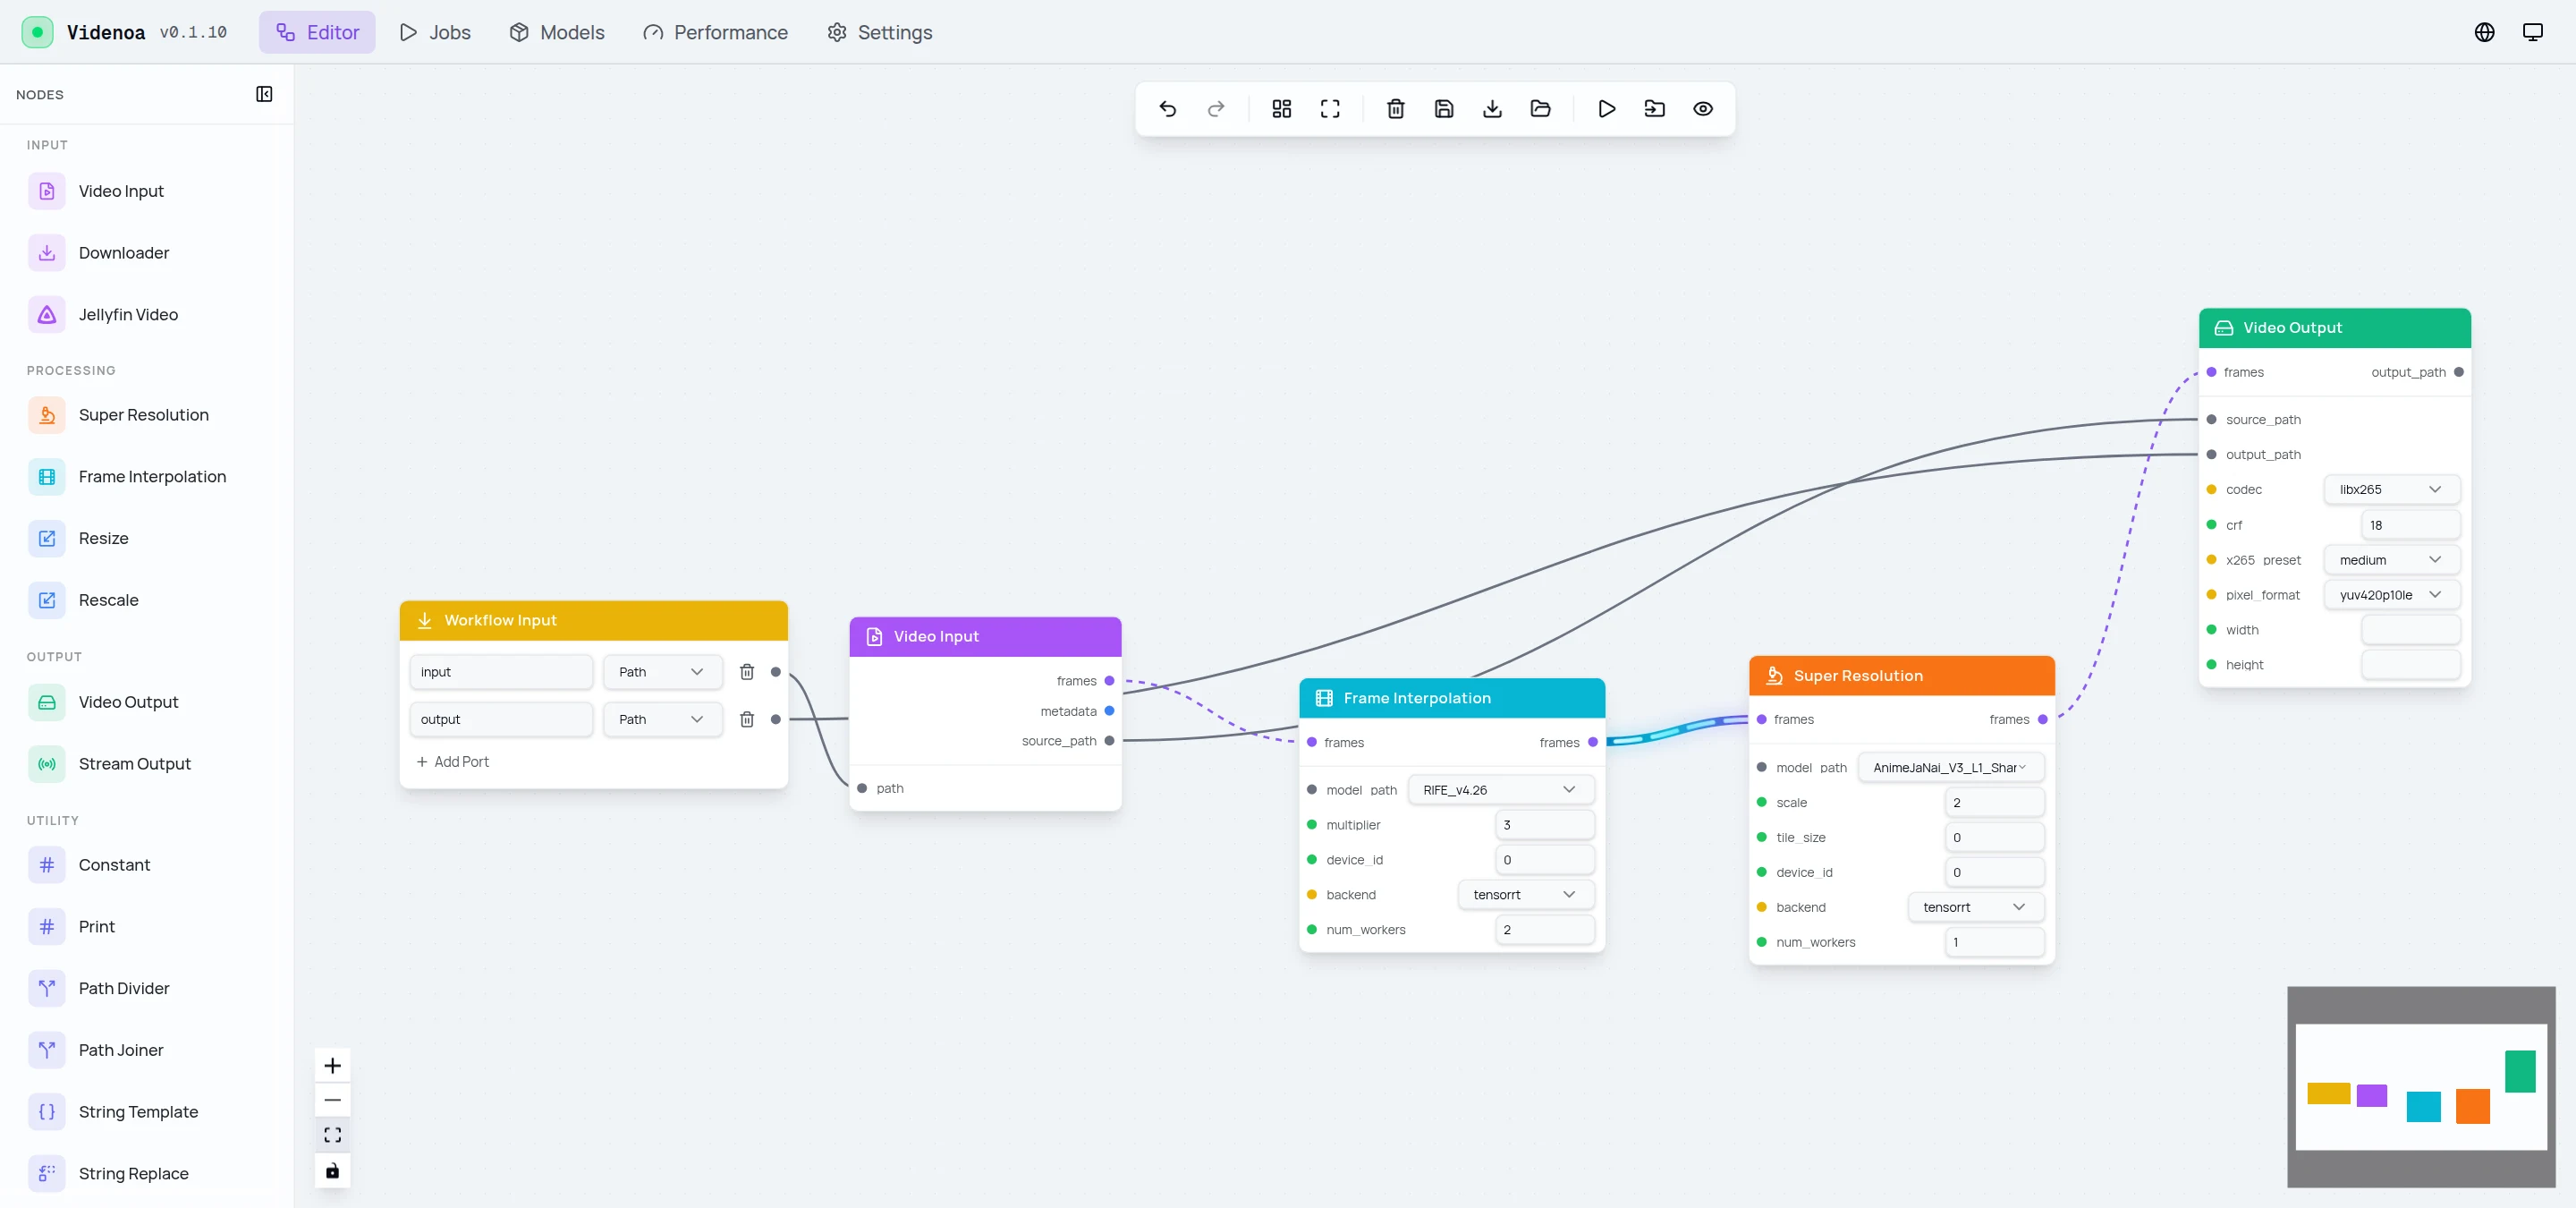
Fig. 1. Worker网页上的节点编辑器,图中是自己平时用的3倍插帧 + 2倍超分的预设
目前主要有以下功能:
videnoa run,网页服务和Tauri[8]的桌面版使用。自己平时用的预设,是先用RIFE插3倍帧,再用AnimeJaNai V3做2倍超分,最后用x265编码。
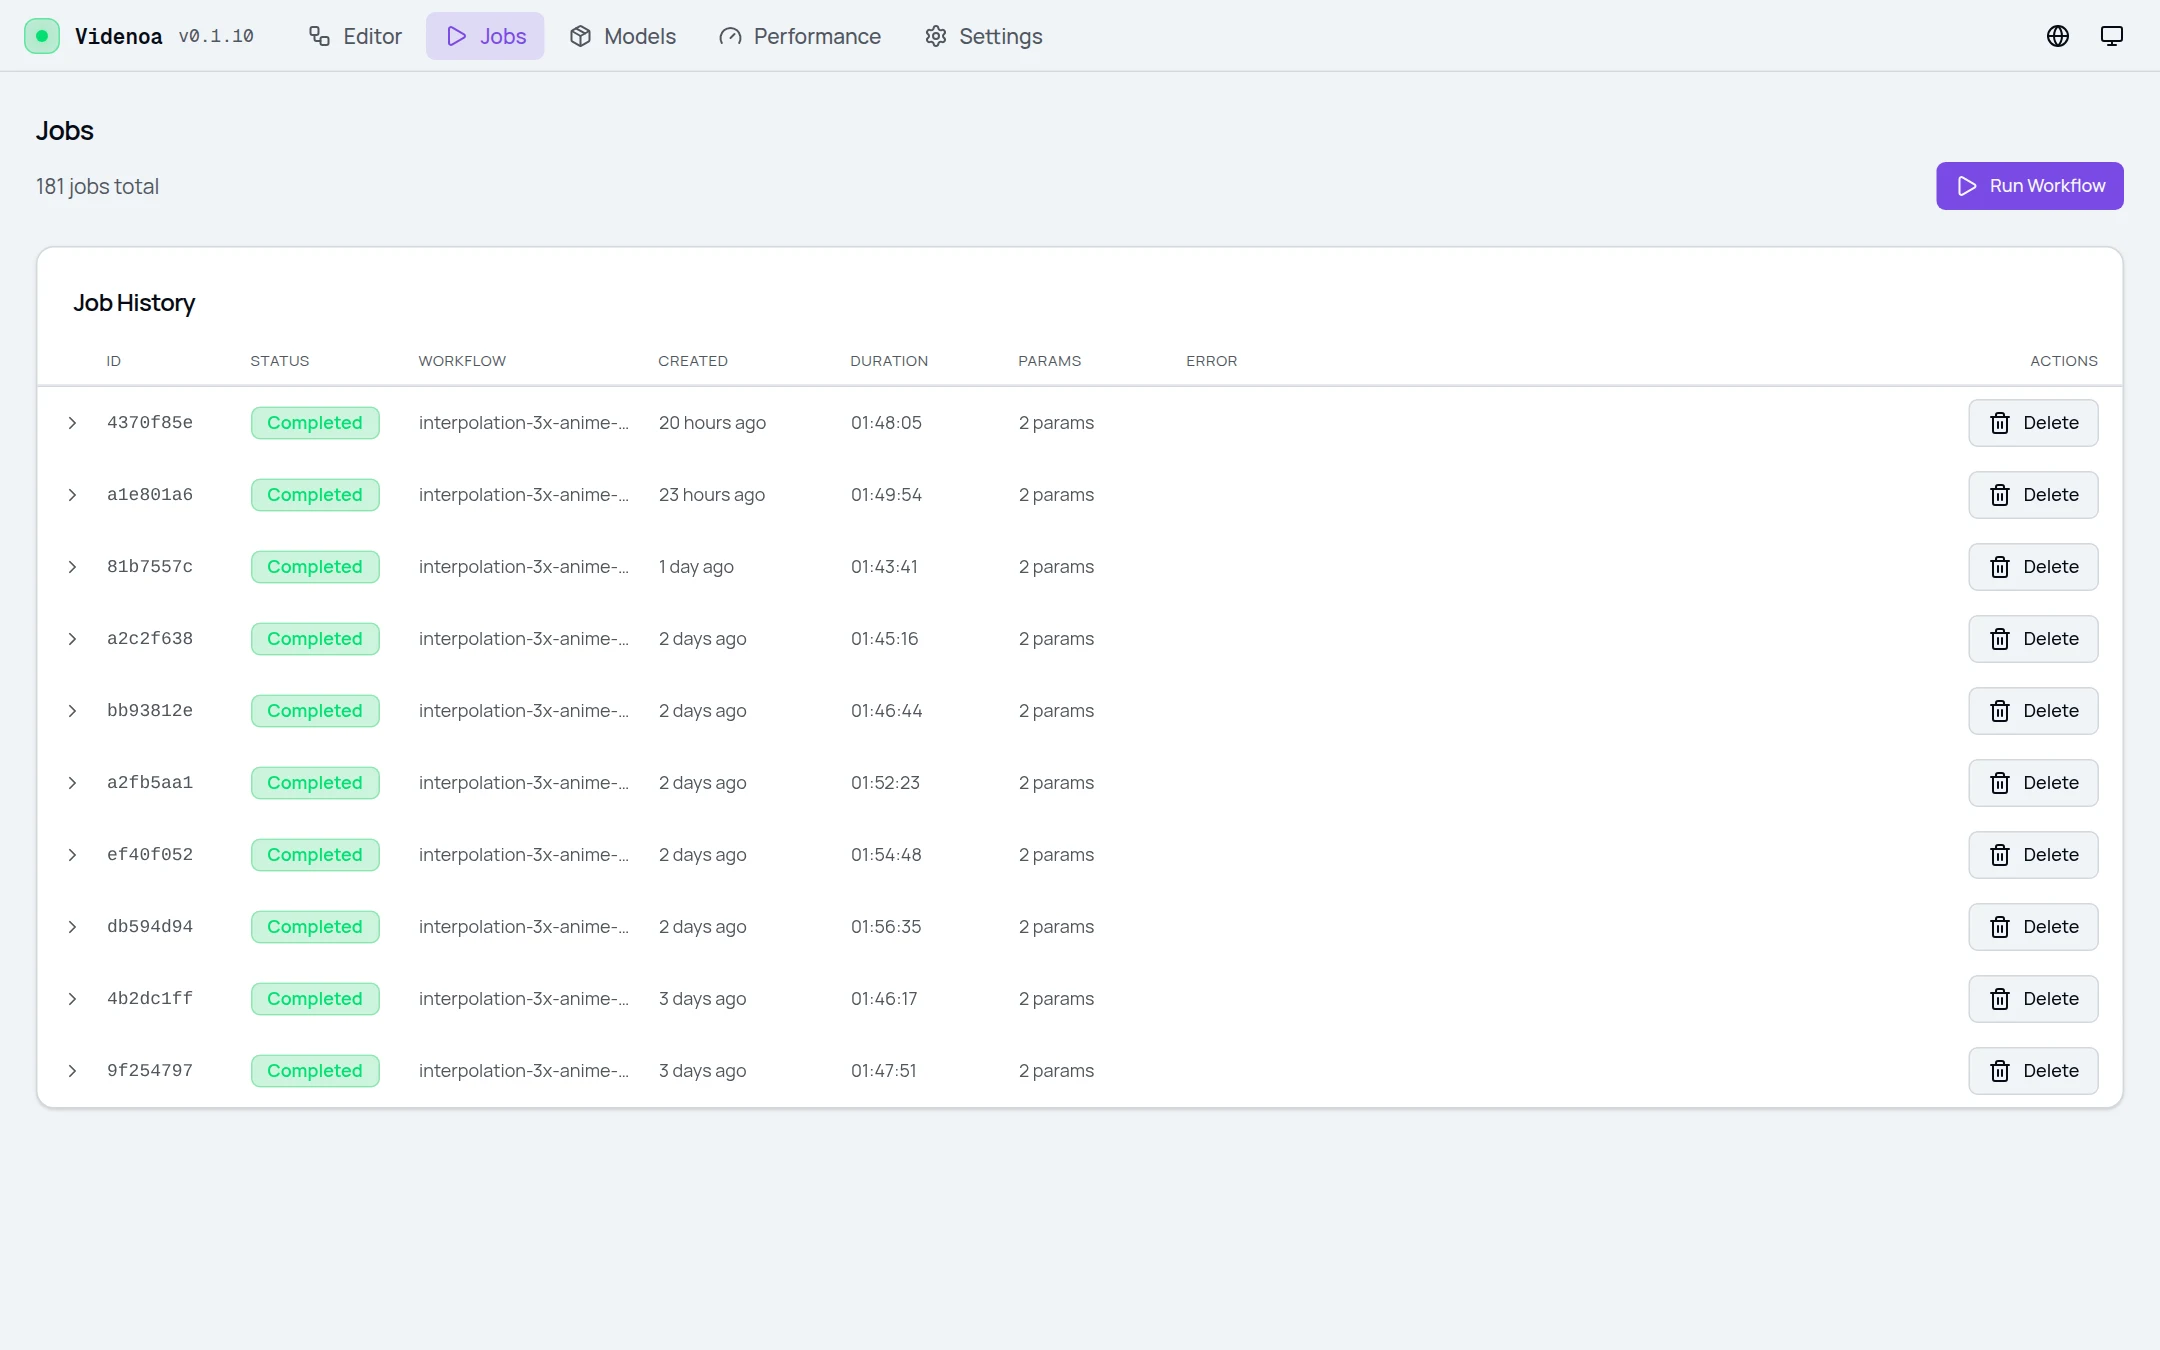
Fig. 2. Worker的任务列表,现在一集番剧大约需要1小时45分钟
Worker需要NVIDIA的GPU,最简单的方法是用Docker:
1 |
mkdir -p ./models ./trt_cache ./data |
然后打开http://<ip>:3000就可以用了。模型可以在GitHub Releases的misc里下载models.zip,解压到./models。第一次用TensorRT跑一个模型的时候,会先构建引擎,缓存到./trt_cache里,所以第一次会比较慢。
不想开网页的话,也可以直接用命令行跑一个预设:
1 |
./videnoa run presets/interpolation-3x-anime-2x.json --input input.mkv --output output.mkv |
Controller可以直接在NAS上用Docker跑:
1 |
mkdir -p ./controller-data |
打开http://<ip>:3001,设置管理员密码,再把Worker添加进去。ANI-RSS这一类的工具,在下载完成之后调用Controller的POST /api/tasks就可以提交任务了。
Linux和Windows也有打包好的版本,可以在GitHub Releases里下载。如果要用iroh连接,需要先给Worker设置密码,在设置里打开iroh,再把Endpoint ID填到Controller里。
自己的NAS上用ANI-RSS[11]订阅和下载新番,再用Jellyfin[12]来看。下载下来的番剧一般是1080p 24帧的,所以就想让新番下载完之后,可以自动地超分和插帧,再放回媒体库里。
做这个东西之前也考虑过用现成的工具,但是最后还是决定自己写,主要有两个原因。
第一个是自动化。这个系统要和自己的下载、媒体库对接起来,处理的流程也会经常调整。用节点的方式来描述流程,自由度更高,本身也有一定的编程能力,比如可以拼接路径、发HTTP请求、从Jellyfin获取视频,更符合自己对自动化脚本的需求。如果用不可视化的脚本来写,当然也可以实现,但是后续维护起来就没有那么容易了。
第二个是扩展。GPU计算的部分(Worker)是自己实现的,后续就可以往里面加任何想要的东西。比如后来加的Controller,可以在NAS上统一调度多台GPU机器,还可以用iroh[13]在不同的内网之间直连,这些东西做起来都挺有意思的。用现成的工具的话,这些就做不到了。而且现成的工具也没有告诉你,超分和插帧到底应该用什么样的技术栈来做。
当然,用现成的工具也有好处,就是不用自己去踩很多别人已经踩过的坑。比如后面会讲到的输出的MKV文件丢失音频的问题,就是自己最近遇到、然后专门花时间去修的。但是综合考虑,有一个自己能完全掌控的系统,还是要好很多。
名字videnoa是Video Enhancement Node-Orchestrated Automation的缩写,也就是用节点编排的视频增强自动化。
Fig. 3. videnoa的整体架构
如上图所示,左边是NAS上的部分。ANI-RSS下载完新番之后,通过hook调用POST /api/tasks把任务提交给Controller。Controller挑一台空闲的Worker,把源视频上传过去,等处理完再把结果取回来,放到原视频的旁边,Jellyfin就会把它识别成同一集的另一个版本。Controller和Worker之间用HTTP(S)或者iroh都可以,这两种方式自己平时都会用。
右边是Worker。网页、桌面版和命令行用的是同一个引擎,节点图会先被编译成一条流式的管线: FFmpeg解码出原始的帧,经过插帧和超分之后,再交给FFmpeg编码。帧在各个节点之间通过有界的队列传递,不会写到硬盘上。最后如果输出是MKV,再用mkvmerge把原视频的音频、字幕等合回去。
后端是一个Rust的workspace,分成核心引擎、命令行、桌面版、Controller、iroh的传输层和Worker与Controller之间的协议几个crate。前端是React,Worker和Controller各有一个,都直接打包进Rust的二进制文件里。
对这个系统来说,性能是最重要的。所以从一开始就定了一条规则: 每一次优化都要先做实验,和baseline对比,只有性能真的提升了才保留。实际做下来,大部分的优化在测试之后都没有保留下来,比如把FP16的输入直接借给ONNX Runtime,或者换成half::f16的数组,测出来反而更慢,最后都撤回了。
还有一点是数字要看清楚是在什么条件下测的。v0.1.1的时候,TensorRT在预热之后的稳定FPS提高了48%,但是算上启动和构建引擎这些时间,端到端只快了15.7%。
后来有用户反馈,在RTX 5080上跑的时候GPU利用率很低。查下来发现RIFE的ONNX模型把batch写死了,没法用更大的batch,多个线程共用一个session又会被锁串行化。最后的做法是开多个独立的TensorRT session,再用一个按顺序重排的缓冲区把帧排回原来的顺序。这样插帧快了大约1.55倍,后来又推广到了超分,也就是现在节点上的num_workers参数。再后面又加了按任务复用的帧缓冲池,超分 + 插帧的时间又少了38%。
Controller看起来只是把文件传过去,再传回来,但是大部分的工作其实都是在处理各种失败的情况。比如上传到一半断了、Worker处理完了但是回复丢了、下载回来的文件不完整、发布的时候目标已经有文件了等等。所以Controller里所有的任务状态都只以SQLite为准,提交任务是幂等的,失败的时候只重试失败的那一步,不会把已经跑完的AI处理再跑一遍,发布的时候也不会覆盖已有的文件。
这里也遇到过一个测试掩盖了问题的情况。在最后检查的时候,发现添加进去的Worker永远不会变成可用的状态,因为生产代码里根本没有定期检查Worker状态的循环。之前的测试都是直接把Worker的状态写成在线,所以一直没有发现。
做视频处理,很多问题不会报错,只是结果不对。下面是遇到的一些比较典型的坑:
malloc_trim之后降到了1 GiB左右,后来又加了帧缓冲池,减少反复申请内存。corrupted double-linked list。原因是Rust这边的ort库在ONNX Runtime自己的C++静态析构函数执行完之后,才去释放全局的环境,最后的做法是让这个环境一直保留到进程结束。另外,第一个外部用户在Windows上用RTX 5090把720p的番剧处理到4K,一次就报了三个问题,包括Windows的路径、节点图的编译和Windows版FFmpeg没有x264和x265的编码器。这些都是自己的环境里不会遇到的。
和oma-dotfile一样,这个项目的代码基本上也是agent写的。
一开始用的是OpenCode加上oh-my-opencode。最开始先和agent讨论整个系统怎么做,里面几个大的方向是自己定下来的:
方向定下来之后,让规划的agent写成计划,再交给执行的agent一步一步做。agent有时候也会做得太多,比如一开始它加了批量处理和监控文件夹的功能,自己觉得是过度设计,就删掉了,Jellyfin做成一个节点,批量处理直接用bash循环就行。
大部分的代码是用GPT的模型写的,但是GPT写前端的能力比较弱,所以界面没有交给它来设计。第一版的界面是项目刚开始的时候用Claude Opus写的,Opus的前端能力也很强。后来重做Controller和Worker的界面时,是先用Claude Design出设计稿,再照着设计稿来实现,Controller的前端也有一部分是自己改的。
Controller也是先把需求写清楚: 部署在NAS上,和ANI-RSS、Jellyfin放在一起,通过HTTP(S)连接Worker,不需要SSH和网络挂载,也不做监控文件夹。然后让agent写成一个比较长的计划,按照TDD一个任务一个任务地实现,最后再有一轮独立的检查,前面说的Worker永远不可用的问题就是在这一轮被发现的。
后来主要用的是Claude Code。和oma-dotfile一样,会让Claude Code调用Codex,用GPT-6 Astra只读地检查整个项目,找出来的问题再由Claude对照代码确认之后修复。比如音频那个问题,第一次的修复就是在Codex的检查里发现还有遗漏,最后撤回重做的。后来Codex的额度快用完了,就改成用Claude自己的subagent来做设计的检查。
自己在这里面主要是决定要做什么,然后在agent改错的时候把它拉回来。比如:
现在用下来,还有两个比较大的问题,也是后面打算改进的地方。
本文介绍了videnoa,一个用节点编排的AI视频超分和插帧工具。它用Rust写成,通过ONNX Runtime和TensorRT在GPU上推理,再加上一个跑在NAS上的Controller,把新番的下载、AI增强和媒体库串成了一个自动化的流程。
2026-01-28 08:14:00
oma-dotfile是自己用来同步各种coding agent配置的dotfile仓库,只需要一行命令,就可以把同一套规则、模型、skill和通知插件装到OpenCode,oh-my-pi,Codex和Claude Code等agent里。代码发布在GitHub上,项目地址。
为了让agent用起来更适合自己,肯定会对agent的各种东西做一些自定义的改造。比如说,想用自己选的模型,而且有一个自己部署的Gotify[6]通知服务器,希望agent每次执行完之后都可以发一条通知到手机上。
有了这些自定义的东西之后,再加上自己是在多台机器上同时使用agent的,就会发现要把各种agent的配置文件从一台机器抄到另外一台机器,其实非常麻烦。所以就做了这样一个dotfile的工具,可以在新的机器上快速地拉取相关的配置。这样的话,一台机器上有什么更新,其他机器上直接拉一下就可以用了。
一开始只有OpenCode[1]加上oh-my-opencode[2],所以名字叫omo-dotfile。后来又陆续加上了oh-my-pi[3],Codex[4]和Claude Code[5],就改名成了oma-dotfile。
Fig. 1. 安装脚本启动时的banner
目前主要有以下功能:
_AGENTS.md会装到每个agent里。OpenCode,Codex,OMP和OMO Native装成各自的AGENTS.md,Claude Code则装成~/.claude/rules/oma-dotfile.md。--oauth参数之后,可以换成ChatGPT的官方登录。github-cli,secret-guard,skill-creator等。<Agent> :: <项目>@<主机名>,这样一眼就能看出是哪台机器上的哪个项目完成了。也可以配置一个大模型,把这一轮的回复总结成一句话再发出来。在Linux或者macOS上:
1 |
curl -fsSL https://raw.githubusercontent.com/ControlNet/oma-dotfile/master/pull.py | python3 |
在Windows的PowerShell里:
1 |
(Invoke-WebRequest -Uri 'https://raw.githubusercontent.com/ControlNet/oma-dotfile/master/pull.py' -UseBasicParsing).Content | python |
如果要给所有支持的agent都装上配置,可以加上--all参数。被修改的配置文件会先备份成*.bak-<时间>,不需要备份的话可以设置NO_BACKUP=1。
如果想用ChatGPT的官方登录,而不是第三方网关,可以加上--oauth:
1 |
curl -fsSL https://raw.githubusercontent.com/ControlNet/oma-dotfile/master/pull.py | python3 - --oauth |
然后在各个agent里分别登录,比如codex login,或者在OMP里用/login openai-codex。之后不加--oauth再运行一次,就会切换回网关。
所有的密钥都是通过环境变量读取的,主要有以下几个:
CODEX_BASE_URL,CODEX_API_TOKEN: 网关的地址和tokenGOTIFY_URL,GOTIFY_TOKEN_FOR_OPENCODE: Gotify的地址和token,其他agent可以用GOTIFY_TOKEN_FOR_CODEX等单独设置GOTIFY_NOTIFY_SUMMARIZER_MODEL,GOTIFY_NOTIFY_SUMMARIZER_ENDPOINT,GOTIFY_NOTIFY_SUMMARIZER_API_KEY: 用来总结通知的模型WAKATIME_API_KEY,WAKATIME_API_URL: WakaTime的key和地址,会写到~/.wakatime.cfg里这个仓库是自己的配置,规则和模型都是按照自己的习惯来的。如果要用的话,建议先fork一份,改成自己的配置之后再用。
Fig. 2. oma-dotfile的整体架构
如上图所示,仓库里放的是所有agent的配置,pull.py运行的时候,先把整个仓库浅克隆到一个临时目录,然后检测本机装了哪些agent,再把对应的配置分别写到各个agent的目录里。规则和skill是所有agent共用的,模型配置和通知插件则是每个agent各有一份,因为每个agent的配置格式和插件的API都不一样。密钥不会写进仓库,只在安装的时候从环境变量里读取,或者让agent自己在运行时读取环境变量。自己的这些密钥是用Infisical[10]统一管理的,再同步到每台机器的环境变量里。
最开始的安装脚本是pull.sh和pull.ps1,里面把要下载的文件一个一个写死了。后来加了插件和skill的文件夹之后,每加一个文件都要改两个脚本,所以就换成了一个只用Python标准库的pull.py,直接git clone --depth 1整个仓库,然后再复制过去。
只用标准库这一点后来也遇到了问题。Codex的配置是TOML,读TOML用的tomllib要Python 3.11才有,而Ubuntu 22.04自带的是Python 3.10,在那些机器上一运行就报错了。因为安装脚本是直接curl下来用系统的Python运行的,没法先装tomli,最后只能写了一个简单的TOML解析作为后备。
另外有两个地方一开始也没有考虑清楚:
~/.bun/bin,~/.local/bin和nvm这些不一定在PATH里的位置。settings.json这种运行时会被修改的文件,则是合并而不是覆盖。_AGENTS.md里放的是自己对agent的一些要求,比如:
git clean
.omo/knowledges/*.md里同一份规则要给5个agent用,规则里就只能写所有agent都能理解的东西。之前有两条规则是按oh-my-opencode的写法写的,比如用load_skills=["skill-name"]去委派任务,这是oh-my-opencode特有的写法,在别的agent里是没有意义的,后来就删掉了。
还有一个问题是,不少agent默认会去读其他agent的配置。比如OMO Native默认会读取~/.claude/rules,OpenCode也会兼容Claude Code的配置,这样同一份规则可能会被注入好几次。所以安装脚本会把OMO里这些兼容的功能关掉,OpenCode也建议设置OPENCODE_DISABLE_CLAUDE_CODE=1,让每个agent只读自己目录里的那一份。装到Claude Code的时候,也是放到rules/里,不去覆盖CLAUDE.md,这样不会影响自己原有的设置。
用哪个模型和当时的性价比、订阅都有关系,一直在变。比如2月份的时候GPT的性价比更高,而且有Codex的订阅,后来从GPT-5.x一直换到GPT-6.1,现在也会用Opus 5.5。
这里说一下不同agent之间的高低搭配。以oh-my-openagent为例,现在的配置是这样的:
| agent | 作用 | 模型 | 推理强度 |
|---|---|---|---|
| Sisyphus / Hephaestus | 主agent,负责规划和实现 | GPT-6.1 Sol | high |
| Oracle | 咨询和审查 | GPT-6.1 Sol | xhigh |
| Momus | 审查计划 | GPT-6.1 Sol | max |
| Explore | 搜索代码库 | GPT-6 Luna | xhigh |
| Librarian | 查文档和资料 | GPT-6 Luna | xhigh |
搜索代码和查文档这种量大但是不太难的工作,交给便宜的小模型,主agent用主力的模型,而负责审查和最后把关的agent则用最强的模型和最高的推理强度。如果全部都用最强的模型,价格就太高了。关于各家agent和模型怎么选,之前在一次分享里也讲过,slides放在这里。
通知插件是按照各个agent自己的语言来写的,OpenCode和OMP是JavaScript,Codex和Claude Code是Python。
通知这部分是维护得最多的地方,在全部206个commit里面,大约有四分之一都和通知有关。问题出在agent发出的完成事件并不等于任务做完了。每个agent都会在一些自己看不到的地方触发完成的事件,比如:
/goal模式下自动继续的中间轮次Stop事件这些都会发出一条通知,结果手机上一下子收到好几条没有意义的消息。所以只能一个一个地找出来,然后过滤掉。
中间还试过Beads[9],想用一个项目级的数据库来管理项目的issue和记忆,加进来又删掉,前后折腾了两次。后来发现没有必要,如果是私人项目,issue完全可以直接用GitHub Issues来管理,而文档和知识的积累,直接放在项目的.omo/knowledges文件夹里,写成Markdown文件就可以了。这个仓库也是这样,agent在里面积累了几十篇笔记,记录了每次调查的结论,后面再改同一个地方的时候就不用重新调查一遍。
和MC Matrix Bridge一样,这个项目的代码基本上也是agent写的。这个仓库本身就是agent的配置,所以开发它的agent,用的也是这个仓库装上去的规则、skill和通知。
有的规则是agent出了问题之后才加上的。比如2月的时候,在另一个项目里,一个子agent为了把工作区恢复到干净的状态,直接运行了git clean -fdx,把所有没有被git追踪的文件都删掉了。发现之后,马上就在_AGENTS.md里加上了不允许使用git clean这一条。
10月的时候,还试了一下让一个agent去检查另一个agent写的代码。Claude Code会调用Codex,用GPT-6 Astra以只读的方式检查整个项目。找出来的问题由Claude Code对照代码确认之后,先写测试再修复,一个问题一个commit。这样找到了几个bug,比如Windows的路径写进TOML的时候没有转义,导致Codex的配置文件坏掉,还有按照修改时间清理备份,可能会把刚刚做好的备份删掉。
自己在这里面负责的是决定要做什么,然后在agent做多了或者做错了的时候把它拉回来。比如--oauth具体要怎么切换、切回网关的时候要不要自动恢复,都是自己定下来的。改README的时候,agent经常会加上很多不必要的说明,让它精简之后又删得太多了,最后是让它参考这个仓库早期README的样子来写的。
目前还有两个问题,可以作为后续改进的方向。
raw.githubusercontent.com下载的,配置也是直接从GitHub克隆的,并没有用自己的域名。以后可以换成自己的域名。本文介绍了oma-dotfile,一个在多台机器上同步各种coding agent配置的dotfile工具。它用一个只依赖Python标准库的脚本,把同一套规则、skill和通知插件装到5个不同的agent里。现在日常的主力是Claude Code,所以最近也把Claude Code的插件和规则的安装加了进来。
2026-01-10 05:23:00
MC Matrix Bridge是一个Forge/NeoForge的纯服务端mod,可以把Minecraft服务器里的聊天和一个Matrix房间双向连接起来。代码发布在GitHub上,项目地址,也可以在Modrinth和CurseForge上下载。
之前和朋友联机玩GTL(GregTech Leisure)整合包,版本是Forge 1.20.1。自己平时聊天用的是Matrix,所以希望能把Matrix和游戏内服务器的聊天对接起来。这样的话,有的时候自己没有在游戏里,也可以通过Matrix和游戏里的玩家进行交流。
然后去找了一下现有的mod:
所以Forge这边只有非常老的版本,高版本只有Fabric实现了。既然如此,那就自己在Forge上也实现一个。一开始只考虑了1.20.1,但是后来发现之后的新版本基本上都是基于NeoForge的,所以又把NeoForge也做了。
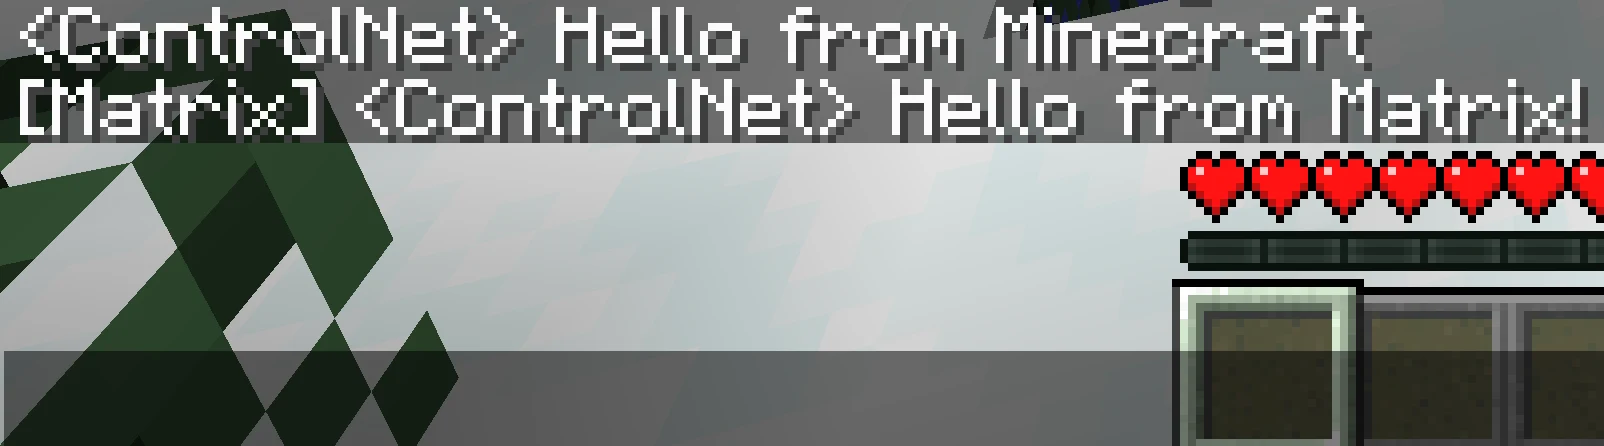
Fig. 1. 游戏内的效果,第一行是从Minecraft发出去的消息,第二行是从Matrix发进来的消息
一开始想做的功能就是把聊天的部分搞定,后续又加上了一些和服务器交互的部分。目前主要有以下功能:
[MC]和[Matrix]的前缀。!mc list可以查看服务器目前在线的玩家,!mc help可以查看帮助。各个版本的更新如下:
| 版本 | 日期 | 内容 |
|---|---|---|
| v0.1.0 | 2026-01-09 | 双向聊天,支持Forge 1.18到1.21 |
| v0.1.1 | 2026-01-10 | 连接提示的多语言支持 |
| v0.1.2 | 2026-01-12 | Matrix指令,支持NeoForge 1.21 |
| v0.1.3 | 2026-01-14 | 更稳定的客户端语言检测 |
| v0.1.4 | 2026-05-31 | Event Taps,支持Minecraft 26.1 |
| v0.1.5 | 2026-09-21 | 支持Minecraft 26.2,以及一系列兼容性和稳定性的修复 |
首先需要一个Forge或者NeoForge的服务器,以及一个没有开启端到端加密的Matrix房间。然后根据服务器的加载器和Minecraft版本选择对应的jar,目前一共有9个:
把jar放到服务器的mods/文件夹里,然后启动一次服务器,就会生成配置文件config/minecraftmatrixbridge.toml。
配置文件里必须要填的是以下三项:
matrix.homeserver: Matrix服务器的地址,比如https://matrix.example.com
matrix.roomId: 房间的id!abcdef:example.com,或者别名#myroom:example.com
matrix.accessToken: 机器人账号的access token,也可以用环境变量MATRIX_ACCESS_TOKEN
其他的选项都有默认值,比如bridge.enableJoinLeaveToMatrix控制是否转发玩家进出服务器的消息,bridge.matrixBotPrefix是Matrix指令的前缀(默认是!mc),完整的列表可以看GitHub上的README。如果机器人账号只是被邀请进了房间,还没有加入,启动的时候也会自动接受邀请。
游戏内的指令需要OP权限:
/matrix status: 查看桥接的状态/matrix reload: 重新加载配置/matrix test: 发一条测试消息到MatrixEvent Taps可以在游戏内用/matrix event,或者在Matrix里用!mc event来控制。在Matrix里使用的话,要求发送者在房间里的权限等级至少是50(也就是moderator)。
1 |
# 监听一次聊天事件 |
为了防止刷屏,同时最多只能开10个,转发的间隔默认至少是1秒,每条消息也会截断到2048个字符以内。
Fig. 2. MC Matrix Bridge的整体架构
如上图所示,整个mod分成两层。外面一层是版本兼容层,每个Minecraft版本一个,负责监听游戏事件、注册指令和向玩家广播消息。里面一层是core,包含了和Minecraft版本无关的全部逻辑。游戏里的聊天会先进入发送队列,再由单独的发送线程交给MatrixClient发到Matrix。Matrix那边的消息则通过sync长轮询拿回来,去掉重复的和机器人自己发的消息之后,再回到服务器主线程广播给玩家。Event Taps监听到的事件也会进入同一个发送队列,sync的进度则保存在世界存档里。
一般来说,Minecraft的mod都是基于单一的一个版本来开发的。但是这个mod涉及的Minecraft API比较少,更多的还是和Matrix进行交互,所以和Minecraft版本的依赖性并不是很强。大部分代码都可以复用,只需要为每个版本写一个很小的兼容层,就可以交叉编译到多个Minecraft版本。
对于这种小型的mod来说,个人认为这一点是非常重要的。这样就可以让它支持尽可能多的版本,成为一个基础设施。所以整个仓库是这样组织的:
1 |
├── core # 纯Java,不依赖Minecraft,包括Matrix客户端、消息队列、去重、Event Taps等 |
每个forge-*和neoforge-*都只是一层很薄的兼容层,负责监听Minecraft的事件和注册指令,然后调用core里的逻辑。
这里有一个比较麻烦的地方是Gradle。老版本的Forge需要Gradle 8,而26.x的Forge和NeoForge需要Gradle 9,两个大版本是不兼容的。所以仓库里放了两套Gradle wrapper,通过-Pomx_modern_26这个参数决定这一次构建包含哪一组版本。
另外,同一个大版本里面的小版本也会有API的变化,比如1.20.6改了映射,Forge 1.21换了新的EventBus,NeoForge 1.21.11改了权限相关的API。为了让同一个jar能在所有的小版本上运行,调用这些API的地方都改成了用反射,其他地方还是直接调用。如果权限检查出了问题,就按照没有权限处理。
这里没有用Matrix的SDK,直接用了JDK自带的HttpClient,加上Minecraft本身就带有的Gson,调用了大概8个Matrix Client-Server API[4]的接口。因为只需要连接一个没有加密的房间,用到的接口很少,自己写反而更简单,jar里面也不用打包额外的依赖。
网络请求都在单独的线程里进行,游戏内的聊天事件只是把消息放进一个队列,所以不会卡住服务器的主线程。接收消息则是通过sync接口长轮询,sync的进度保存在存档的<world>/data/minecraftmatrixbridge/state.json里,这样服务器重启之后,也不会把之前的消息重新刷一遍。
这个项目基本上是纯AI开发的。从2026年1月开始,自己就已经不怎么看代码的具体内容了,而之前的项目还是会尽可能去看代码是怎么组织的。
开发的工具和模型在不同阶段也不太一样。一开始Cursor和Codex都拿来尝试过,Cursor里面尽量用的是Claude的模型,Codex则是因为有ChatGPT的订阅,就顺便拿来用了。从Event Taps开始,主力换成了OpenCode加上oh-my-opencode[6]。大概是这样的:
| 阶段 | 工具 | 主要模型 |
|---|---|---|
| 2026-01 第一版(v0.1.0到v0.1.3) | Cursor,Codex | Claude Opus 4.5 |
| 2026-01 Event Taps | OpenCode + oh-my-opencode | 主agent用Claude Opus 4.5,探索和咨询的子agent用GPT-5.2 |
| 2026-04 适配26.x的初版 | Codex + oh-my-codex,OpenCode + oh-my-opencode | GPT-5.4 |
| 2026-05 适配26.x(v0.1.4) | OpenCode + oh-my-opencode | GPT-5.5,探索用GPT-5.4 mini |
| 2026-09 兼容性和发布(v0.1.5) | Codex,Claude Code | 前期GPT-6 Astra,后期GPT-5.6 Sol |
自己负责的是设计整个mod的框架,包括如何跨版本、仓库的文件组织和交叉编译的思路。具体的做法是先和agent讨论各种想法,讨论出结果之后,再让agent把结果整理到AGENTS.md里,里面包括项目要做什么、必须满足的要求(纯服务端、尽量少的依赖、不能阻塞主线程等)和不做的东西(端到端加密、多房间等)。这个文件就是在一次次讨论中慢慢积累起来的,一直没有提交到仓库里。之后Gradle的细节和代码的编写就全部交给agent来做了,做新功能的时候也是一样,先讨论,把计划写进AGENTS.md,再开始实现。
oh-my-opencode是OpenCode上的一个多agent编排层,一个主agent负责写代码,其他的活分给不同的子agent:
在提示词里加上ultrawork,主agent就会自己并行地开几个子agent去调研,再把结果汇总起来。
做Event Taps的时候,先让它基于AGENTS.md里之前讨论的结果做一个更详细的计划,分析一下可行性。它会开几个子agent去查代码和文档,然后和自己一起把计划定下来,写回AGENTS.md,再开始写代码。中间需要自己来定的是设计上的选择。事件的索引放在运行时扫描,Matrix端的权限直接用房间里的权限等级,不另外做管理员白名单。另外还专门问了一下启动时扫描事件会不会卡住主线程。写完之后,agent会自己跑构建和单元测试,再把各个版本的服务器真的跑起来看看。
4月份适配26.x的时候,先用Codex加上oh-my-codex写了第一版,再让OpenCode里的Hephaestus去审查这份代码,把审查出来的问题都修掉。修的时候用的是ULTRAWORK Loop,oracle检查通过了才会停下来,中间被oracle打回了6次。
5月份发布v0.1.4,用的是Hephaestus加上GPT-5.5,还开了几个只读的agent专门做审查。agent写出来的东西也不是每次都对,这个阶段自己纠正了好几次:
neoforge-shared里9月份做v0.1.5用的是Codex,前期是GPT-6 Astra,后期是GPT-5.6 Sol,也用Claude Code处理了一部分。这次做的是让同一个jar兼容各个小版本,并且把真实Synapse的端到端测试加进了CI。后面提到的CurseForge版本标签的坑也是这个时候遇到的。
测试方面,也是尽可能让agent把自动化测试写好,包括单元测试、用模拟的Matrix服务器启动真实的Minecraft服务器进行测试,以及后来在CI里用真实的Synapse[5]服务器,对45个Minecraft版本和加载器的组合做端到端的测试。但是每次发布新版本之前,自己都还会用真实的Matrix服务器和真实的Minecraft服务器人工测试一次,确保它能跑。
连接提示需要根据玩家的客户端语言显示。由于这是一个纯服务端的mod,原版客户端里面并没有这个mod的语言文件,所以文本只能在服务端根据玩家的语言翻译好再发过去。
问题是,玩家刚登录的时候,服务器其实还不知道玩家的语言,这个时候读到的都是默认的en_us,客户端的设置要过一会儿才会发过来。一开始的做法是固定等20个tick再发提示,但是不稳定。后来改成每个tick检查一次,如果客户端的设置看起来已经收到了(视距不是默认的2,或者语言不是en_us)就发送,最多等5秒。
Minecraft从26.1开始改成了按年份的版本号,CurseForge那边的版本标签也和之前不太一样。发布v0.1.5的时候,发布流程在查找Minecraft 26.2这个标签的时候,先是一个都找不到,修好之后又找到了两个,一共失败了4次,对应修了4个commit。
好在发布流程是先校验所有平台的版本标签,然后才开始上传的,所以失败的时候也不会出现只发布了一半的情况。
除此之外还有一些小问题,比如Forge用的NightConfig的文件监听线程会让服务器在stop之后关不掉,以及超时重试的时候没有复用Matrix的transaction id,导致同一条消息发了两遍,这些都在v0.1.5里修好了。
本文介绍了MC Matrix Bridge,一个把Minecraft服务器和Matrix房间连接起来的Forge/NeoForge纯服务端mod。它的核心逻辑和Minecraft版本无关,通过很薄的兼容层支持了从1.18到26.2的Forge和NeoForge。这也是自己第一个基本上纯靠AI开发的项目,自己负责架构和人工测试,代码交给agent来写。
2025-05-19 21:56:00
bili-parser是一个用来解析B站视频信息的网页工具,输入B站链接之后,可以得到视频的封面、标题、播放数据和简介,并且一键复制成方便分享的格式。后来又加上了基于Whisper的AI字幕,以及基于字幕的AI摘要和对话。代码发布在GitHub上,项目地址,在线版本部署在Vercel上。
之前在QQ群里看到有一个bot,别人在群里发了B站链接之后,它会自动回复这个视频的信息和总结,个人觉得这个功能挺好的。
但是如果是自己手动把B站链接转发给别人,就会有一个问题。对方只能看到一个链接,并不知道这个视频里面包含什么内容,得点进去才能看,所以吸引力就不是很强。如果转发的时候能带上封面、标题、播放数和简介,吸引力就会强很多。
所以就先做了这个工具,把视频的metadata整理成一段可以直接复制的内容,然后再慢慢往上加功能。
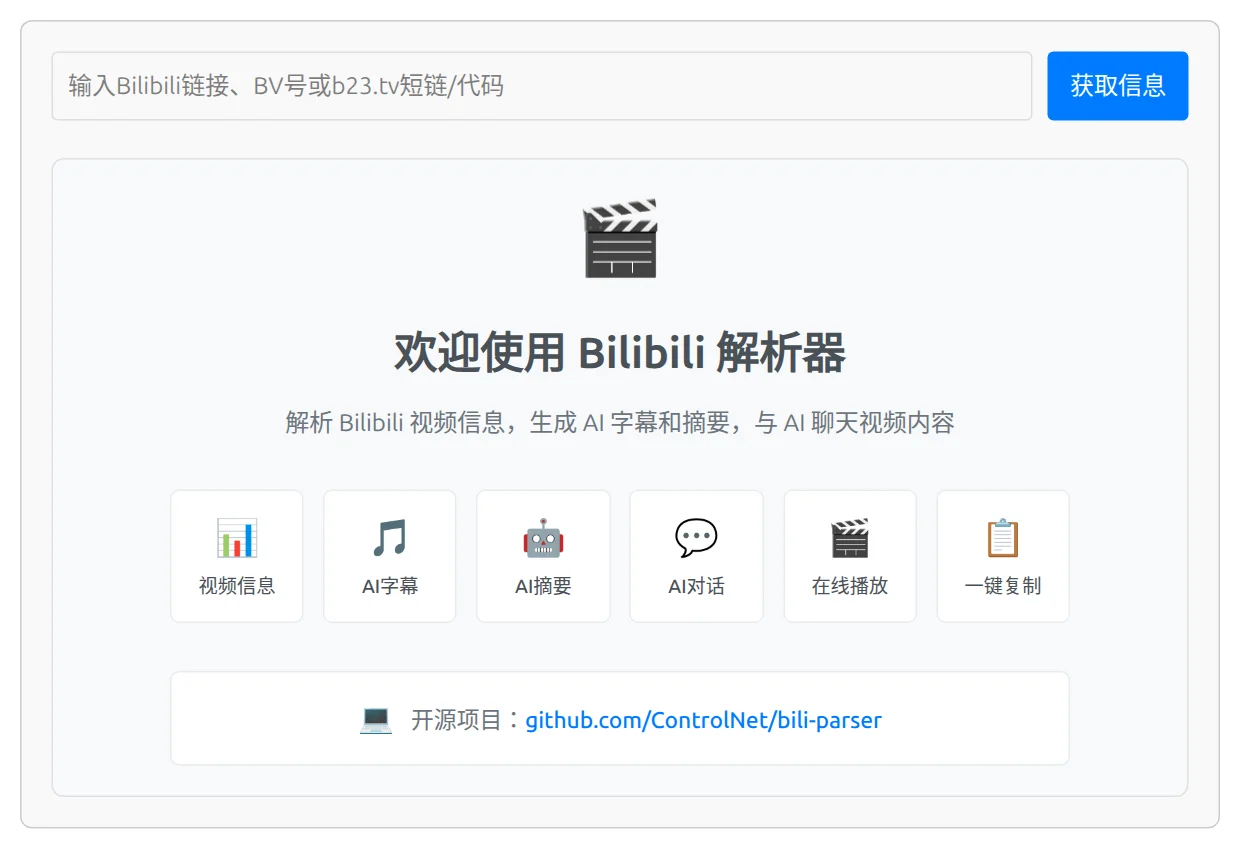
Fig. 1. bili-parser的首页
目前主要有以下功能:
每个视频也有自己的页面,比如 https://bili-parser.vercel.app/BV1xx411c7mD,可以直接把这个地址发给别人。
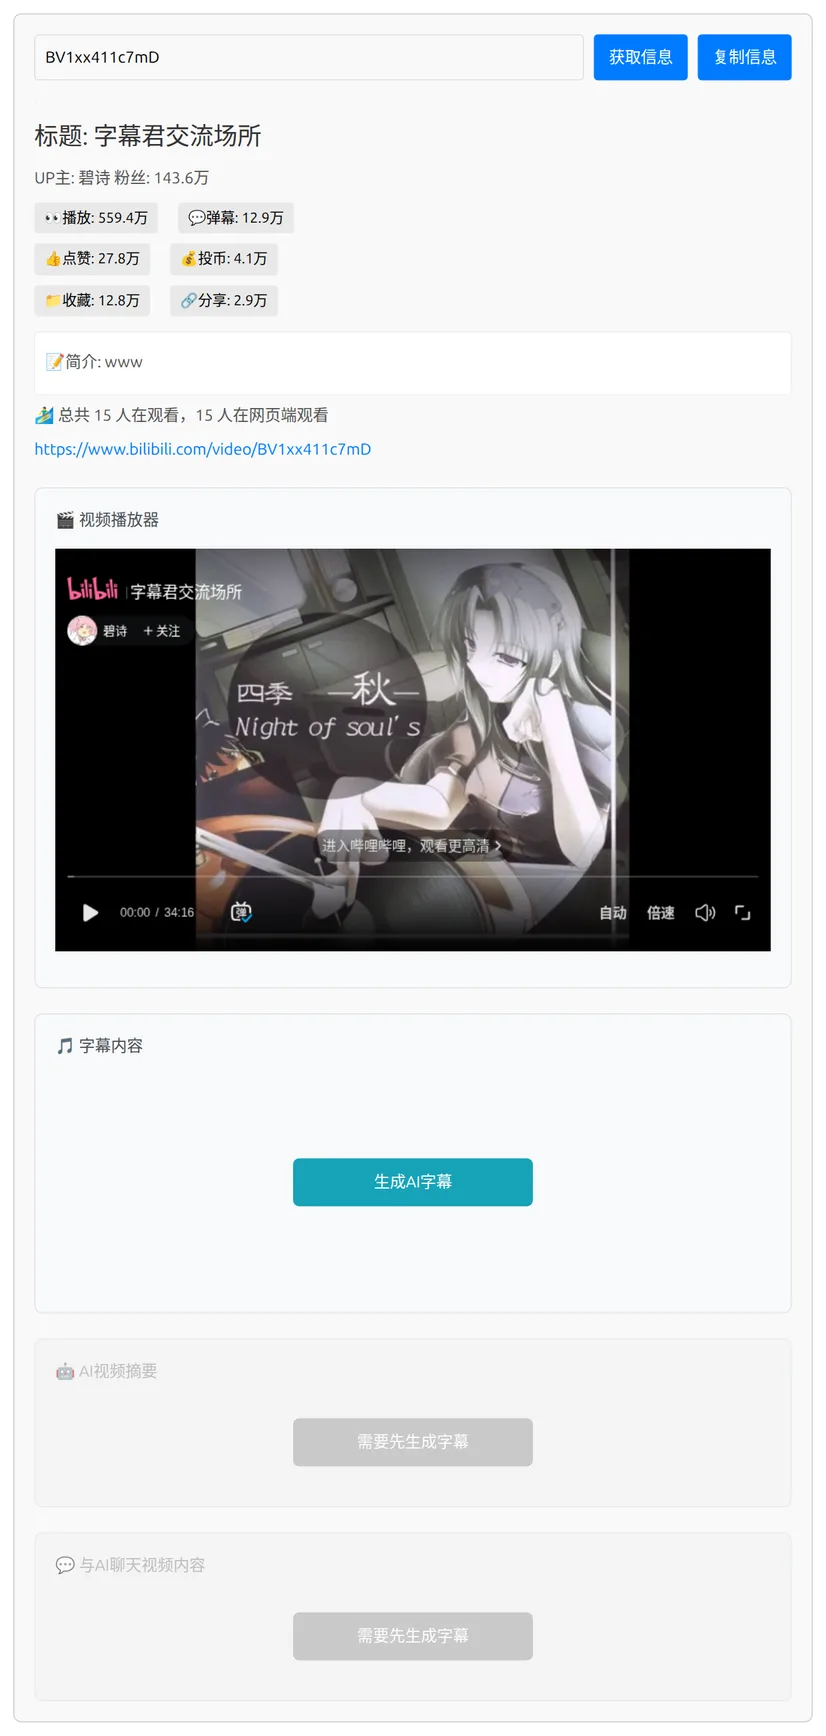
Fig. 2. 解析B站最早的视频字幕君交流场所(BV1xx411c7mD)的结果
复制出来的纯文本是这样的,粘贴到聊天软件里面基本上一眼就能看到这个视频是什么。
1 |
标题: 字幕君交流场所 |
直接打开 https://bili-parser.vercel.app,粘贴链接之后点获取信息,然后点复制信息就可以了。
除了网页之外,也提供了两个API,方便在别的地方调用。
/api/parse: 返回JSON格式的视频信息/api/copy: 返回和网页上复制的内容一样的纯文本1 |
curl "https://bili-parser.vercel.app/api/parse?url=BV1xx411c7mD" |
其中url参数可以是BV号,也可以是URL编码之后的完整链接。
1 |
git clone https://github.com/ControlNet/bili-parser.git |
然后访问 http://localhost:5173 就可以了。.env 里面有以下几个变量:
WHISPER_ASR_URL: Whisper服务的地址,用于生成AI字幕OPENAI_API_KEY,ANTHROPIC_API_KEY,GOOGLE_GENERATIVE_AI_API_KEY: 用于AI摘要和对话,至少配置一个,按照这个顺序使用第一个配置了的如果只用视频信息和复制功能,不需要配置任何环境变量。
Whisper服务需要部署在有GPU的机器上,可以直接用打包好的docker镜像。
1 |
docker run -d --gpus all -p 9000:9000 --name whisper \ |
整个项目使用SvelteKit[1] + Tailwind CSS,部署在Vercel上。由于浏览器直接请求B站的API会遇到跨域的问题,所以对B站的请求都是通过SvelteKit的服务端接口转发的。
Fig. 3. bili-parser的整体架构
如上图所示,网页和iOS快捷指令都是通过bili-parser的服务端API来获取信息的,服务端再去请求B站的API和CDN。AI字幕的部分交给自己部署的Whisper服务,Whisper服务会自己去B站的CDN下载音频。AI摘要和对话则是把视频信息和字幕一起发给大模型的API。Windows上的Python脚本是一个例外,它直接请求B站的API,并不经过bili-parser。
第一个版本是一天之内做完的。输出视频的metadata还是比较容易的,B站有现成的接口可以拿到视频信息、UP主的粉丝数和在线人数,整理成固定的格式就行。b23.tv的短链则是在服务端请求一次短链,不跟随跳转,从返回的Location里读出真正的视频地址。
比较麻烦的是封面图。B站的图片有防盗链,所以又加了一个图片代理的接口,带上B站的Referer去获取封面。复制富文本的时候,封面会转成base64直接嵌入到HTML里,如果图片超过5MB,就按0.8倍一步一步缩小,直到小于5MB为止。
做完基本功能之后,又想要能基于视频的内容进行对话,所以首先需要获取视频的全部字幕。但是结果发现,B站的字幕没法匿名获取,必须要登录账号,这样可能会造成一些别的问题。
所以换了一个思路,自己部署一个Whisper[2]服务来识别视频里的语音。具体的流程是,bili-parser先通过B站的接口拿到视频的音频流地址,然后发给Whisper服务,Whisper服务下载音频之后识别出所有的transcript。这里fork了whisper-asr-webservice[3],做了以下几个修改:
audio_url,由服务端自己下载音频/submit提交任务,然后用/get/{job_id}查询结果,网页端每10秒轮询一次bili_{bvid}_{cid}作为音频的id,识别结果存到SQLite里,同一个视频不需要重复识别改完之后打包成了docker镜像controlnet/whisper-api。一开始字幕接口是同步请求的,同一天晚上就改成了异步提交加轮询,然后又加上了缓存。另外Whisper识别出来的中文经常是繁体,所以还要再转成简体。
有了字幕之后,把视频的背景信息和字幕一起作为上下文交给大模型,就可以生成摘要和进行对话了。大模型的部分用的是Vercel AI SDK[4],支持OpenAI,Anthropic和Google三家。自己用的是Google的免费API,摘要用的是Gemma 3,对话用的是Gemini 2.0 Flash。
有了这些功能之后,除了在网页上点击使用,也希望在别的地方能方便地使用。
首先是Windows。在Windows上,没有办法简单地通过某个API把带封面的内容自动复制到剪贴板,如果要用API,怎么说也得套个壳。所以就写了一个本地的Python脚本,直接对Windows的剪贴板进行写入。这个脚本完全重现了网页端复制的逻辑,但是并没有基于bili-parser的API来写。
然后是移动设备。iOS上用的是快捷指令,请求bili-parser服务端的API,获取视频的相关信息然后复制。但是这样只能复制文本,没有办法把封面图一起复制,对分享来说还是有一些限制。
2026年9月的时候,发现B站的API会返回412,也就是被风控了。之前为了模仿浏览器,服务端在请求时手动加了一个Chrome 91的User-Agent和Referer等header,最后的修复反而是把这些伪造的header全部删掉,直接请求就恢复正常了。
用了一段时间之后,发现这里面还是有一些问题,可以作为后续改进的部分。
本文介绍了bili-parser,一个解析B站视频信息、方便分享B站链接的小工具,以及后来加上的AI字幕、摘要和对话功能。目前视频信息和复制的部分已经可以满足日常使用,AI和多端的部分还有不少可以改进的地方,以后有空再继续做。


