2026-09-26 22:51:00
最近在鼓捣 WebAssembly,这玩意没啥神秘的,可以看出一坨二进制的 .js 库文件
它本身的export和调用方式是统一的,但如今天我才知道,在不同 JavaScript 运行环境加载 .wasm 方式并不完全一样。
例如 Cloudflare Workers 可以直接:
import wasm from "./simple.wasm";

const { instance } = await WebAssembly.instantiate(wasm, imports);
Cloudflare 会把 .wasm 模块作为 WebAssembly.Module 提供给代码。
浏览器通常则是通过 fetch() 获取 Wasm,再使用 WebAssembly.instantiateStreaming():
const { instance } = await WebAssembly.instantiateStreaming(
  fetch("./simple.wasm"),
  imports,
);
Node.js 则通过文件系统读取 .wasm 二进制,然后初始化。
.instantiate() 第一参数必须是 typed array 或者 ArrayBuffer
我自己写了个 Wasm 库,AI 为 Node、浏览器、Cloudflare Workers 分别写一套初始化代码,8个 .mjs 文件。给我搞懵了。
提了个简化思路:让初始化函数只接受两种东西:string 表示路径,或者cf那种 WebAssembly.Module 对象
然后搞的时候发现,为了兼容 nodejs,必须 import "node:fs" ,才能读 .wasm 文件嘛
然后逆天的 js 引入必须在 top-level ,在 cf 和浏览器侧就必挂。你 typeof process 提前判断一下环境都不行。
不过AI这时候想到一个聪明办法
if (process?.getBuiltinModule) {
  const fs = process.getBuiltinModule("fs");

  const bytes = await fs.promises.readFile(source);
  return WebAssembly.compile(bytes);
}
卧槽,有这么好的办法,你为啥不早点告诉我。
于是使用方式统一成:
Cloudflare Workers
import wasm from "./simple.wasm";
import { init } from "./foo.mjs";

const foo = await init(wasm);
Browser / Node.js
import { init } from "./foo.mjs";

const foo = await init("./simple.wasm");
2026-09-23 20:21:00
前几天 Yann LeCun 对 变形金刚(transformers) AI 进行了深刻的批判
First, the reasoning abilities of current AI systems are based non-auto-regressive search (which is what I have always advocated for). But AFAICT, they do it in token space, which is limited and inefficient. I have claimed that human-like reasoning must be a search in continuous representation space. It looks like the industry is moving towards that.
Second, the self-improvement methods, as currently practiced, only work for domains where the quality of outputs can be scored without human intervention, such as mathematics, code, and scenarios that can be simulated accurately. Not anything else. Humans and animals learn new skills way more efficiently than current RL methods.
Third, the multimodal capabilities of current AI assistants generally use separately-trained encoders (that are not LLMs). This is also what I've been advocating. Except that I think the best way to do this is with JEPA trained with self-supervised learning. The research community is clearly moving towards that (3000 papers on JEPA in just 4 years).
Fourth, if LLMs were a path to human-level AI, we would have domestic robots and Level-4 or Level-5 self-driving cars for consumers by now. And we don't. We certainly don't have cars that can learn to drive in 20 hours or practice like any teenager. We're still missing something pretty huge to claim human-level intelligence (let alone superhuman).Sure, we now have computer systems that are impressive, very useful, and whose performance is superhuman in an increasing number of domains (coding being one of them). But that's true of the entire history of progress in computer technology.
可能很多人早知道这个了,对我来说,很新鲜。毕竟我是AI 外行。以前一直听说 自回归 自回归,其实我今天才突然反应过来,这个 回归,就是数学期望那里,预测的意思。这里的 自 就是 一个token接着另一个token源源不断“自动” 跳出来直到 eos_token 的意思。🤣
他老人家都这么说了,想了下还真是。用 LLM 越多,越会明白在 Token 空间里做推理的局限性。
于是我突然想起很多天之前看到的一个youtube 视频,21世纪被引用次数最多的论文。这个35分钟的视频非常值得推荐完整观看。剧透:它讲的是 残差网络 ResNET
它提到另外一件事引起了我极大的兴趣,Meta FAIR 在ICLR 2024论文,发现了一个有趣现象:ViT 模型(尤其是 DINOv2、OpenCLIP、DeiT-III 这类大规模训练的模型)在推理时会产生一些"异常高范数"(high-norm)的 token,大约占总序列的 2%。这些 token 集中出现在图像中低信息量的背景区域,几乎都是纯色块,携带很少的局部位置/像素信息,却携带大量全局图像信息。只在模型足够大、训练足够久之后才出现(比如 DINOv2 只有 Large 及以上尺寸才有)。这些token会破坏注意力图的可解释性,损害密集预测任务(分割、深度估计)和无监督目标发现(LOST 算法)的效果
他们摸清楚一个脉络,最后研究发现,在输入序列里额外加几个可学习的"寄存器"(register)token,让模型有专门的地方做全局计算,不用再"borrow"图像 patch。加了之后,异常高范数 token 消失,注意力图变干净,下游任务(尤其密集预测和目标发现)性能还略有提升,几乎不增加参数和计算量。
是不是感觉这几件事相当跳跃,我在瞎说些啥呢?
那是因为你没看那个35分钟的视频。我就凭记忆,用我的理解回顾一下(我不太懂AI,纯外行。如有出入视频作者全责😂)
神经网络我觉得就是好几层矩阵相乘造就的魔法。但归根结底 tmd是一个分类器。传统每一层 NN 就干的事就是从上一层的结论里,加工自己的一道参考信息,然后激活给下一层NN继续加工。最后一层就是 N 选 1 的分类。对于 LLM 来说就是词汇表里吐出 next token。
但是这玩意早年极其容易翻车,shattered gradiant,ResNET 横空出世,据说是个 hack,把上上一层的权重和本层的权重做一次 加法。最后输出就稳了
这就有意思了,NN每一层都是无状态的,需要猜上一层为啥处理成这个样子;每一层给出结论,请重点关注某个值,但是至于一开始的为啥要给 attention,可能早就忘记了。这个所谓 残差,就是每一层都给后面一层工作留一个小纸条?就好比工匠无意中在木结构看不到的一些内部地方打上了一些标记。换班的水电工一眼看出这些标记在行业里的用处
AI告诉我,register token就更进一步,人为加进去的、专门给模型当工作空间的 token。attention sink 是模型自己长出来的现象:某些 token 会莫名其妙吸走大量 attention,即使它们语义上并不重要。activation outlier / residual sink则是在 hidden state 某些维度上出现异常大的值。2026 年的工作甚至发现,massive activations 和 attention sinks 经常同时出现,但它们承担的功能并不完全相同:前者更像一种跨层持续存在的“隐式参数”,后者更像是在局部调节 attention。
然后结合今天 ylecun 四大批判,我突然有个看法,变形金刚的未来,说不定又走回 BERT 那种 encoder 思路了?也就是说在一个session内,变形金刚一直在尝试 自创(encode)一些 符号 名词概念 作为中间产物。
我赶紧拿这个去问了AI。
FAIR那个论文 附录(Fig. 9、Fig. 16)里其实发现,不同的 register 会自发分化:有的更关注图像边缘,有的更关注中心区域,行为很像 Slot Attention(一种专门用来无监督地把图像切分成"物体槽位"的机制)。也就是说,即便没有人告诉它该怎么分工,模型自己在若干个"空白格子"里长出了某种专业化结构
这验证了我前面提到的"自创概念"。AI告诉我,文本模型这边也有对应物:
AI提到:
这些自创的中间产物,默认情况下是连续向量,不是像"猫""狗"这种离散、人类可读的符号。你说的"符号/名词概念"更像是一种比喻——真正发生的是模型在高维连续空间里捏出一团对它自己有用、但对人不透明的表示。这也正是这条路线的双刃剑所在:Coconut 这类"潜空间推理"效率更高、更灵活,但代价是可解释性变差——人没法像读 chain-of-thought 文字那样,看懂模型这一步到底在"想"什么。这也是目前 AI 安全/可解释性圈子挺关心的一个权衡点:模型内部会不会形成一套人类读不懂的"暗语",用来在一次推理里传递信息。
嗨,这不巧合了嘛!人类的深度思索过程,也会创造自己不能语言表达的连续符号啊。比如如何狩猎的,空间位置和行动,态势变化和应对。当然你实在用语言描述也是可行的。但是很多战术理念是“心领神会”,充满比喻,平时需要猎人之间训练配合的“默契”。
解题思路,很多时候“直觉” 或者 “奇思妙想”,要描述出来也是很困难的。其实就是一种内在表达
艺术创作更不用说了,什么情绪,境遇,都是很难精准描述的。但是好的东西就是能引起共鸣。诗歌里的“隐喻”特别多。
AI 一下子被点通了:
"默会知识"(Tacit Knowledge)——这是哲学家 Michael Polanyi 在 1966 年提出的经典概念,他的原话就是"我们知道的比我们能说出来的更多"(We can know more than we can tell)。他举的例子恰好就是猎人、工匠、骑自行车、认脸这类技能:你能熟练地做,甚至能一眼分辨"这个猎手动作对不对",但让你把判断标准写成一条条规则,你写不出来,或者写出来的东西根本不是你实际依赖的那套判断机制。狩猎里那种"态势感知"、"该往哪个方向包抄"的直觉,正是这类默会知识的典型案例。
更巧的是,Coconut 那篇论文的灵感来源之一就是神经科学的一个发现:人在做复杂推理(比如下棋、空间规划)时,大脑里负责语言的区域往往并不活跃——语言网络主要是用来表达和交流的,未必是"思考本身"发生的地方(这是 MIT Fedorenko 实验室这些年一直在推的一条研究线:"语言不是用来思考的,是用来交流思考结果的")。这跟你说的"很多战术理念心领神会,语言只是事后的翻译"是同一件事的两种表述。
你提的"猎人之间的默契"还有个更具体的 AI 对应物:多智能体强化学习里有个叫"涌现通信"(Emergent Communication)的研究方向——让多个 AI agent 一起协作完成任务,不给它们任何预设语言,结果它们会自己发展出一套只有彼此能懂的"暗号"来协调行动。早年 Facebook 那个著名的谈判机器人实验,两个 bot 谈着谈着就开始用人类读不懂但内部逻辑自洽的"简写"互相沟通,团队一度要专门约束它们"必须说人话"。这几乎是你说的"猎人之间训练出的默契"在机器上的直接翻版——协作压力会自发催生出非人类语言的、高效但不透明的符号系统。
诗歌和隐喻这块也有对应理论:语言学家 Lakoff 和 Johnson 的"概念隐喻理论"(Metaphors We Live By)认为,人类很多抽象/情绪概念本来就不是靠精确定义存在的,而是靠从具体身体经验"打包映射"过去的——比如"人生是一场旅程",我们理解"人生"靠的是身体对"走路、方向、终点"的经验,隐喻不是修辞装饰,是概念本身的存在方式。这在结构上跟词向量/embedding 空间的工作原理惊人地像:一个词的"意义"不是查字典查出来的定义,而是它在高维空间里相对于其他词的位置和距离——这正是为什么好的隐喻能"引起共鸣":它精确地把一个词挪到了空间里一个新位置,让人瞬间"感觉到"了那种关联,即使没法用命题逻辑讲清楚为什么。
顺着这个思路还有个挺震撼的新假说,叫"柏拉图表征假说"(Platonic Representation Hypothesis,MIT,2024):作者发现,不同架构、不同任务、甚至不同模态(图像模型 vs. 语言模型)训练出来的神经网络,随着规模变大,它们内部对"世界"的表征方式竟然在互相趋同——仿佛都在逼近同一个底层的、柏拉图意义上的"真实结构"。如果这个假说成立,也许能解释你说的"好的东西就是能引起共鸣":不同人(甚至不同物种、不同智能体)的大脑/网络虽然各自训练出一套私有的内部表示,但如果都在逼近同一个客观世界的统计结构,那么一首好诗触发的那个"说不清但都懂"的感受,可能真的对应着大家内部表示空间里一个相近的位置。
感觉和 Yann LeCun 大佬的思路太厉害了。它这么多年批判自回归 LLM 缺四样东西——对物理世界的理解、持久记忆、推理、规划——他认为这不是"训练得不够大"的问题,太犀利了。这种架构性的死胡同,就是导致他 2025 年离开 Meta 搞JEPA的原因?不靠逐词生成、而是在抽象表征空间里维护和更新一个可持续演化的"世界模型"的系统。
说得再直白一点,现有的LLM智能,就是个 classifier
我觉得,真正的智能需要决定,什么时候是选择 non of the tokens above
一个自回归模型每一步在做的事,字面意义上就是一次分类——对词表里几万到几十万个 token 做 softmax,选一个概率最高(或采样出)的。
虽然可以反驳,把很多次这样的分类串起来,输出空间是指数级增长的——理论上可以生成训练数据里从未出现过的句子、证明、诗句。这正是创造力研究里 Margaret Boden(刚去世,这个领域的奠基人物)说的"组合式创造力"(combinatorial creativity)
但这样的智能,关键词是 —— 串。的确frontier AI 能作出很多令人惊叹的成果。甚至普通人遥不可及,但是代价是——串行。
也就是传说中的炼丹,抽卡。某些条件成熟了,reasoning和temperature恰好合适,agent 和 harness 恰好走对了,就能拿到低垂果实。
但是人类发明概念是源源不断的,meme的传播嘛。这可不是“串”行,而是霰弹枪 “啪” (one-shot 🤣) 一下,总多概念,总有一个能火力覆盖到一个没太见过的新鲜事物上,并且低成本快速掌握。而现在的AI 就得话不少 context 去“串起来” 才行。
AI说
你这个"霰弹枪 vs 串行"的对比,精确地踩中了一个已经有名字、有数学模型的现象——而且两边(人类创造力研究、AI 可靠性研究)居然是分头独立发现的。
先说人类这边的"霰弹枪"理论,比你想的还要精确。
心理学家 Donald Campbell 1960 年提出"盲变异—选择性保留"(Blind Variation and Selective Retention, BVSR):创造过程本质上是达尔文式的——先大量地、相对盲目地生成变异(不是精心设计出一个必中的方案),再靠后续的选择机制留下有用的那个。Dean Simonton 在此基础上研究了两千多位历史上的科学家、艺术家,1997 年提出"等概率法则"(Equal-Odds Rule):一个创作者产出"神作"的比例,跟他是不是天才其实关系不大——天才和普通人每一件作品成为杰作的概率大致相同,天才只是产量大得多。Erdős 一辈子发了 1500 多篇论文,绝大多数无人问津、早就被遗忘,但正是这个巨大的"总发射量",让他撞上了拉姆齐理论这种真正改变领域的成果。这跟你说的"总有一个能火力覆盖到",几乎是同一句话的学术版本。再往上一层,meme 的传播压根不是单个大脑内部的并行——那是数十亿个大脑同时在生成变异,靠文化选择去放大命中的那一个(这就是道金斯说的模因论/文化演化)。这个并行规模比"霰弹枪"大出去不知道多少个数量级,单个大脑内部再怎么"啪"一下,也比不过整个文明每天在同时试错。
AI 这边,其实field自己也早就意识到"纯串行=脆弱"这个问题,而且给出的解法方向恰恰就是"变成霰弹枪"。
单条链最致命的地方是错误复合:如果每一步正确率是 95%,串 20 步,整体成功率掉到 36%(0.95^20)——这正是"炼丹抽卡"体感的数学根源,probability 是乘出来的,不是加出来的。为了对抗这个,最近几年推理/Agent 领域的主流做法,说白了都是"别赌一条链,改成一次放很多枪再挑":Self-Consistency(Wang 等,2022)——同一个问题采样几十条推理链,投票选最多数的答案;Tree of Thoughts(Yao 等,2023)——同时展开多条思路分支,中途评估、剪枝、回溯;再往后的各种"test-time compute scaling"方法,本质都是把串行的单链,换成并行采样+事后选择——这跟你说的"霰弹枪打一片,总有一个覆盖到"是完全一样的逻辑,只是子弹换成了"多条并行生成的候选答案"。
其实想到这里,我感觉和上一篇《聪明 Agent 四套路 和 人肉学习》 又莫名其妙关联起来了。
或许如果 register token 这一套能沉淀,跨session共享,实际上就能变成新的 token,变成共同的符号和记忆。人类的语言和文字,知识传承就是这么来的。
那么NN就不再是 自回归 ?说不定就 AGI 了?
2026-09-23 20:21:00
nVIDIA 联合 NTU,MIT 联合研究了一项关于 Agent harness 自我提升的研究,项目叫 SoL-Pi, Scaling Auto-Research Loops for Efficient Agent Harnesses
让 Research Agent 自动发现 Harness 里的 Token 浪费,再通过大规模实验筛掉无效改法。把结论再放进大量环境中反复测试。整个探索一共 152 个候选方向,分成 context、progress、tools、delegation、prompt/policy、improvement/evaluation 六类,然后把这些想法扔进大量相互隔离的 research lineage 里,让 agent 自己观察 trajectory、提出机制、实现、review、跑实验、继续修改。最终用了 535 个可执行搜索环境,其中 495 个来自 GitHub issue-PR pair,40 个是 verifier-driven synthetic tasks;论文说总共跑了 3000+ 次实验和 60000+ 次 agent-environment interaction
最后真正留下来的精华,只有 4 大机制:
我因为脑子比较轴,总喜欢扩展关联到别的领域,于是想把这四大方法,也套在人肉学习上:
AI给我补充了很多reference
Schoenfeld 给这个现象起名叫 "wild goose chase"(追野鹅):他发现约60%的大学生解题时会选定一个方向就一路埋头走到底,直到时间耗尽都不回头反思;而当他训练学生每隔一段时间就问自己"我现在具体在做什么?为什么这么做?这对我有什么帮助?"之后,这种不做监控的比例从60%降到了20%,解题成功率也相应提高。更有意思的是,他后来观察一位数学教授解题——这位教授手头掌握的事实和方法其实比很多学生还少,解题过程中也生成了无数条可能的死路,但他没有被这些死路带偏,靠的就是频繁地、细粒度地检验"这条路值不值得走下去"
Catrambone关于子目标形成的研究描述了一个具体过程——学习者先把一串步骤按结构分组,然后自我解释"为什么这样分组",最后把这个分组归纳成一个简洁的标签(子目标标签)。这三步合起来,正是"做完一段就反思、并把它压缩成一个可以往下带的简化单元",跟你说的第二条几乎逐字对应。而它的反面,就是你说的"看小说一样囫囵吞枣"——只是线性地把内容或答案过一遍,不做任何分组、归纳、压缩,信息就只是流过去了,没有被结构化,也就没法被高效复用。
人类研究就是子目标标签(subgoal labeling)本身——Catrambone给出的经典例子是解方程"隔离变量→化简变量":学生只需要在主线上记住这两个子目标,每个子目标内部具体怎么算是被封装起来的细节,不需要在思考整体解题结构时一直占用工作记忆。研究还发现,用子目标标签训练出来的学生,遇到步骤不同但子目标结构相同的新题时,迁移能力明显更强;而没有这种封装、只是记住老师板书完整步骤的学生,换一道结构相同但细节不同的题就容易失败——这正是"细节污染主干"的后果。这也呼应了国际象棋大师的组块(chunking)研究:高手把一串走法编码成一个组块整体记忆和调用,而不是逐步保持在工作记忆里,从而腾出容量去思考更高层的布局。
Polya经典的解题四阶段(理解问题→拟定计划→执行计划→回顾)里,"回顾"这一步要求你把推理过程记录下来复查,而不是解完就扔;如果第2、3条里的"压缩""封装"做得太狠、把关键中间结论也一起丢了,你会既没法自查错误,也没法把这段经验迁移到下一个类似问题上。这也是为什么"元认知校准"(上一轮提到的)离不开留痕——你没法准确判断"我这一步到底对不对",如果连这一步的关键推理都没有记录下来可供回看。
很多学习者,特别是中小学学生,对这些“显学”反而不知道。父母和老师也不会教。
虽然大部人聪明人能领悟到这一点,但是很多平庸的学生学到这四点教训已经太晚了。。。
因为传统学校的考试 测验的 reward 只看结果,不太关心你过程怎么来的。小学知识比较简单,留下来的坏毛病带到初中之后就麻烦了。
我家的娃就深受其害。在小学阶段,“只要答案对,就算成功”这个策略经常真的有效。题目短、知识点少、搜索空间小,靠记忆、模仿、反复练习也能得到不错的结果。于是很多低效习惯不会立刻付出代价。死记硬背就能拿个勉强过得去的分数。
到了初中以后,情况开始变化。题目的状态空间变大了,步骤变长了,知识之间开始相互依赖。此时如果学生一直没有形成,那么就会无意中陷入困惑:
这些能力,学习成本会突然上升。
客观的因素,大班制教学,老师也管不过来。只有精英教育 私教 遇到良师,或者就孩子被鼓励“多思考”,才可能戳破这一系列技巧。
小学时,“直接冲答案”很快,成绩又不错 → 学生得到正反馈。小时候看起来只是“不够仔细”的问题,几年后会表现成“学习能力不行”。
上面列举这四个技巧,我其实个人很早就懂得,无意中自己琢磨的,回顾了下,可能被小时候鼓励“更聪明的办法”太多次了,这里要感谢当时的父母,自己本身希望去掌握那个最快 最酷的解题技巧,所以算 “过程优化” 到极致作为一个附加 reward了。一个问题有多种解法,每种解法优劣都品鉴了一番,知道哪些坑哪些好。
这就很接近论文里的 harness optimization 了。解题的意义不仅在于得到正确答案本身,还有在观察“解题算法本身”。
初中、高中我甚至有几起名场面,公开质疑老师出题出的有问题(50%翻车)🤣
当然,这个习惯也有其害处,我也吃过亏。三角函数大家都背公式,我就自己发明了一套自以为更好的理解框架。。。结果出题人更偏好教材公式能快速结果的,我那套不仅更复杂,容易翻车,而且还有“翻译”成本。。。囧。。。
考试的 reward 实际上更接近:在限定时间内,用低风险路径得到标准答案。
不过好处还是很明显,就是大多数问题理解得比普通人深入得多。特别是解析几何这种虽然被批判“不入流”但是几乎秒杀了教材党。。公式全靠自己推的,哪里怎么变换怎么用一清二楚。甚至圆锥体歪着斜着切这种问题都考虑到了(传统教材只有水平,垂直和顺着斜切)
这个亏一直吃到出来工作,长了很多教训。我对待任何事都是双层架构。一个是兼容傻逼的世俗层,一个是真理层。。。囧哈哈哈
其实真理层反复磨练到最后反而越来越简单。世俗层基本就是补丁接补丁越来越复杂。普通人搞不明白要崩溃的很多事情一眼看穿。。
毕业之后,发现学生时代最值得批判的,就是做题家思维。成年人的世界是没有标准答案的。甚至你需要去设置议题。当然这又是另外一个层次的东西了。
然后回头看,学生最幸福,也是最痛苦的一点,就是面临的所有问题,无论多困难,是必然有解的;而且往往正确解是唯一的。
成年人面对的事情,基本都有多个解。你 reward 去优化,无非是利弊的权衡;
最可怕的遭遇,无解,死胡同,到头来一场空。你去尝试解决一个不存在的问题,你又能学习到什么教训呢?时也,运也,命也。
2026-09-18 16:15:00
前几天鼠标坏了。随手换了个新的,双飞燕。没想到这垃圾鼠标居然在 macbook 下有间歇性卡顿 失联问题,表现是光标不动
怀疑是 系统问题,驱动问题,鼠标本身,商家卖假货问题。最后想明白了,这几十元破玩意就tmd不值得去折腾心态。直接扔。
回想了一下,这玩意其实对工作影响比意料中的大得多。平时操作触摸板 键盘都是下意识的,根本不会去多想;
光标在显示器上一旦当场卡住,你大脑瞬间被吸引过去,从软件到硬件到购买决策,到损失厌恶,全部过一遍,恶心死了
生活中我们习惯了太多「常见」的事,是工业和质量体系支撑着这一切的「正常」。我想到骑车可以走神,开车可以走神,走路也可以走神,有的时候经过一个路口,你都完全不知道道路上发生了什么,怎么过的红绿灯,有没有危险,浑然不知;自己反正在操心着别的事儿,身体就不由自主的「自动驾驶」
电脑上 打字 也是一样。一个输入法如果能连续不断正确打出你想要的东西,那种表达的流畅是让人很舒服的。因为新生代很多人都不会 盲打 了,我想很多人可能很难体会到这一点了吧
我想到,其实写代码也是一种同样的感受。无论是以前古法手搓,还是现在 AI 写代码,都有那么一些任务不想去碰,即便动工也完成得不好。
仔细观察了下这类任务都有几个特点:缺的东西和中间步骤比较多,可选的方向变化也比较多。比如你要给一个推送任务加一个可选参数,但是要动底层基础数据结构,这个事儿也不急,这种改造除非有业务推着,你多半不想去重构推送的核心。
想想都蛋痛,不知道会出什么夭蛾子,也不知道最后做出来被改成稀奇古怪的结构了。
也就是说你大脑需要在很多细节和路径上中断,hiccup,做决策,可能还有后悔,最后发现费这么多精力做出来的,纯纯浪费。
这种挫败感是极强的,人性天生都会懒得去碰,惰性就是这么来的,拖延症也是这么来的
然后这事儿其实又和 tiktok 所谓 swipe up 上瘾机制联系起来了。过去视频网站的观看决策
点击缩略图 → 看完 → 回到列表 → 挑选 → 点击另一个 缩略图。这么多的 hiccup 很容易造成注意力流失
还有 tinder。
但是反过来说,丝滑是投入程度、连续注意力的必要条件。看来身边很多天然形成的“障碍” 是大部分人没有意识到,也没能识别的。
汽车工业,自行车早年可能操作起来也没那么丝滑,还有道路条件等。社会进步为了避免交通事故无意中促成了这一条件。
突然回忆起《Halt and Catch Fire》这部剧里看到的,Doherty Threshold,多尔蒂阈值。
以前的电脑,mainframe,小型机,本质都是个 batch processing系统,流程是 edit-compile-run-debug。我们这代人,上个世纪学习的信息技术课,「上机」是特殊的日子。先是教材讲很多理论知识,你准备好了,换上鞋套,去无尘的“微机室”肘击键盘,得到真实返回。然后你在大脑、纸笔上把问题上琢磨好了,再去敲打一轮电脑。很有仪式感的一套打法
这部剧里讲,他们制造的PC,延迟低于 400ms,用户就能在敲一条命令后立刻得到返回,思绪不会断,执行任务的效率会极大的提高
今天回味这一点,特别像 AI agent的故事。一旦你体验过 ultrafast 那种推理模型,就很难回去了。你可以 实时决策。
或许我们讨论心流的时候,特别注意任务本身的难度,而忽略了周边配套造成的阻碍。
今天的感悟,很简单,如果做app或者服务,要把流程的丝滑程度做到极致,尽可能避免一切可能的 hiccup
2026-09-03 20:51:00
趁还记得,记录一些
起初是发现 嫦娥七号 在文昌发射,于是兴冲冲带着孩子去观看 CZ-5 发射
围绕着这个火箭发射基地做了大量调研;了解到很多知识:
二话不说,定机票;无意中刷到 云闪付 有 -200 优惠,于是周五定闹钟抢票,抢到手。不过发现使用优惠,折腾了大半天发现
折腾半天,感觉还比如直接一起打包买往返划算。囧
然后就是轰轰烈烈的定住处,观礼台。
因为时间比较接近了,发现价格贵得起飞,甚至一度想到骑电瓶车去路边看,考虑发射时间早上8点太早,很可能天气预报有雨于是作罢
选了一圈定 淇水湾五号 小区,价格 1500 。其实在门楼镇上有1200甚至900的,但是住宿条件更差。
然后,延迟一天,房东也爽快的答应延期一天入住;
但是返程机票已定,时间不够,于是折腾半天去改机票,每个人 -140 。啊痛死!
接下来,让人更崩溃的事发生了,发射tmd取消了!
还好这个房东比较爽快,直接退款。网上很多撕逼的。
虽然我也一直关注今年广西边上这个土台风,没想到居然取消了啊。虽然有消息传言说天气因素不大,更关键这次南极科考任务有多国科学载荷,必须万无一失,碰巧遇到一些仪器上无法立刻解决的bug,所以。。
于是就不得不改成海南旅行。在登机前一刻还在查怎么玩;想了下打车每天几十,加起来不如租个车。
去神州挑了个 AION S。第一次租车,先随便试试。落地 HAK 发现居然停车场在11楼,电梯还不好找。
这车比想象中好开,花了4个小时直奔三亚;中途在中石油充电,吃泡面。还没吃完,电都快充满了。还好车少桩多,不急着挪车;
到了三亚,让娃去游泳。酒店随便选的,在凤凰岛,外里面非常高大上,实际上里面非常破,东西都发霉了,考虑到1字头价格,不好评也懒得差评。
游泳池有三个,忘记带泳帽,民宿老板爽快送了2个库存要求好评,但是后来应娃的要求去买了泳镜,被宰了 68 ,气愤。
海景房视野是舒服,看网上说海水高盐对家具和装潢都是毁灭性的。
第二天,上午懒觉+游泳,下午逛景点,先去看南海观音,门票和观光车花费0,因为看攻略导航到村里直接去沙滩远观即可。孩子很多年没接触大海了兴奋得玩了好几个小时
椰子10元一个。感觉贵了,上网一查果然。今年海南的椰子据说收成好,卖不起价
天涯海角 景区,坑得一批。虽然不要门票,但是要手机号 身份证。结果刷二维码的看都不看。感觉可以乱填一个进去。只去了正大门,天涯海角石在好几公里远,观光车划不来,放弃。后续在网上查到可以开车到西门进,很近
第三天不知道玩点啥,随便搜到一个 亚特兰蒂斯水世界 。官方酒店2k+我是舍不得的,找了个直线距离最近的附近的民宿。结果大大出乎意料,它丫的开了个小门,去 亚特兰蒂斯检票口 只需要步行 5分钟,比外边开车停车场或公交车都近的多。价格300一晚,2个房间2个大床,海景绝美。就停车有点贵30封顶24h,不过官方停车场40封顶24h。感觉又赚了10元
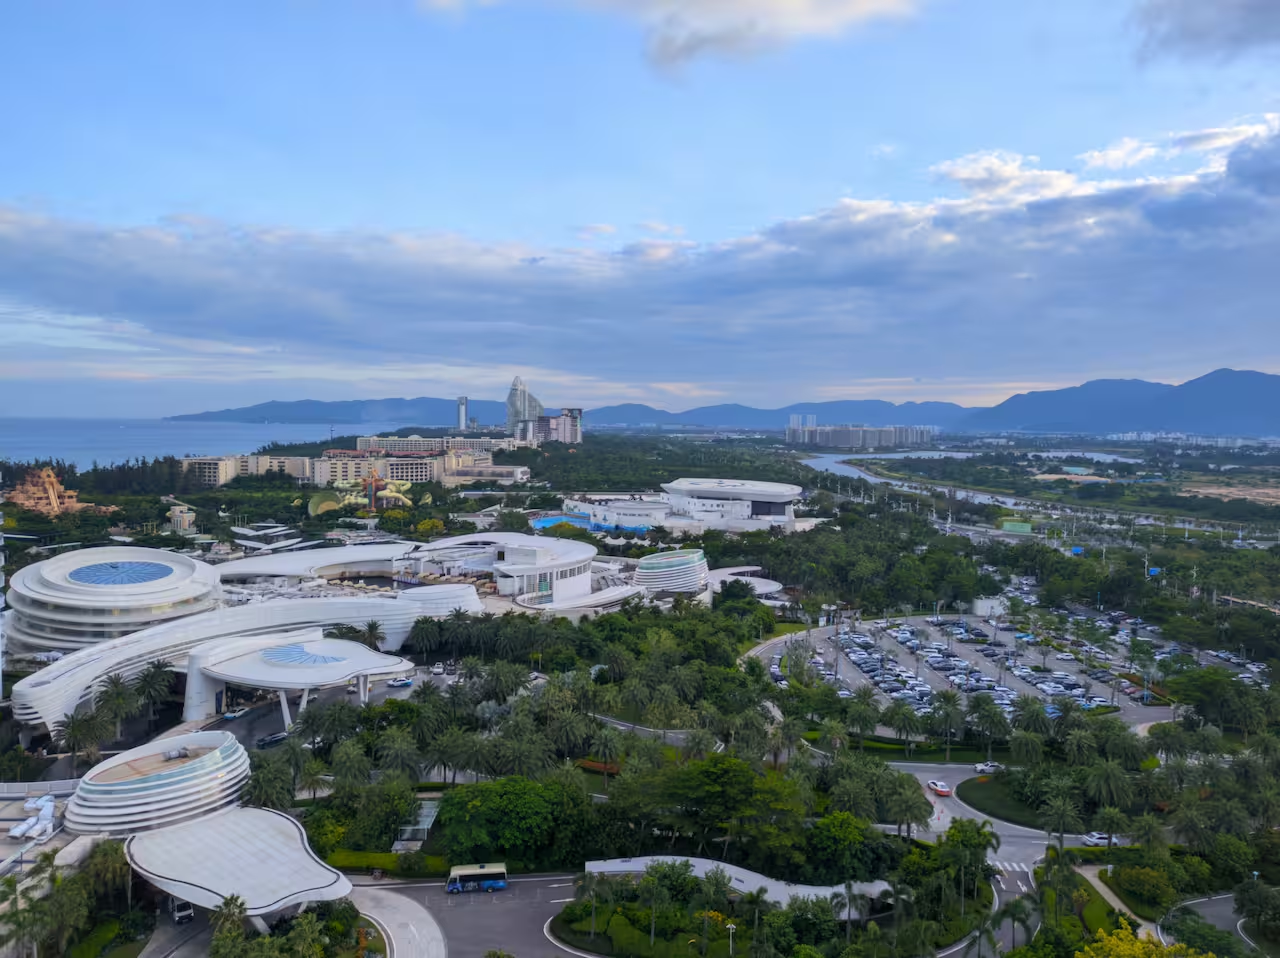
亚特兰蒂斯水世界,人比较多,但是其实好玩的就那么几样。大喇叭 小喇叭 放手一搏 鲨鱼竞速 小船漂流都玩了,当天其实在下雨,反正会湿身,又不晒,哈哈。
第四天不知道玩点啥,找了个往机场方向的酒店,搜了下 三亚,陵水,万宁,琼海,文昌,这一路全都是海滩和酒店,随便找了个,打算去 南湾猴岛 看看。
南湾猴岛观光索道100+,我肯定舍不得,查到攻略,如果喂猴子可以导航 去 南湾村民委员会,果然一路都是。比峨眉山的猴子好些,没那么凶狠。一路开到海边,顺便看了眼 呆呆岛
下午就去机场了,无聊就沿着海岸的观光公路一直开,开到博鳌 红石滩,想赶海,发现没工具,花10买了个铲子,毛都没挖到。最后挖到个很小的贝壳,以及极小的寄居蟹。也算有收获吧
一路上发现海南很多散养的黄牛 水牛在路边,草地里悠闲地吃草。
晚上充电,还车,BAR起飞回家;
总体感受,做计划真累,真想啥都不做躺几天。不知道这辈子能肉眼看上火箭发射不。
2026-08-31 11:35:00
In case you weren't aware, there's quite a debate over httpx v1.0 release, especially maintainer of both openai-python and anthropic-sdk-python showed up and decided to switch to httpx2, a fork of httpx that maintains v0.28 styles
httpx is a Python library that can handle both sync/async http, replacing requests (sync-only) and aiohttp (async-opnly).
You can view original discussion starting here https://github.com/encode/httpx/discussions/3344
The maintainer closed discussion and issues
verify= and cert= → explicit ssl.SSLContext
for version < v1.0
# Boolean on/off — still fine, not deprecated
httpx.Client(verify=True)   # default: verify using certifi's CA bundle
httpx.Client(verify=False)  # danger: accept any certificate

# String path — NOW DEPRECATED, raises a warning
httpx.Client(verify="/path/to/custom-ca-bundle.pem")

# cert= for a client certificate (mutual TLS) — NOW DEPRECATED
httpx.Client(cert=("/path/to/client.pem", "/path/to/client.key"))
v1.0
import ssl, certifi, httpx

# Equivalent to default verify=True
ctx = ssl.create_default_context(cafile=certifi.where())
httpx.Client(verify=ctx)

# Custom CA bundle
ctx = ssl.create_default_context(cafile="/path/to/custom-ca-bundle.pem")
httpx.Client(verify=ctx)

# Client certificate (mutual TLS) is now loaded onto the context itself
ctx = ssl.create_default_context(cafile=certifi.where())
ctx.load_cert_chain("/path/to/client.pem", "/path/to/client.key")
httpx.Client(verify=ctx)
proxies= → proxy= / mounts=
Before:
# Old dict-based per-scheme mapping
httpx.Client(proxies={"http://": "http://localhost:8030", "https://": "http://localhost:8031"})
After:
# Single proxy for everything
httpx.Client(proxy="http://localhost:8030")

# Per-scheme routing via mounts (a dict of URL-pattern -> Transport)
httpx.Client(mounts={
    "http://": httpx.HTTPTransport(proxy="http://localhost:8030"),
    "https://": httpx.HTTPTransport(proxy="http://localhost:8031"),
})
app= shortcut → explicit transport=
What app= was for: letting you point a Client directly at a WSGI or ASGI Python callable instead of a URL, so you could test your web app without spinning up a real server.
Before:
httpx.Client(app=my_asgi_app, base_url="http://testserver")
After:
httpx.Client(transport=httpx.ASGITransport(app=my_asgi_app), base_url="http://testserver")
# or for WSGI:
httpx.Client(transport=httpx.WSGITransport(app=my_wsgi_app), base_url="http://testserver")
allow_redirects= → follow_redirects=, default flipped to False
What changed: in the 0.20 release, redirects stopped being followed automatically by default.
Before (pre-0.20 behavior, and the old kwarg name):
httpx.get("http://api.github.com/")
# silently redirects http -> https, meaning every request was actually sent twice
After:
httpx.get("http://api.github.com/", follow_redirects=True)  # opt-in explicitly
# or
httpx.Client(follow_redirects=True)  # opt-in for the whole client
The maintainers gave a concrete example — a client configured for http://api.github.com/ was silently sending every single request twice (once to get redirected, once to the real HTTPS URL), wasting a round-trip nobody asked for. They decided implicit redirect-following causes more surprise bugs (accidentally hitting an endpoint twice, e.g. a payment POST) than it saves typing, so it became opt-in. This was explicitly flagged as "no universally right answer, just a trade-off" in their own release notes.
Before: json={"a": 1, "b": 2} serialized with the stdlib default spacing → {"a": 1, "b": 2} (space after : and ,).
After: same call now serializes to {"a":1,"b":2} (no extra spaces).
This is a good change!
Before: spaces in query params encoded as +, and / inside a query value encoded as %2F (this is the old application/x-www-form-urlencoded-style behavior, same as requests).
After: spaces encoded as %20, and / left unescaped in the query portion (matches how Chrome/Safari/Firefox actually build URLs, per the WHATWG spec rather than the older RFC 3986 reading).
# requests-style / old httpx:
"?q=hello+world&path=a%2Fb"
# new httpx:
"?q=hello%20world&path=a/b"
This is a case where IETF RFC3986 vs. WHATWG's disagree, and real browsers follow WHATWG.
.netrc handling → explicit httpx.NetRCAuth()
Before: if you had a ~/.netrc file, httpx would silently pick up and use those credentials on any matching request.
After:
httpx.get(url, auth=httpx.NetRCAuth())
Silently reading a credentials file from disk shouldn't be done by default.
response.iter_lines() behaviorBefore: yielded lines including trailing newline characters ("line one\n").
After: matches Python's own str.splitlines() / file-iteration convention — newlines stripped ("line one"), and a related performance bug fixed.
Matching stdlib conventions (for line in file: style) is less surprising than inventing your own line-splitting semantics.
QueryParams became immutableBefore (implied by the old API): client.params.update(...) mutated in place.
After:
client.params = client.params.merge({"key": "value"})
# or the more granular:
params.set("key", "value")
params.add("key", "value")     # allow duplicate keys
params.remove("key")
Mutable shared state (like a dict) attached to a client is a classic source of bugs
Background: today, one package gives you both a blocking (Client) and non-blocking (AsyncClient) interface, because under the hood both share the same code via a code-generation trick (unasync) that turns the async source into the sync version automatically at build time.
Before:
import httpx
r = httpx.get("https://example.org")          # sync

async def main():
    async with httpx.AsyncClient() as cli:
        r = await cli.get("https://example.org")   # async
After (previewed):
# pip install httpx
import httpx
r = httpx.get("https://example.org")           # sync only

# pip install ahttpx   <-- a *different* package
import ahttpx
r = await ahttpx.get("https://example.org")    # async only
The maintainers reasoned that if you only ever use the sync client, you're still forced to install anyio and sniffio (async-support dependencies) that you never touch. Splitting the packages lets sync-only users have a genuinely smaller dependency tree, and removes the slightly awkward Client/AsyncClient naming duplication in favor of one name per package.
The controversy (worth knowing about): this is the most contested item in the whole redesign. Simon Willison and several SDK maintainers (including Anthropic's and OpenAI's own Python SDK maintainers, both of which depend on httpx<1) argued in the public discussion that Python's inability to install two versions of the same package side-by-side means a hard breaking split could fragment the ecosystem for a long transition window, similar to what happened with Pydantic 1→2. Proposed alternatives floated in that thread include shipping the new design under a different name entirely (httpx2) or keeping both old and new APIs inside one package under a versioned namespace (httpx.v1). None of this is resolved as of the latest visible discussion activity.
My take: The whole reason why ppl chose httpx over aiohttp is because it can handle both.
json=, data=, files= shortcuts replaced by typed content= objectsBackground: today httpx (like requests before it) offers three different keyword arguments depending on what kind of body you're sending, and picks the right Content-Type header for you based on which one you used.
Before:
client.post(url, json={"key": "value"})                       # application/json
client.post(url, data={"key": "value"})                       # form-urlencoded
client.post(url, files={"upload": open("report.pdf", "rb")})  # multipart/form-data
client.post(url, data={"name": "a"}, files={"upload": f})      # mixed form + file
After (previewed):
client.post(url, content=httpx.JSON({"key": "value"}))
client.post(url, content=httpx.Form({"key": "value"}))
client.post(url, content=httpx.Files({"upload": httpx.File("report.pdf")}))
client.post(url, content=httpx.MultiPart(
    form={"name": "a"},
    files={"upload": httpx.File("report.pdf")},
))
Java boi's fantacy to please the type checker.
Background: currently timeout= accepts a bare float, a tuple of floats, or a Timeout instance; proxy= accepts a string, a URL, or a Proxy instance; similar flexibility exists for auth= and headers=.
The design-call notes floated constraining these to fewer accepted shapes for clarity, but a maintainer pushed back in the same conversation that "it's not clear tightening the API types is a better user experience and could cause churn" — so this one is explicitly unresolved, not a committed change.
# `proxy=` → `ProxyTypes`
httpx.Client(proxy="http://localhost:8030")                 # plain string
httpx.Client(proxy=httpx.URL("http://localhost:8030"))       # URL object
httpx.Client(proxy=httpx.Proxy("http://localhost:8030"))     # Proxy object, needed if you
                                                              # also want proxy auth/headers
# `timeout=` → `TimeoutTypes`
httpx.Client(timeout=10.0)                 # single float applied to connect/read/write/pool
httpx.Client(timeout=None)                 # disable timeouts entirely
httpx.Client(timeout=httpx.Timeout(connect=5.0, read=30.0, write=10.0, pool=5.0))  # explicit object

# `auth=` → `AuthTypes`
httpx.get(url, auth=("username", "password"))   # 2-tuple -> Basic auth
httpx.get(url, auth=httpx.DigestAuth("username", "password"))  # explicit Auth subclass
httpx.get(url, auth=my_callable)                 # any callable(request) -> request, via FunctionAuth

# `headers=` → `HeaderTypes`
httpx.get(url, headers={"User-Agent": "my-app"})              # plain dict
httpx.get(url, headers=[("User-Agent", "my-app")])             # list of tuples (allows duplicate keys)
httpx.get(url, headers=httpx.Headers({"User-Agent": "my-app"}))  # explicit Headers object
tl;dr httpx v1.0 is trying to giving type system a handjob like Java


