2026-11-18 13:16:09
我就职的公司东海集团(Shopee 母公司)拓展 AI 云业务(neocloud),现在招聘计算、存储、网络方面的人才,是一个进入 AI Infra 领域很好的机会,以下是一个初级岗位和一个高级岗位的职位介绍。年限并不是硬性要求,有兴趣都可以发来简历试一试,邮箱是博客侧边栏的地址。这两个岗位目前都没有工作签证,要求应聘者必须在新加坡且有 PR 或 SC。
其一
Level: Graduate / 0–2 years · Location: Singapore
Sea Cloud gives businesses and developers the infrastructure to build, train and run AI at scale: GPU compute, storage, networking, managed Kubernetes and model APIs, delivered as a public cloud.
The Compute and Storage SRE team delivers and provisions the platform’s foundation products and keeps them available, fast and durable: virtual machines, managed Kubernetes, block storage, object storage, and the traffic gateways that put them in front of customers. We combine software and systems engineering: we build the automation and observability that run these services, define and defend service-level objectives, write the standard operating procedures (SOPs) the platform runs on, and lead the response when things go wrong. We also prove resilience rather than assume it, through chaos engineering and platform-level disaster-recovery fire drills, and we harden the platform’s security and strengthen its compliance controls.
Join us to help build and run a cloud platform, where your work shapes how the service is run for years to come.
其二
Level: Senior / 6+ years
Location: Singapore
Sea Cloud gives businesses and developers the infrastructure to build, train and run AI at scale: GPU compute, storage, networking, managed Kubernetes and model APIs, delivered as a public cloud.
The Compute and Storage SRE team delivers and provisions the platform’s foundation products and keeps them available, fast and durable: virtual machines, managed Kubernetes, block storage, object storage, and the traffic gateways that put them in front of customers. We combine software and systems engineering: we build the automation and observability that run these services, define and defend service-level objectives, write the standard operating procedures (SOPs) the platform runs on, and lead the response when things go wrong. We also prove resilience rather than assume it, through chaos engineering and platform-level disaster-recovery fire drills, and we harden the platform’s security and strengthen its compliance controls.
Join us to help build and run a cloud platform, where your work shapes how the service is run for years to come.
2026-11-11 23:12:22
在一次公司的培训上,一个同事带了一个塑料水瓶,我看见过这种塑料瓶子很多次,我问他是从哪里买的。他说,新加坡人在上学的时候基本每人都有一个,这家公司 make product for generations,可以用很久。他的这个水瓶是他上学的时候买的。
Make product for generations. 这也是我喜欢的理念。
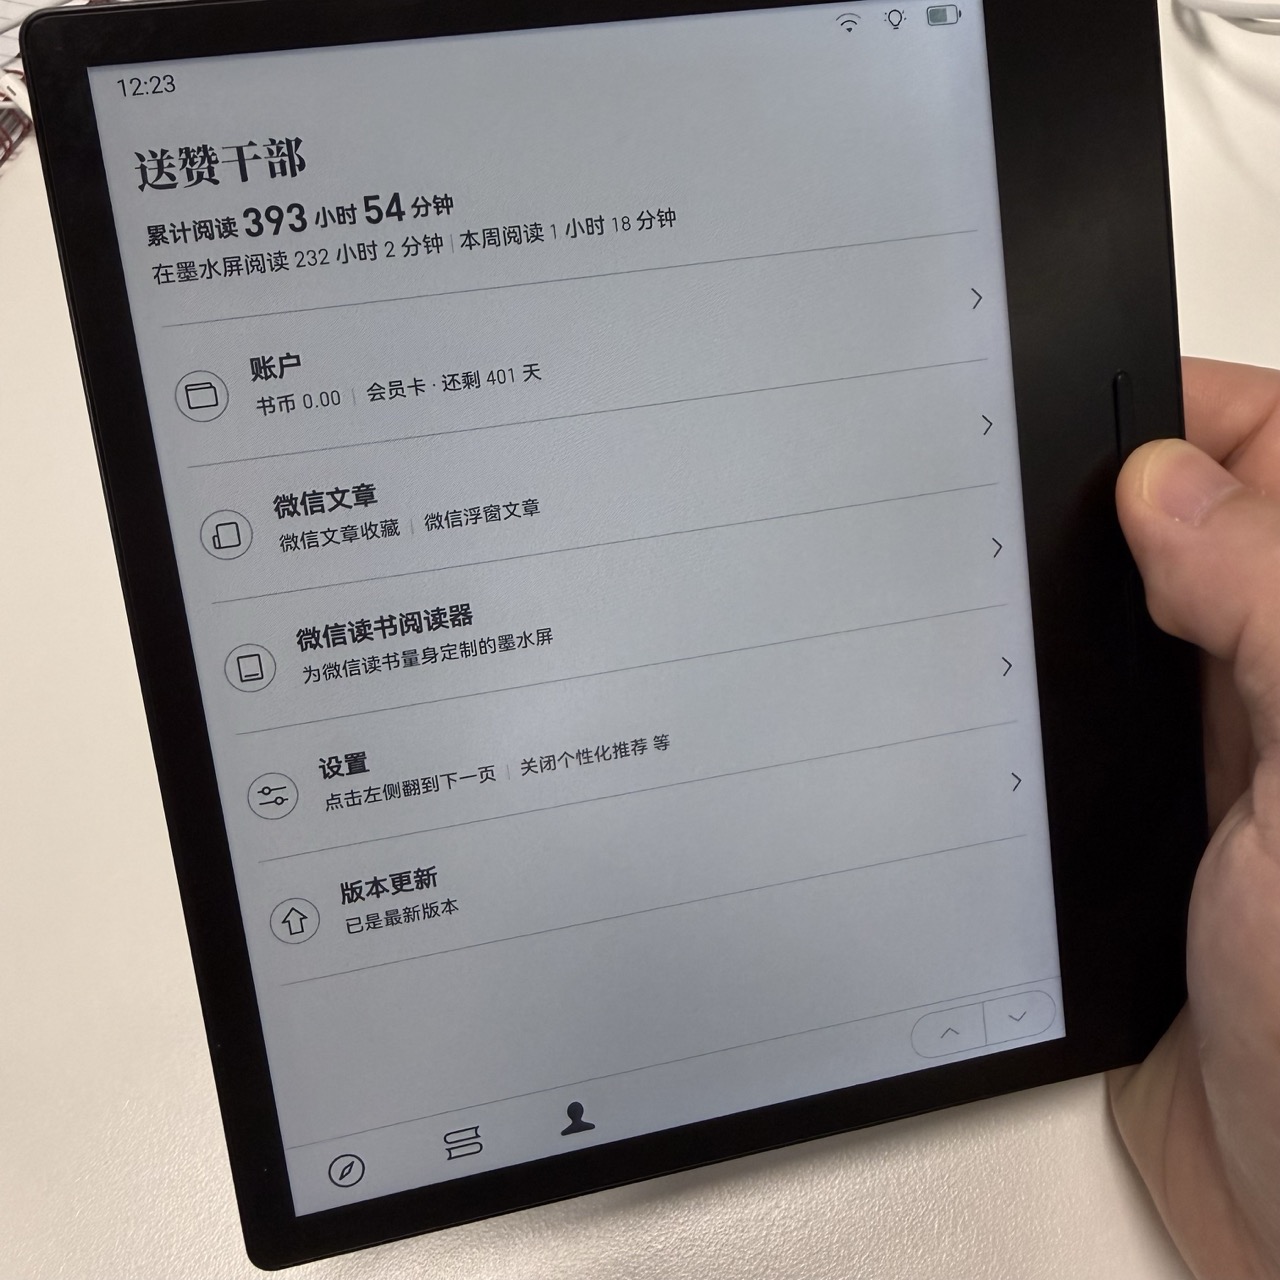
去年买过一个电纸书(什么牌子的并不重要,主要是我想读微信读书里面的资源,随便找了一个支持微信读书的),然后这一年来完成了微信的阅读挑战,即读了 300 个小时,持续 360 天。感觉非常值。
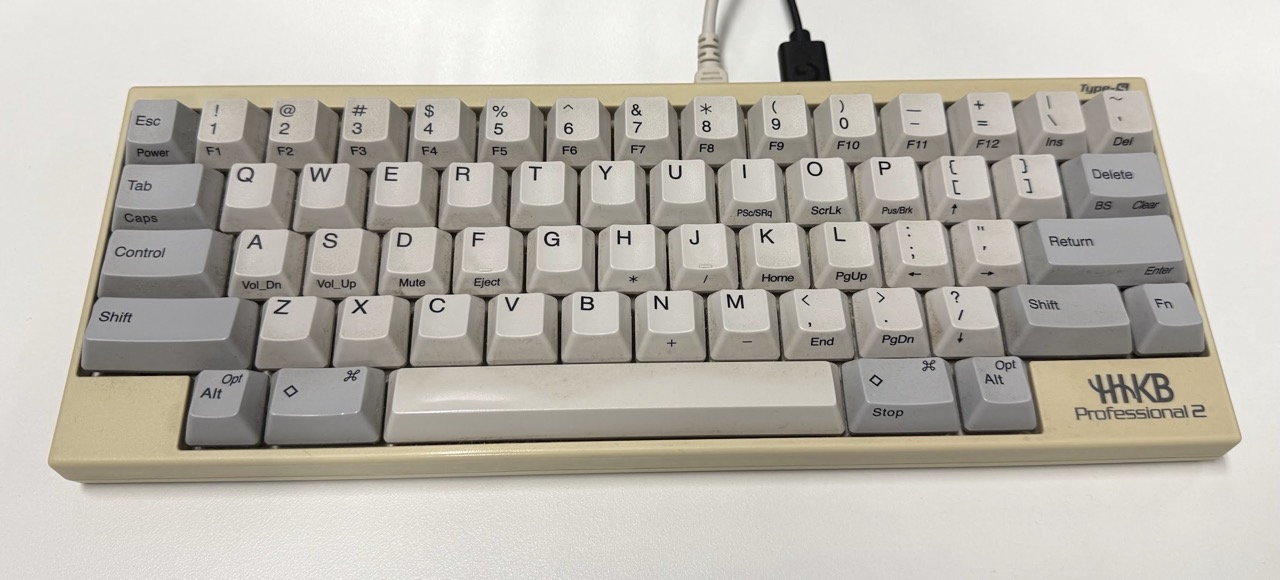
在 10 年前买过一个 HHKB 键盘,白色的外壳已经发黄了,但是所有的功能仍完好,今天依然在服役。HHKB 也是一个好产品,键位设计的合理,基本没有按键是闲置浪费的,也没有按键是缺失的。
我只用过 3 个 iphone,iphone 6s,iphone 12 mini,以及现在在用的 iphone 16 pro。iphone 也是很好的产品,事实上的很耐用。不过我现在在手机上的时间少了,我基本不看社交媒体了,微信朋友圈也不看,用的最多的软件是 chatGPT 和 youtube 看视频。身边的人比网上的人要重要的一些。应该多花点时间在线下的社交。手机的操作效率比电脑低多了,屏幕小,也没有键盘,所以我用电脑比较多。
在买东西上,我经常觉得应该这么算账:假设一部手机售价是 5000 元,这只是一个账面够买价值。实际你支出的价值是 (5000 元 – 最后的剩余成本) / 使用时间。比如,5000 元购买,使用1年之后,以 3000 元售出,那么实际成本是 2000 元/年。但是如果和我一样,5000元购买之后,用了4年,用完之后放在那里也懒得卖掉了,成本就是 5000 元/4年 = 1250元/年。考虑到使用的时间,就可以很轻松地得到结论:我们应该坚持长期主义,购买可以用很久的商品。
这样一来,购买时候的成本多几百少几百就不怎么重要了。要看自己之后是不是会长期使用才比较重要。
第二个消费理念是:商品是服务于人的。所以我不喜欢购买超出自己需要的、买有经济压力的昂贵商品。
比如说,我用手机一般不会贴膜和戴手机壳,拿起来很不舒服,但是前提是不会买超出负担能力的贵手机。这样磕了也不会心疼。
比如说背包,我也不会买很贵的,我会买实用的,又可以用比较久的。
这样决策成本也比较低,即使买来不合适,投入的成本也比较低。可以后悔。
很多商品的边际效用随价格上涨递减非常快,意思是,达到 80% 的品质只需要一个稍贵的价格即可,但是达到 90% 就可能需要额外付出 50% 的成本。原因一般是技术成本较高,以及市场不大,就需要很少的目标用户去平摊昂贵的开发成本。我一般不去平摊这些开发成本,因为我知道自己不需要。
想到这里是因为今天看了一个视频:Signs upgrading will make your life worse2,买更好的东西会让你失去自由。比如买了一辆很贵的车,有一点划痕心里就会很难受。
除了买比较贵的东西,买不需要的东西也会增加负担。买了本不需要的东西,由于前面那条理念的存在,需要持续使用才能降低持有成本,这样也会失去一部分自由。
说到自由,我也基本不考虑参加积分类型的会员机制,对于促销,基本只看考虑当下消费立减可以便宜多少钱。积分类型的会员促销也会失去一部分消费自由。
什么时候需要真正地付出更高的价格去升级呢?一般来说我能清楚地知道下一级别的商品会给自己带来什么,比如技术的提供,比如现在遇到了瓶颈。举一个反例,我用菜刀就从没遇到过这种瓶颈,强如王刚也说,菜刀是磨出来的,买什么样的菜刀都是一样,主要靠磨。我发现确实是这样,花 10 块钱买一个磨石比花 200 买一把好刀更重要。
这样的消费理念伴随我多年,works for me.
(不过最近几年的物欲极低,应该是我的兴趣都是在软件上面了,硬件上面只要一台电脑就够了)
2026-10-29 18:37:24
一起去上班路上:
欣:你喜欢玩什么游戏?
我:啥?
欣:我同事聊起来游戏,他们问我你玩什么游戏。
我:那一定是魂系游戏,艾尔登法环,血缘诅咒,黑暗之魂。
欣:那是啥?我说你平时玩的多的是那个抓鱼的,潜水员戴夫,超级玛丽,马里奥赛车。
……
2026-10-26 16:09:23
上周在 NUS 做了一个分享,内容是 SRE 的工作内容和成长路线。下面是录制的视频。
涉及的数据和 incident 是从网上找的公开案例,不是我就职的公司的真实数据。
2026-10-17 17:54:55
这一篇计划很久了还没有写,今天终于开始下笔了。
许久无从下笔的原因是,网络问题排查——哦不,应该说不光网络,基本所有的问题排查,都是这样——思路相比于技巧要重要很多。思路,简单来说就是几句话的事情:
核心就是一句话,「基于事实猜测」,如果实践起来,却不是那么容易。顺藤摸瓜的正确排查方法是需要大量的基础以及经验支撑的,并不是什么独门秘籍,可以让人瞬间开悟的东西。
但还是有一些规律可以遵循。
一般的问题定位,第一步是明确问题。很多人表达问题不清楚的,与这种人沟通很容易就陷入了 X Y 问题1。所以无比问清楚:现在问题是什么,网络从哪里到哪里不通,预期的结果是什么。在非常复杂的网络环境下,需要收集必要的信息,比如有没有 overlay,有没有一些特殊的配置。可能问题的报告者也说不清,大部分情况需要自己收集信息。
第二步就是复现问题。如果问题没有办法复现,就很难解决。如果可以复现,基本就解决了 90% 了。我自己最怕的问题也是无法复现的问题,比如高流量的偶尔延迟高,复现的现象定义不明确,复现条件也不明确。有一些工具可以使用,比如 iperf,scapy,或者自己写一些程序2来复现。有人遇到问题直接去查有没有变更,去看监控,这就像无头苍蝇。从根本解决问题,第一步一定是复现,最后一步对应的,是确定之前复现的场景下问题已经解决了。当然了,如果是线上的故障,立即查找变更和监控是正确的,应该需要在不明确根因的情况下能够恢复故障的手段。
第三步就很简单了,根据现象,做合理的假设,测试,逐步排除错误的假设,剩下的就是正确的答案。
时间长了,每个人都会积累一些技巧。比如,在最近的上一篇博客中使用到的,找一个正常的机器,进行比较一下。积累也是一个比较重要的过程,我喜欢把有意思的 case 都记录下载,对我很有帮助。
我发现厉害的人(偶尔,我自己也是),在看相同的信息的时候可以得到更多的结论。比如看到同样一个网络问题,使用同样的工具查看,别人说是网络不通,高手通过 curl -v 看发现是网络可以连接,而服务器没有返回内容。就把问题进一步定位到了 7 层问题,可能是 LB,WAF,application 的问题,但不会是路由或者 TCP 的问题。再比如,看到同样一个 MTR,高手可以分析出来默认网关有没有问题,出机房有没有问题,是单设备的问题还是某一跳的问题。
这是一种很酷的能力:能够在有限的环境里面定位到根本问题。
又想起来一个例子,我们经常需要网工给我们配置路由,但是配置好了没有?我们无从得知,因为我们没有交换机的登录权限。遇到问题的时候,低手会直接去麻烦人家,问问这个路由配置好了没,人家说好了,也没有办法验证是不是真的好了。高手在麻烦人家之前必然会提供相应的证据,比如,使用 traceroute,目标为这个网段的任意一个 IP,能不能 ping 通并不重要,重要的是看网工配置的交换机有没有出现在 traceroute 里面。这样报告问题,无法甩锅,解决问题的速度也快。
就写到这里,有很多大道理讲,但是讲起来没有什么说服力。好在日常已经积累了很多问题排查的博客,写具体的例子还是比较有意思。读者可以关注一下我的这类文章。
对了,在 AI 时代,如今大部分问题 AI 如果有权限都可以排查出来了,我们人类排查问题的技能还有用吗?
当然是有的,排查问题,解决问题,再想怎么一劳永逸地解决问题,对最终的质量负责,还是需要人的。如果你把一个系统完全交给 AI,AI 来应对用户的问题和需求,这里面没有了人做 trade off,感觉过不久就会变成非常大的一坨屎吧。
不过这也是现在,说不定多段时间 AI 真的可以完全自主运行系统了。在那之前,我们还是好好享受技术带来的快乐和成就感吧。
 ︎
︎
通过真实故障和抓包文件,学习网络分析与故障排查。
这篇文章是抓包破案录系列文章(之前叫做《计算机网络实用技术》,后来改名了)中的一篇,这个系列正在连载中,我计划用这个系列的文章来分享一些网络抓包分析的实用技术。这些文章都是总结了我的工作经历中遇到的问题,经过精心构造和编写,每个文件附带抓包文件,通过实战来学习网络抓包与分析。
如果本文对您有帮助,欢迎扫博客右侧二维码打赏支持,正是订阅者的支持,让我公开写这个系列成为可能,感谢!
如果您正在阅读的是题目类的文章,这个目录内容正好用来隔离其他读者的评论。读完题目可以稍作暂停,进行思考,继续向下滑动,可能会被其他的读者剧透答案。
与本博客的其他页面不同,本页面使用 署名-非商业性使用-禁止演绎 4.0 国际 协议。
2026-09-24 14:09:24
记录一下最近排查的一个问题:某台机器一上线就有丢包,同 Rack 同规格的其他机器都没有问题,由于负载都是一样的,所以问题集中到这台机器本身的问题。已经可以 100% 复现,只要一接流量,网卡就开始时不时的丢包。
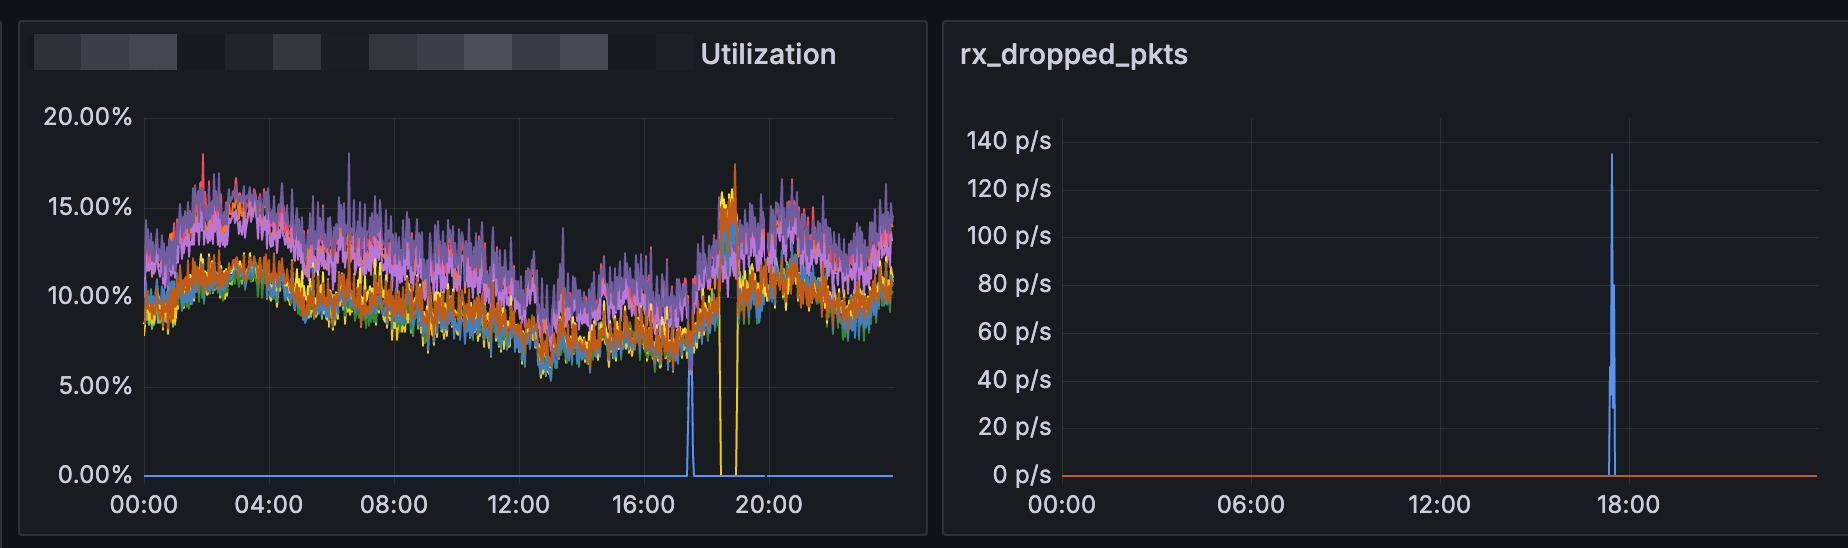
初步检查:网卡的 CRC 正常,光模块正常。(这些一般是丢包的常见问题)
仔细检查网卡的计数器,发现丢包发生在 rx_prio0_buf_discard: 397172。
中间经历了很多错误的排查思路,比如这个 metric 是每一个 NIC 都有一个,但是 driver 的实现应该是用了同一个 metric,因为 2 个 NIC 的数字总是相同的。
以为是 DCB 的 buffer 不够,尝试了调大 DCB 的 buffer。
$ dcb buffer show dev enp94s0f1np1
prio-buffer 0:0 1:0 2:0 3:0 4:0 5:0 6:0 7:0
buffer-size 0:20016b 1:0b 2:0b 3:0b 4:0b 5:0b 6:0b 7:0b
total-size 216288b
发现 buffer 大了丢包反而更严重了一些,buffer 调小也是有丢包。应该是和 buffer 无关。
由于是 rx 的丢包,应该是 ingress 的处理能力不足,接下来的排查包括了:
……都没有效果。
中间经历了一次大促,容量足够,就暂停排查了,这周又开始继续。
好像和网卡有关的东西检查都是正常的,同事建议换一张网卡试试。换之前我使出了最后的一招:server diff.
server diff 是我排查问题作为没有思路之后的一个手段,可以简化成一段 skill:
这是一个正常的机器,这是一个异常的机器。你对比一下两个机器之间的 sysctl 参数,kernel 参数,硬件规格,看下两台机器有什么不一样的部分。
AI 发现的问题如下:
能找到的差异点(按怀疑程度排)
- 硬件/内存健康 IPMI SEL:08/31 16:46 和 16:49 两次 Uncorrectable ECC DIMMB5;mcelog 有 08/31 15:39 一条 Memory read corrected error;随后 08/31、09/02、09/03 连续多次重启。DIMM 全是 Micron 36ASF4G72PZ-3G2J3(.144 是 Samsung M393A4K40DB3-CWE),B5 序列号 2E313345,看不出被换过。 本次启动(09-03)以来 EDAC ce/ue 都是 0,但 Dell 在 UE/CE 后可能进入 ADDDC/lockstep 降级模式, 会拉低内存带宽/延迟。 保留意见:网卡在 NUMA node0(CPU1/A 组),B5 属于 CPU2(B 组),RX ring 页也在 node0, 理论上不直接受影响;但这台机器的内存子系统整体存疑。
- …
这是非常可疑的一个点,Linux 的收包链路上,NIC DMA 到内存1,路线是:
PCIe NIC → PCIe Root Port/Root Complex → IOMMU → CPU Mesh/Interconnect → LLC(L3) / Memory Controller → DRAM
内存子系统异常会显著降低 host RX path 的处理和 buffer 回收能力,可能进一步造成 NIC ingress buffer 无法及时 drain,最终表现为 rx_prio0_buf_discard。
于是我下线机器之后测试内存的带宽,我们使用的服务器有 2 个 CPU,2 个 NUMA node,于是分别测试。
测试使用 stream.c 2结果如下:
$  numactl -C 2 -m 0 ./stream
Copy:           10419.3     0.015583     0.015356     0.016709
Scale:          11657.5     0.013985     0.013725     0.014751
Add:            13445.3     0.018228     0.017850     0.018540
Triad:          13297.1     0.018250     0.018049     0.018966
$  numactl -C 2 -m 1 ./stream
Copy:             648.4     0.251102     0.246778     0.258519
Scale:            619.4     0.277245     0.258311     0.338792
Add:              668.6     0.382864     0.358960     0.420878
Triad:            665.1     0.378978     0.360838     0.429338
$  numactl -C 3 -m 0 ./stream
Copy:           13936.3     0.011795     0.011481     0.012645
Scale:           8038.1     0.020416     0.019905     0.021659
Add:             9287.6     0.028779     0.025841     0.049315
Triad:           9252.8     0.026599     0.025938     0.027369
$  numactl -C 3 -m 1 ./stream
Copy:            1626.5     0.103622     0.098372     0.116646
Scale:            652.1     0.258530     0.245347     0.309194
Add:              710.6     0.346138     0.337722     0.377382
Triad:            711.2     0.344051     0.337455     0.349108
(CPU 2 和 3 分别在 NUMA node 0 和 1)
可以看到,node 1 的内存,无论是同 NUMA node local 读写还是跨 NUMA remote 读写,速度只有区区 700MB,性能只有 node 0 的 1/17,确定 node 1 的内存有问题了。
进一步验证,由于我们使用的 NIC 是双网口 bond,port 1 的中断绑定到 node 0 的 CPU,port 2 的中断都绑定到 node 1 的 CPU,(这样提高 CPU 的利用率,又提供稳定的转发延迟)。所以可以通过关闭 port 2 来关闭 node 1 的使用,验证只有 node 1 的内存有问题。
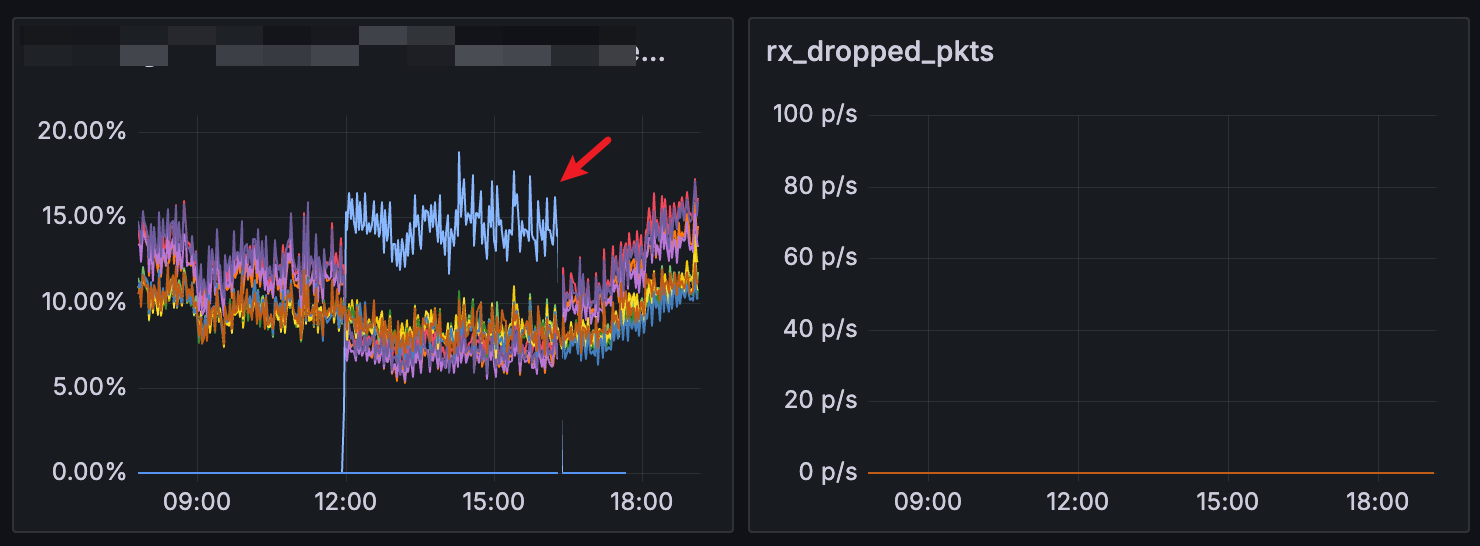
关闭一个网卡之后上线,再也没有发现有丢包。
 ︎
︎


