
美团正式开源 LongCat-2.5,采用 MIT 协议,支持商用推理部署与二次训练,无需额外授权。
LongCat-2.5是面向长程智能体任务的原生多模态模型,在复杂代码库开发、完整项目构建、Visual Coding 与专业办公场景中,端到端交付能力均有明显提升。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文。针对显存与带宽受限的国产算力芯片,我们在模型架构、芯片适配与部署策略上也进行了深度协同优化。

完整分数与评测条件参见技术博客
LongCat-2.5 的长程能力提升,来自一整条训练链路的扩展,而非单点改动。这些设计不改变模型能力的定义,但让能力在长任务中稳定发挥。
第一,更贴近真实长程任务的训练数据。加入更多长程轨迹,并把真实 Agent 的失败轨迹转为可复现、可验证的训练任务。
第二,更适配长任务节奏的强化学习。采用partial rollout 异步训练,让未跑完的长任务保存后续跑;过采样率按通过率动态调整,过滤全对全错的样本组;对跨 checkpoint 的旧轨迹做梯度校正,降低陈旧偏差。
第三,更有效减少“钻空子”的训练约束。任务环境断网、清除 git 历史与文件缓存,以 LLM judge 监督轨迹;对重复思考、重复工具调用、过度思考施加约束,让模型专注完成任务。
| 查看开发者们的端到端测评示例,可帮助大家观察模型在真实使用流程中的表现。
LongCat-2.5 在 Visual Coding 上表现出色,支持创意设计、3D 等任务。这些能力提升来自视觉表征层的改造:模型将视觉信号表示为多层级离散 token,与文本一样由主干模型统一处理,而非外挂视觉模块。具体而言,模型对原生分辨率视觉特征做残差向量量化,逐级补足细节;视觉 token 可离线预计算并缓存,减少在线计算量,也让分布式训练负载更均衡;视觉码本与主干联合训练,视觉与文本共享同一套主干参数,在同一语义空间内协同完成视觉理解与代码生成。
| 查看开发者们的端到端测评示例,可帮助大家观察模型在真实使用流程中的表现。
专业办公场景对模型的要求,不是单点问答,而是同时完成几件事:读得多份材料,抓得住关键信息,形成专业判断,并把判断转化为规范、可用的交付物。LongCat-2.5 在这个场景的提升也围绕这条链路展开:材料处理更稳,专业判断更贴近分析人员,报告、演示文稿和办公工具能够端到端交付,多轮任务执行更可靠。目标不是为每个场景单独建模,而是让主线模型具备端到端完成专业办公任务的能力。
支撑这些提升的,是一组相互配合的技术设计。多专家在线教学负责将领域能力融入主线模型:学生先自主作答,专家再通过全词表 KL 散度纠正其概率分布;教师回复按固定长度切分以控制分布偏移;采样时共享 prefill 与 KV cache;训练时使用 Tree Attention,通过单次前传和反传处理同组样本。大规模智能体强化学习提升长程执行与工具调用能力,跨任务、跨 Scaffold 的混合训练增强泛化;原生视觉理解支撑 PPT 与报告中的视觉内容生成,长上下文 rollout 优化支撑长程强化学习的高效运行。
| 点击查看 LongCat-2.5 端到端生成的真实演示。
推理效率是模型能否真正落地的关键。LongCat-2.5 采用 W4A4 高效推理方案,将专家权重与激活同时量化到 4 bit,并通过原生 INT4 矩阵乘法单元执行计算。
精度方面,我们以 FlatQuant 的可学习等价变换为基础优化 MoE 量化精度,已评测的下游任务表现与量化前保持相当。算子与数据路径方面,专家共享输入变换,在 token 复制与分发前完成量化,使同一份 INT4 表示贯穿专家通信与计算;变换、尺度计算、量化与打包融合为专用算子,并结合权重布局与转置访问优化,减少数据搬运与转换开销。系统层面,针对 Prefill 偏重批量计算、Decode 偏重逐 token 推进与通信的特点,分别优化计算与通信的流水重叠,减少互相等待。W4A4让 LongCat-2.5 在保持下游任务表现的同时降低推理成本,为 1.6 万亿级 MoE 模型的开源部署提供了可用的效率基础。
LongCat-2.5 在训练与监督微调阶段均采用长序列训练。国产算力环境下,单卡显存不足 80GB,是长序列训练与微调必须面对的现实约束。
我们以分片将显存压力分散至超节点内多卡,以拓扑感知的并行策略降低跨节点通信开销,并让通信与计算尽可能重叠。具体而言,FSDP 双重分片与扁平化缓冲区降低常驻显存与峰值显存;混合词表并行进一步压缩显存占用;参数 AllGather、专家 token AllToAll 与 KV AllGather 尽量在超节点内高带宽互联域完成;MoonEP 动态专家复制仅在负载不均衡达到阈值时启用,避免额外通信开销超过收益;零拷贝通信、参数预取与 ScMoE 则使通信与计算重叠执行。
这套方案的工程价值在于:在单卡显存不足 80 GB 的国产 AI 加速器上实现了长序列训练与微调;多卡扩展时,通信开销与负载不均衡也有对应机制支撑。该 FSDP 配置在长序列 SFT 任务中的单卡吞吐量较 DDP 基线提升 86%,表明长序列训练在国产算力上不仅可行,而且高效,为社区复现与二次开发提供了一条可参考的基础设施路径。
LongCat-2.5 以 MIT 协议开源,支持商用推理部署与二次训练,无需额外授权。我们之所以选择这一协议,是因为希望模型能被自由使用、修改与再分发,也便于社区在此基础上继续工作。
国产算力是我们长期投入的方向,也是持续创新的现场。显存与带宽的边界实际存在,我们能改变的只有架构、算子与并行策略,改动在细处,进展在实处。在单卡显存不足 80GB 的条件下承载万亿参数 MoE,需要在架构、量化、并行与通信之间反复取舍。这些取舍是与产业伙伴一同完成的,也让我们对这条路径有了更具体的判断。
生态的成熟,很少来自单点的突破。它需要真实负载的持续检验,需要芯片、框架与应用在同一处磨合,也需要有人愿意把最难的任务先放上去。我们会继续开放模型与工程经验,与同行一起,把这条路走宽。
美团正式发布 LongCat-2.5,这是一个面向长程智能体任务的原生多模态模型。模型总参数量为 1.6 万亿,每个 token 激活约 480 亿参数,在 LongCat-2.0 的基础上进一步强化了原生视觉理解与智能体编程能力。
新模型在长程智能体任务中有明显效果提升,这源于我们在长序列训练中加入了更多长程轨迹数据,并通过大规模长程强化学习,提升模型在复杂代码库开发、完整项目构建等任务中的端到端工程能力。围绕数据合成、环境构建与跨 Harness 混合训练,我们持续扩展这条训练链路。此外,我们也将真实 Agent 的失败轨迹转化为可复现、可验证的训练任务,针对模型能力短板持续补充训练数据。
与此同时,LongCat-2.5 具备原生视觉理解能力,可将视觉信号表示为多层级离散 token,使主干模型以统一的 token 形式处理视觉与文本输入,在 Visual Coding 上表现出色,并支持创意设计和 3D 等任务。
这些升级背后,是持续演进的基础设施:我们优化了国产算力上的长上下文训练与 W4A4 推理,并通过训推数值一致性和长上下文 rollout 优化,支撑大规模长程 RL 的高效运行。
指标看板
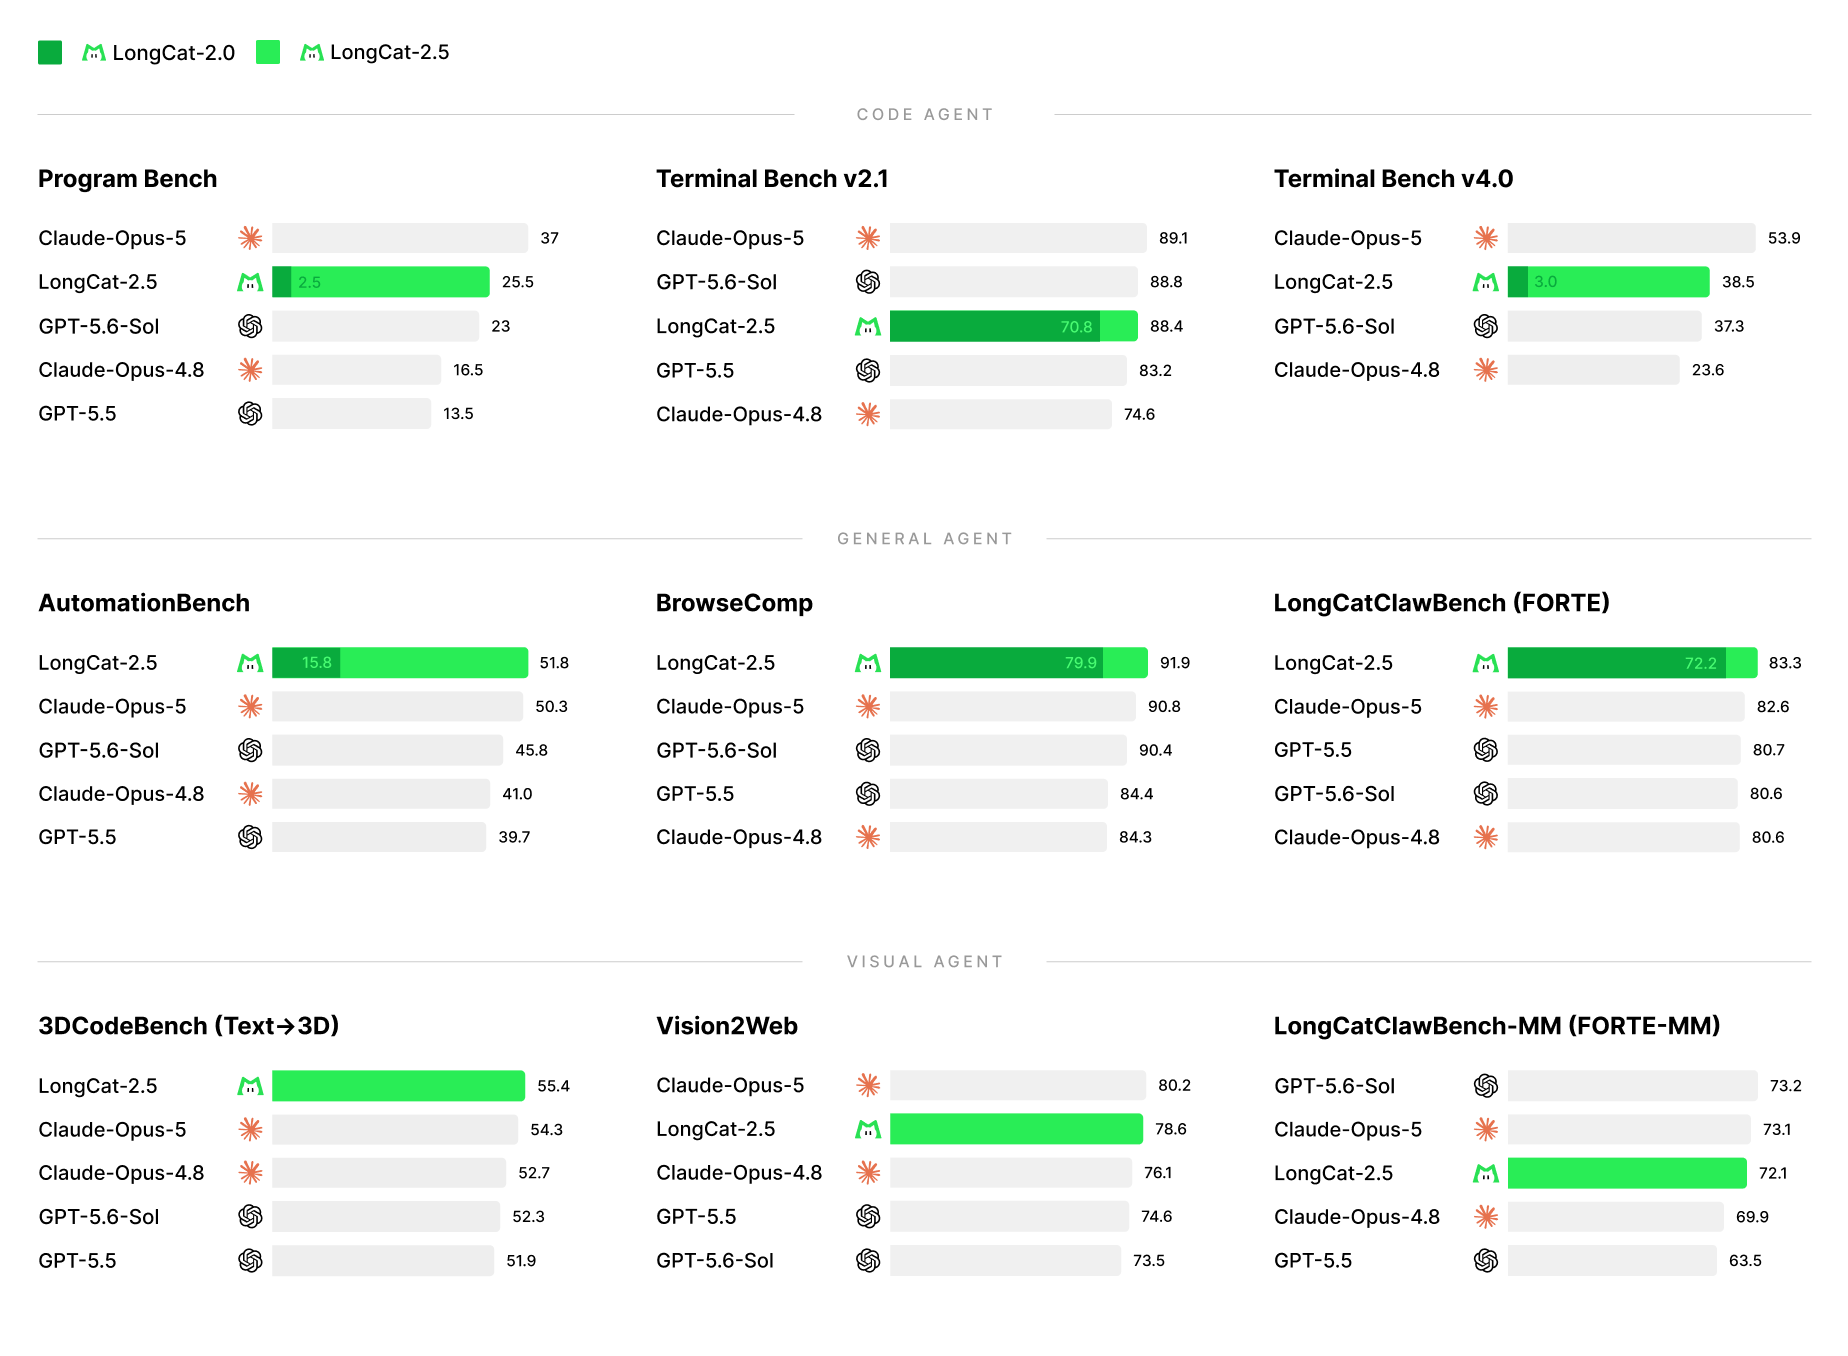
为直观呈现 LongCat-2.5 当前的能力水平,我们在下图中选取 GPT-5.5、GPT-5.6-Sol、Claude-Opus-4.8 和 Claude-Opus-5 进行对比。涵盖更多模型的详细评测结果见后文表格。
LongCat-2.5 将视觉信号表示为多层级离散 token,使主干模型以统一的 token 形式处理视觉与文本输入。这一设计融合了原生分辨率视觉离散化、离线视觉预处理,以及与主干模型联合学习的视觉 embedding,既能支持原生多模态融合,也简化了训练中的视觉计算与负载管理。
离散原生分辨率视觉 Transformer:为使视觉基元建模具备与语言建模类似的 token 级抽象,我们将视觉信号表示为多层级词表 token。沿用 LongCat-Next[1]的方法,对语义对齐编码器(Semantic-and-Aligned Encoder,SAE)产生的原生分辨率特征应用残差向量量化(Residual Vector Quantization,RVQ),解决视觉离散化的信息瓶颈。
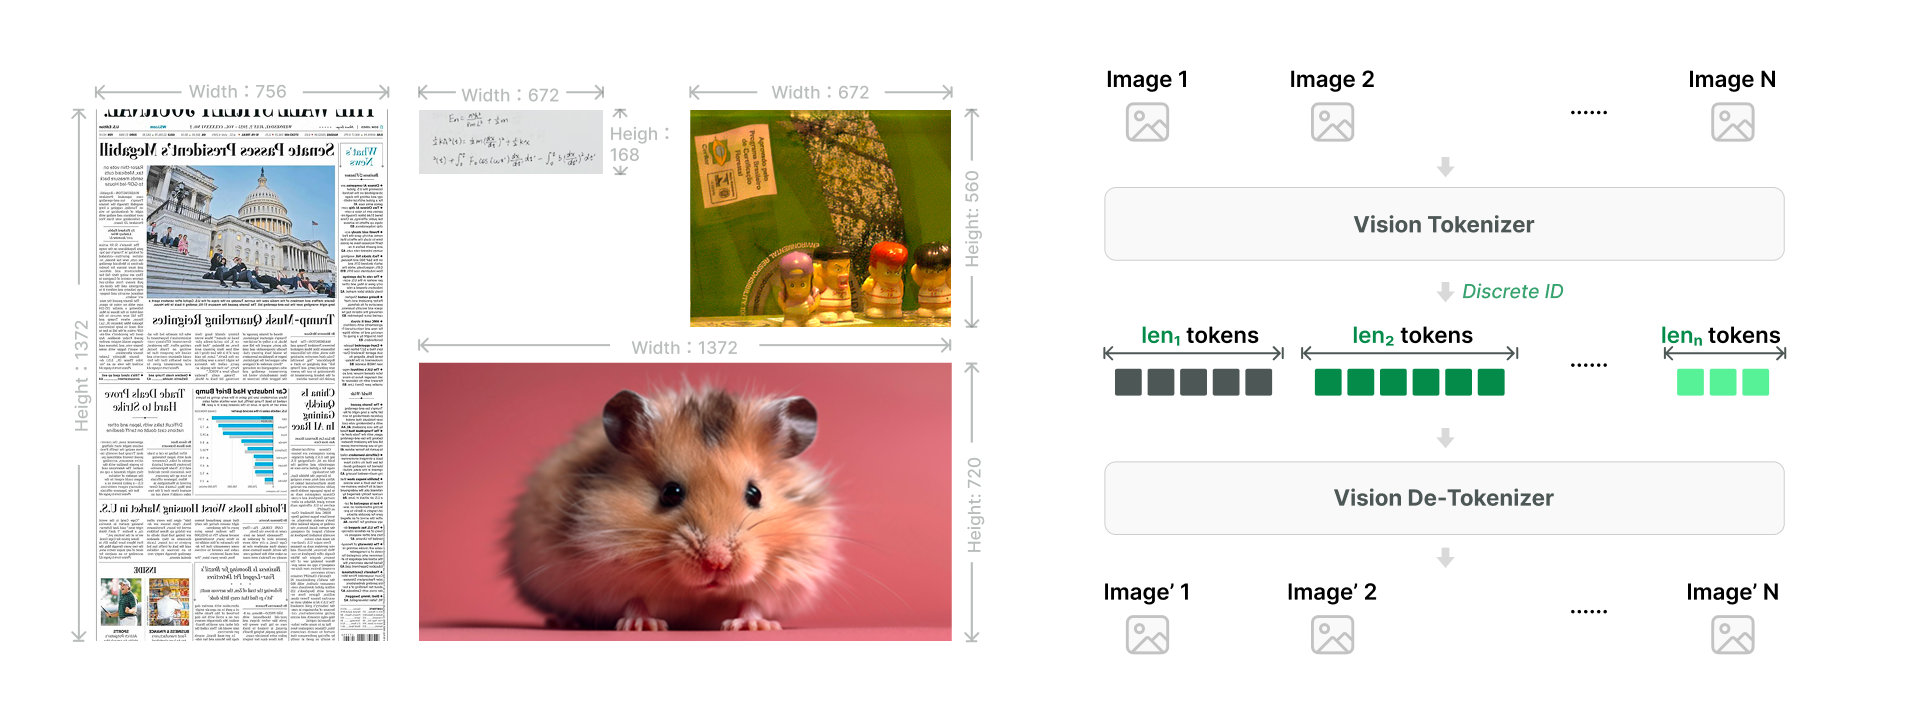
离线视觉 token 预处理:为减少在线视觉计算和工作负载异构性,固定的 tokenizer 允许我们离线预计算并缓存视觉 token ID。主干模型因此直接处理预先分词的序列,简化长序列打包与切分,并改善分布式训练的负载均衡。
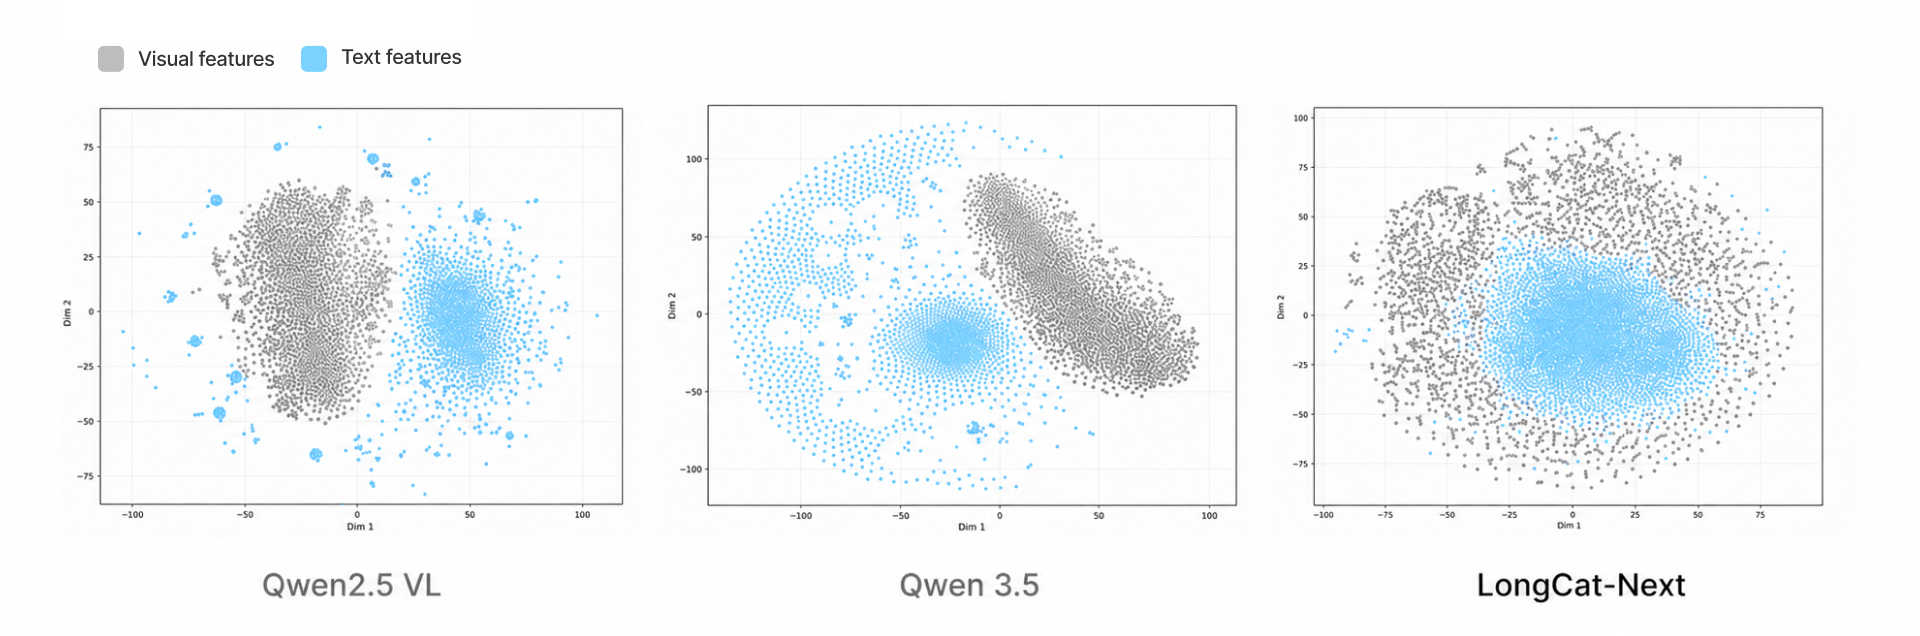
原生视觉表示:视觉码本 embedding 与主干模型联合学习。在平均激活参数约为 3B 的较小规模 MoE 模型上,初步验证显示,视觉与文本 embedding 在 t-SNE 可视化中呈交织分布,表明两者在共享语义空间中的融合。
RL scaling 是提升模型智能的关键步骤。我们为 LongCat-2.5 搭建了全面的 Agentic RL 训练链路,从数据、环境、算法和 Harness 等方面对长程任务进行大规模扩展。
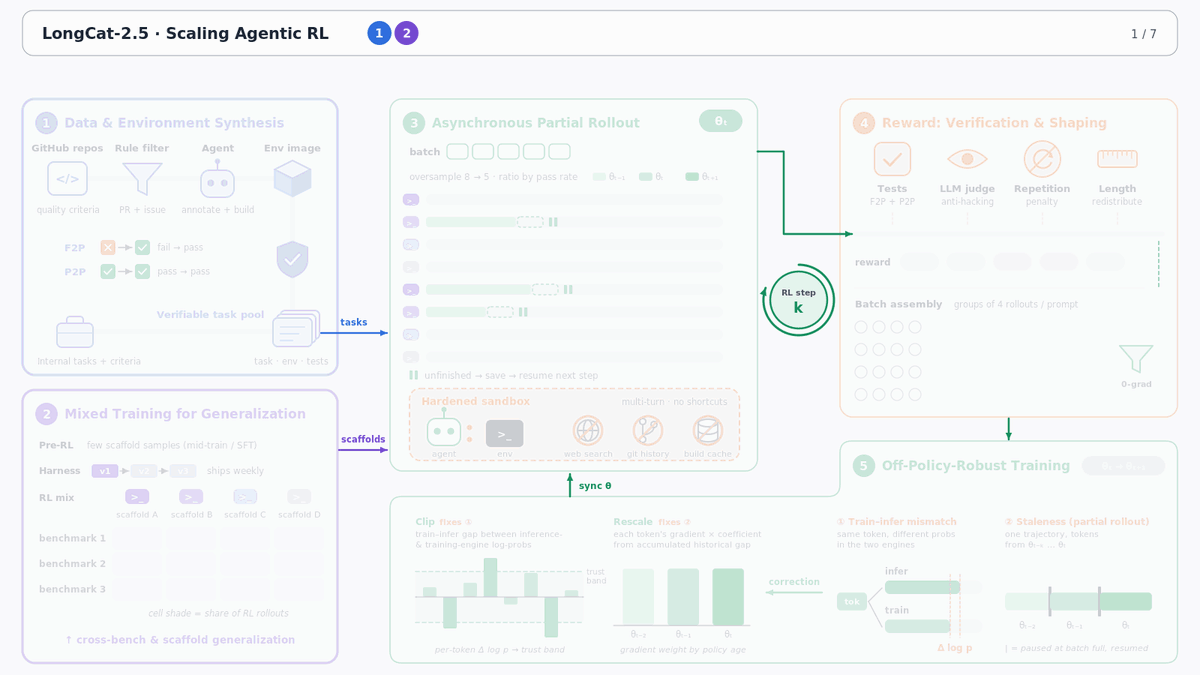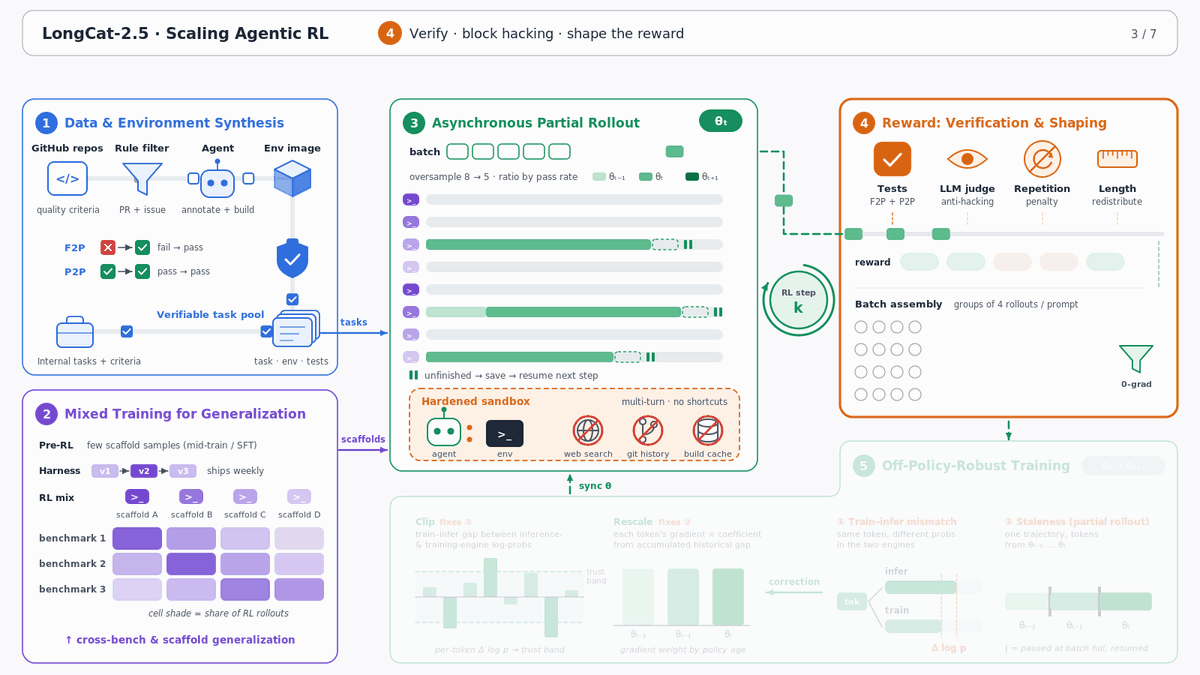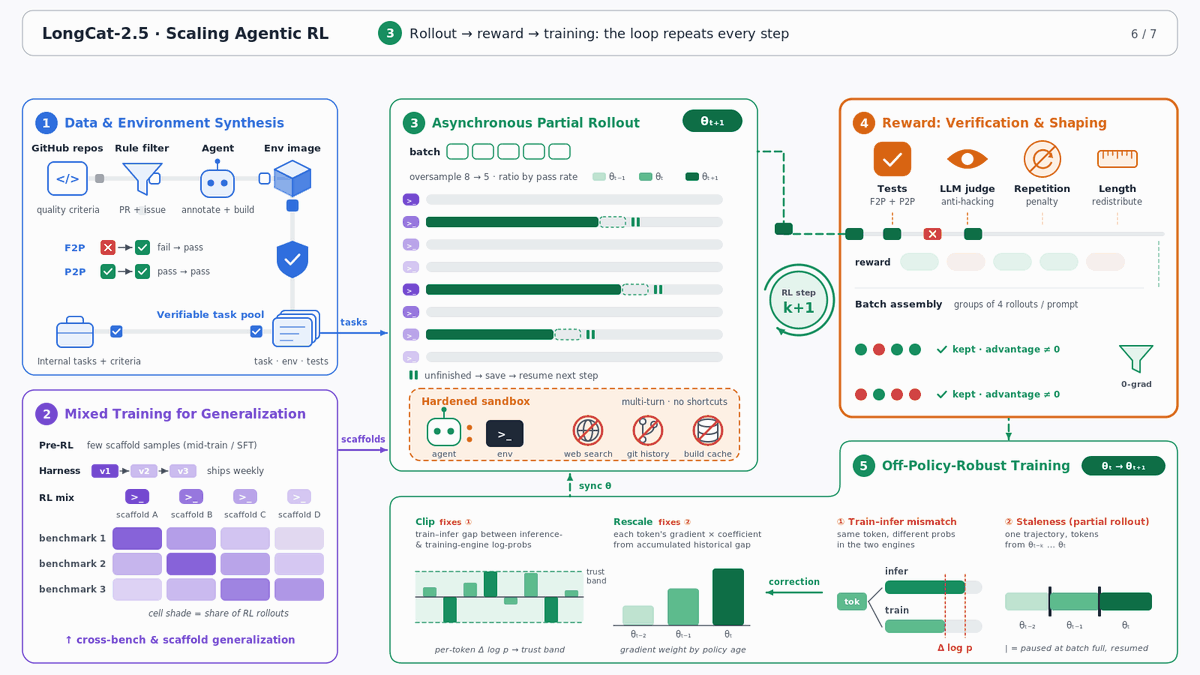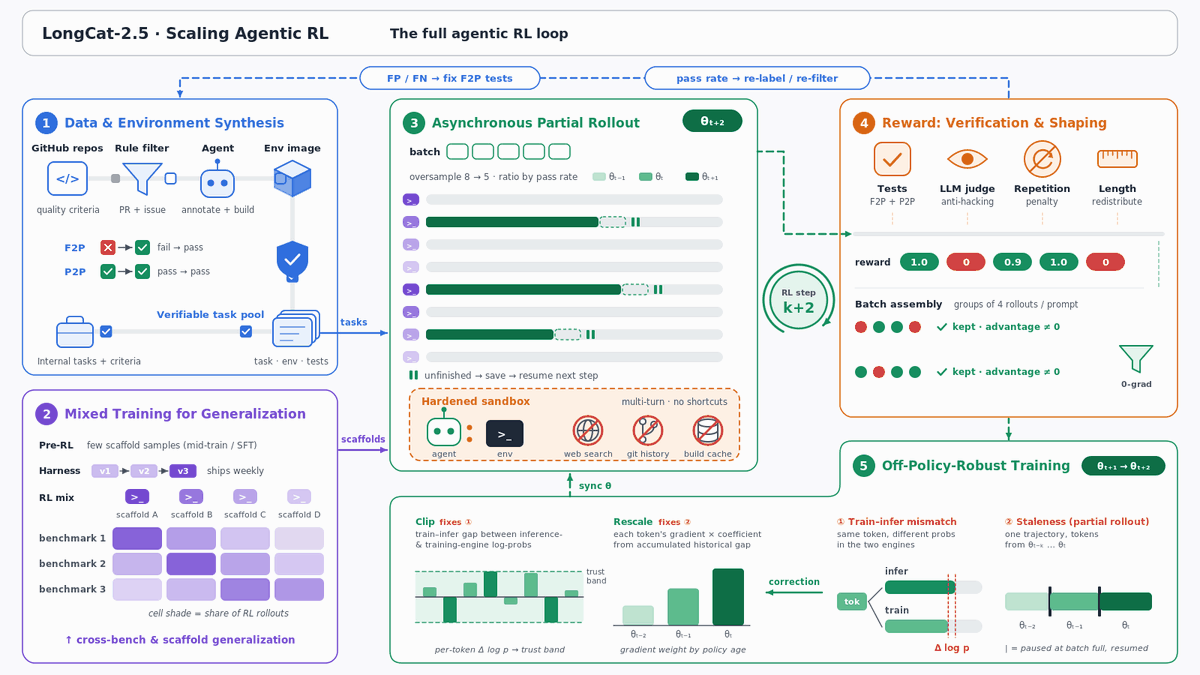
大规模数据合成与环境构建:我们构建可扩展的数据合成流水线,自动化生成训练任务、可交互环境和可验证的测试用例,数据来源涵盖 GitHub 公开仓库和内部真实场景的代码任务。对于筛选后的 PR 和关联 issue,利用 Agent 自动打标、合成环境,并进行 fail-to-pass(F2P)和 pass-to-pass(P2P)测试校验。在 RL 训练中,实时 rollout 的轨迹和通过率辅助我们进行二次数据打标和筛选,并基于假阴、假阳分析持续修正和扩充 F2P 测试用例,提高对任务功能描述的覆盖率,和验证信号的准确性。
异步强化学习与稳定性优化:我们采用 partial rollout 异步训练策略缓解长尾效率问题:每个 RL step 保持一定过采样率,凑齐批次后中断、保存未完成轨迹,并在下一采样阶段恢复。过采样率基于任务通过率调整,并过滤全对或全错的零梯度样本组,以保证有效梯度。Partial rollout 中,同一轨迹的 token 可能来自不同历史 checkpoint,带来样本陈旧性。为保证训练稳定性,我们裁剪采样时与当前训练时 logprob 的差异,并基于历史累计差异调整每个 token 的梯度贡献,限制陈旧性带来的梯度偏置;此外,从 infra 视角提供了训推一致性的优化方案。
Reward hacking 与输出行为优化:我们通过在任务环境中断网、清除 git 历史和文件缓存,并引入 LLM judge 监督轨迹,以限制模型的投机行为。在输出行为优化上,我们对重复思考和重复工具调用施加额外惩罚;对过度思考和长度增长过快的问题,则通过重新分配正样本中的 Reward 加以抑制。
混合训练与泛化:模型在 RL 中可自主学习和适配近似任务和 Harness。前置冷启阶段仅需覆盖少量适配 scaffold 用例,在 RL 阶段,通过跨多任务和跨 scaffold 的混合训练可显著提高模型泛化能力,并促进不同任务上的性能提升。
为将各领域能力融入主线模型,我们沿用 LongCat-2.0 的专家组机制,分别优化 Agent 能力、推理能力和交互体验,涵盖多轮任务执行、单轮推理、细粒度指令遵循,以及不牺牲有用性的安全防御。在 MOPD 中,学生模型在各领域任务中在线采样,领域专家通过采样结果上的全词表 KL 散度[2]训练学生。
样本既要反映学生的实际任务行为,也要让教师给出可信的学习信号。为限制分布偏移,先前工作将教师在 SFT 或 RL 阶段见过的轨迹拆为 per-turn prefix,作为学生采样的上下文。我们进一步将每轮教师回复按固定长度拆为 per-cut prefix,并将学生自采样的最大长度限制为该值,以处理单轮长回复中的分布偏移。
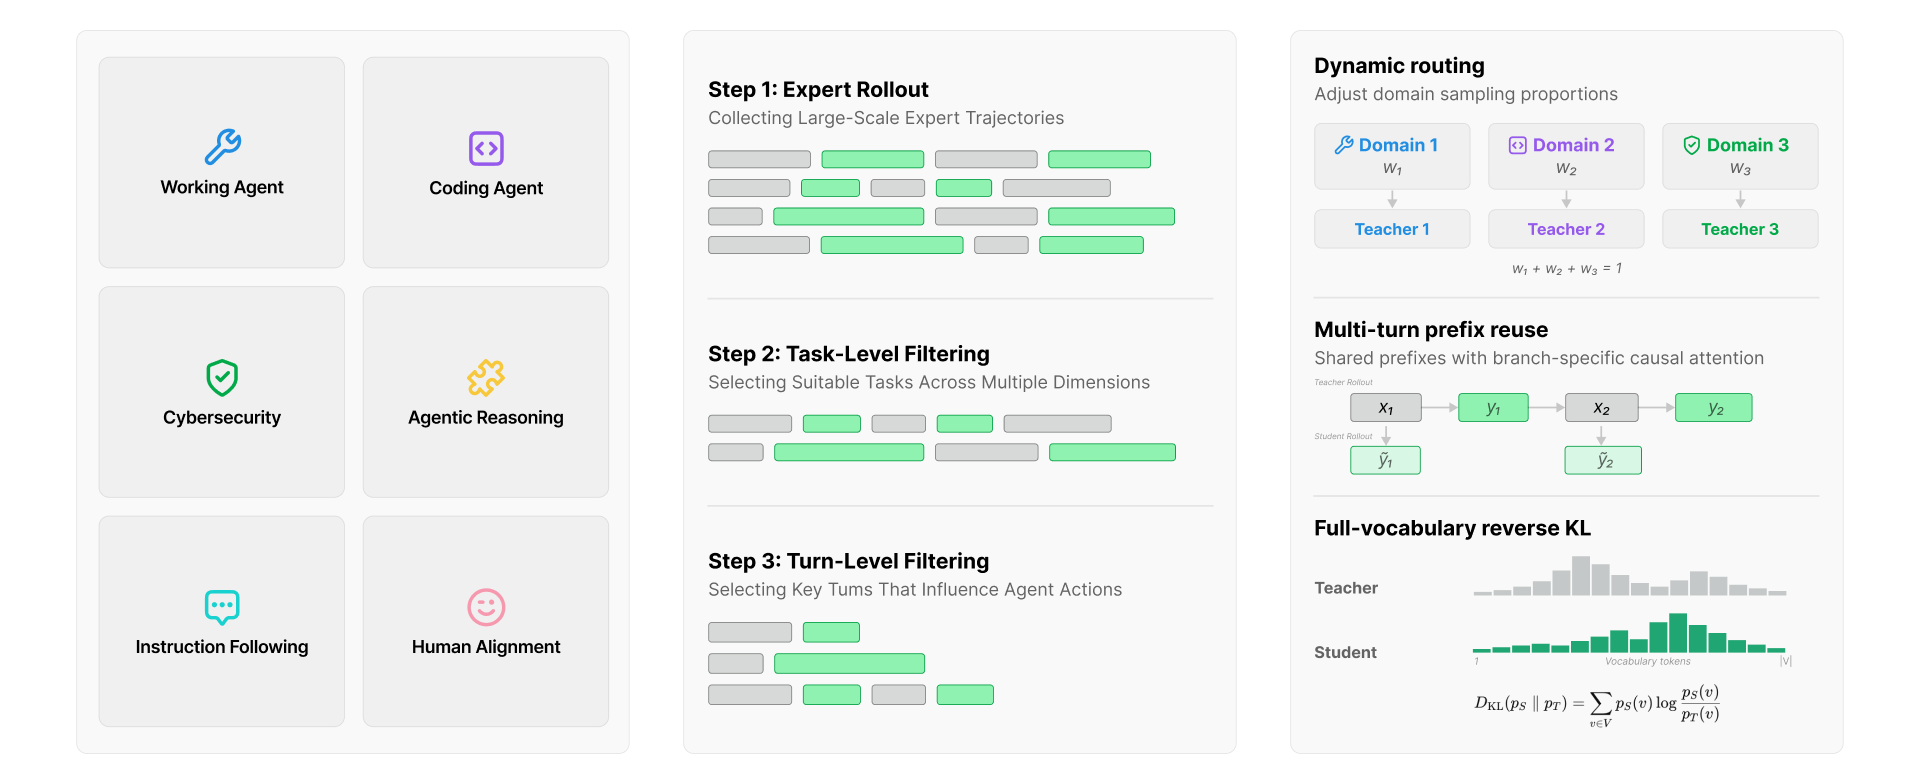
为控制计算与存储成本,同一教师轨迹的 prefix 被分为一组,送至同一推理引擎,共享 prefill 计算与 KV cache。训练时,以教师轨迹为树干、学生采样为分支构建树,结合 Tree Attention[3],通过单次前传与反传完成同组所有样本的 OPD 训练,避免教师轨迹上的冗余计算与存储。
LongCat-2.5 在中训练和监督微调阶段均采用长序列训练。针对国产算力单卡显存不足 80 GB 的限制,训练系统重点优化显存开销,并围绕超节点架构设计并行策略。
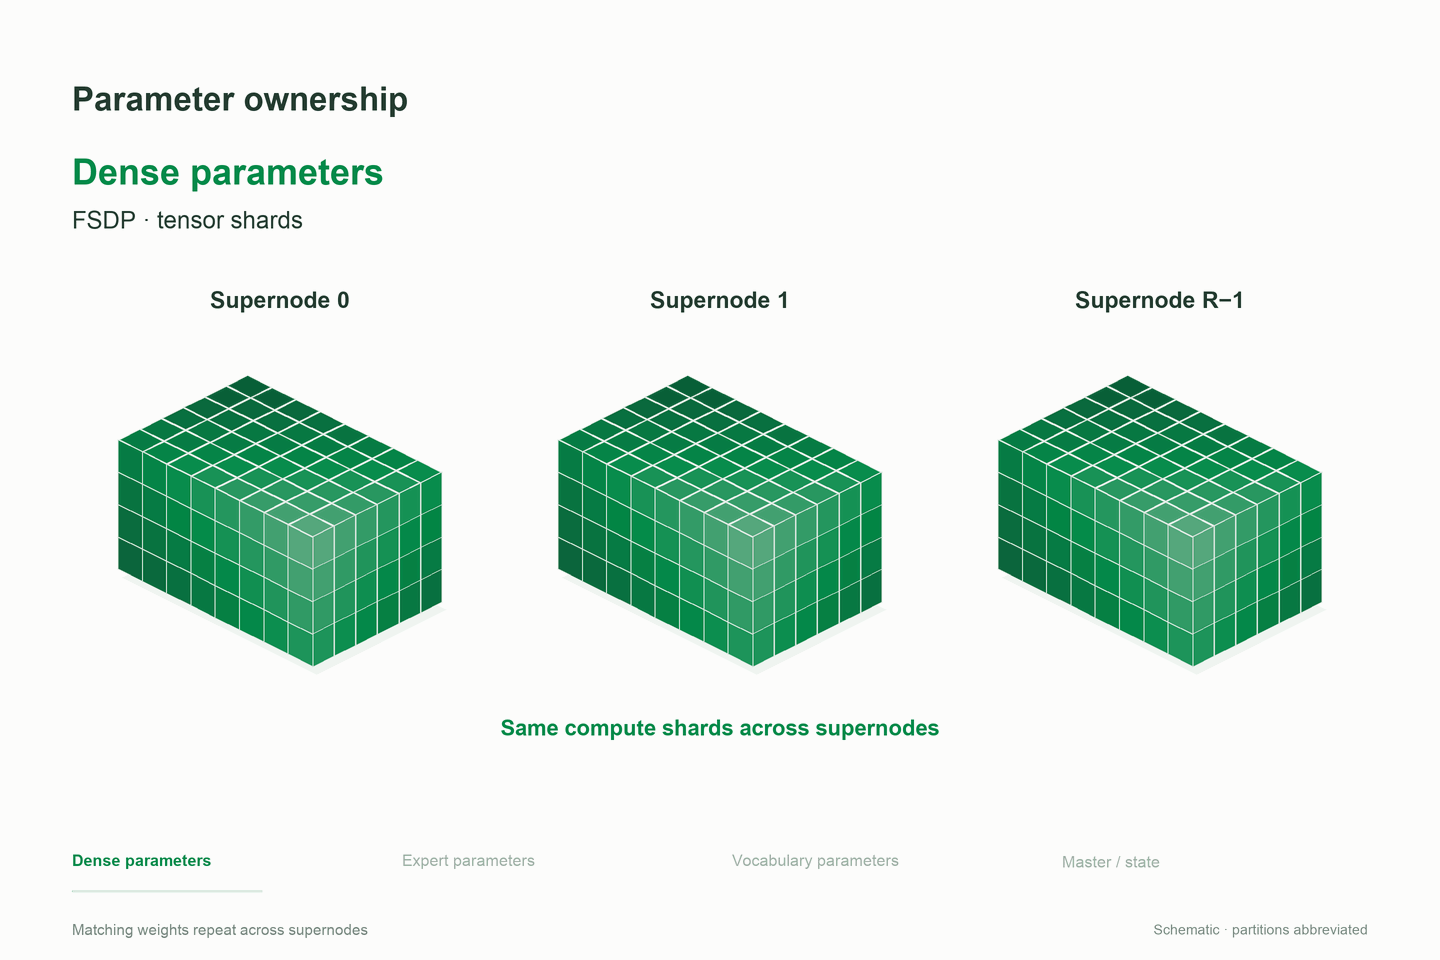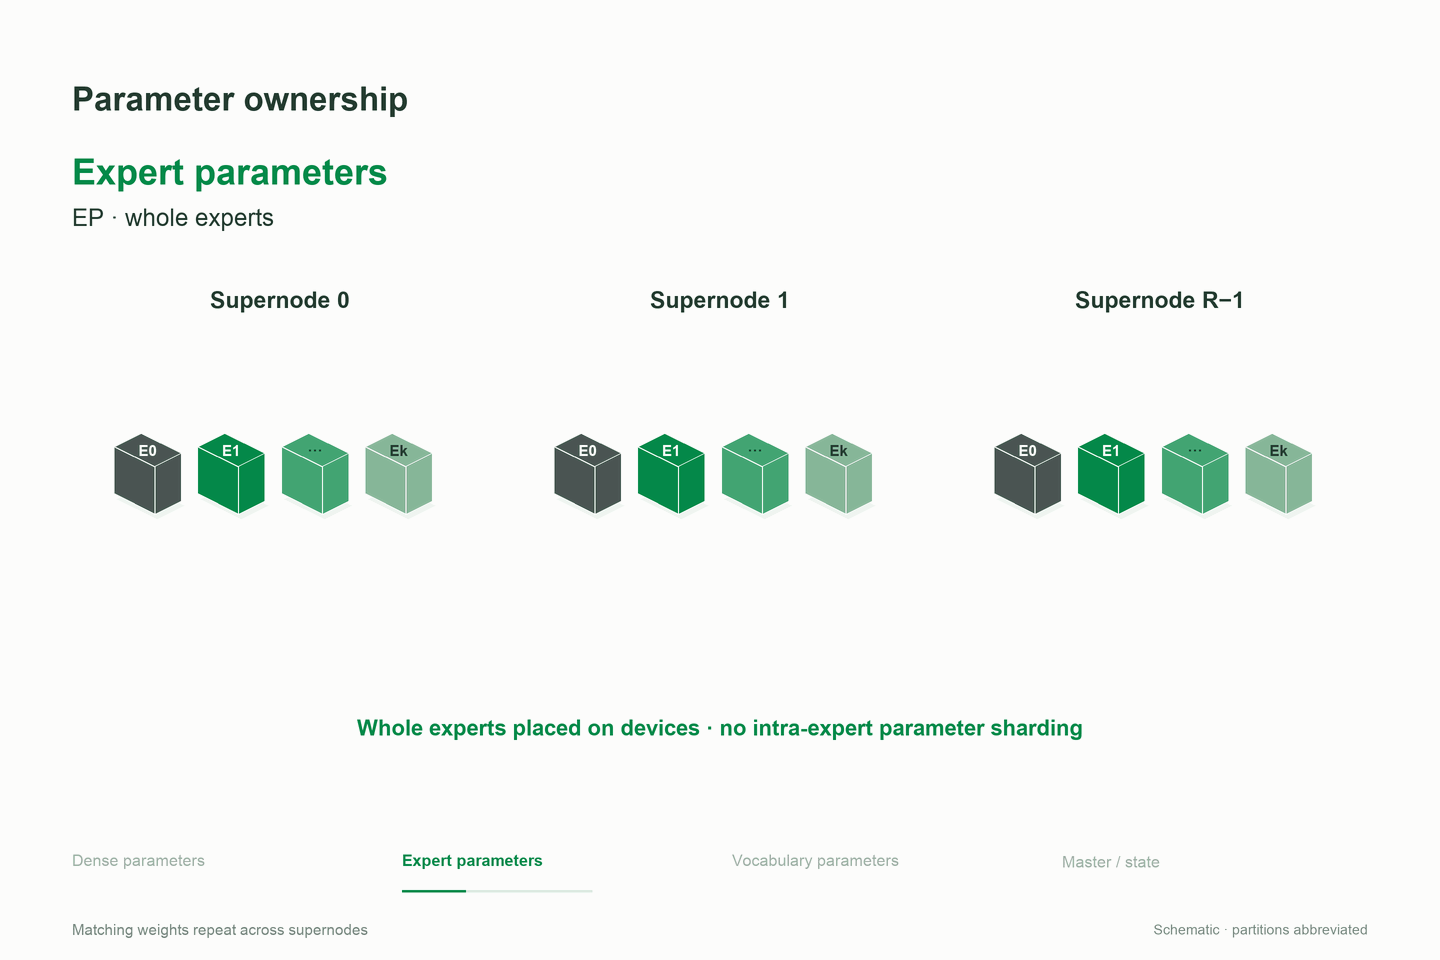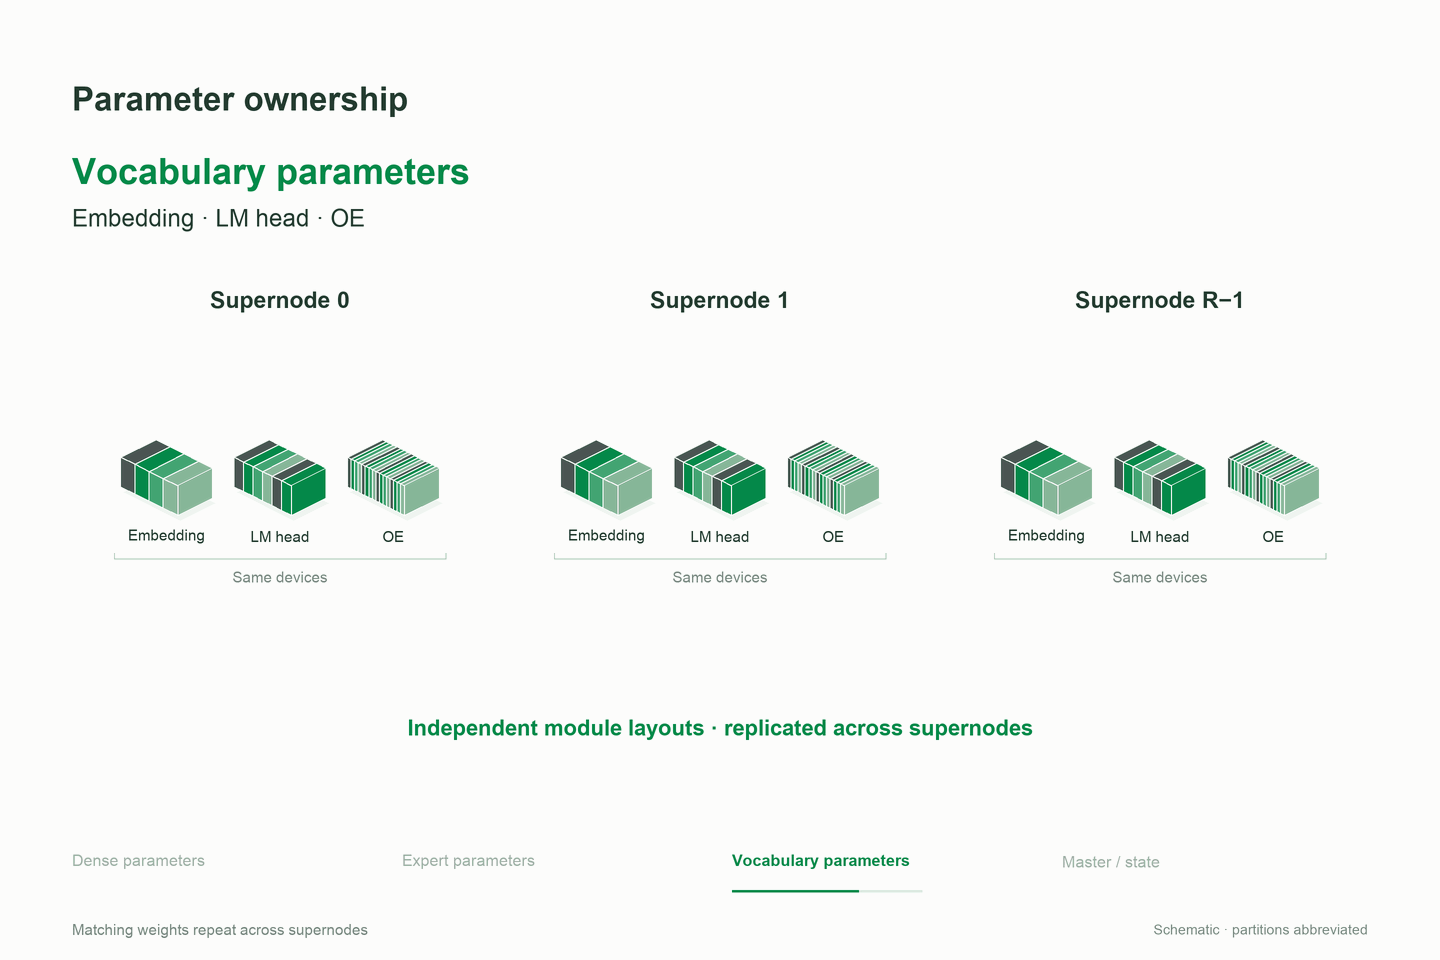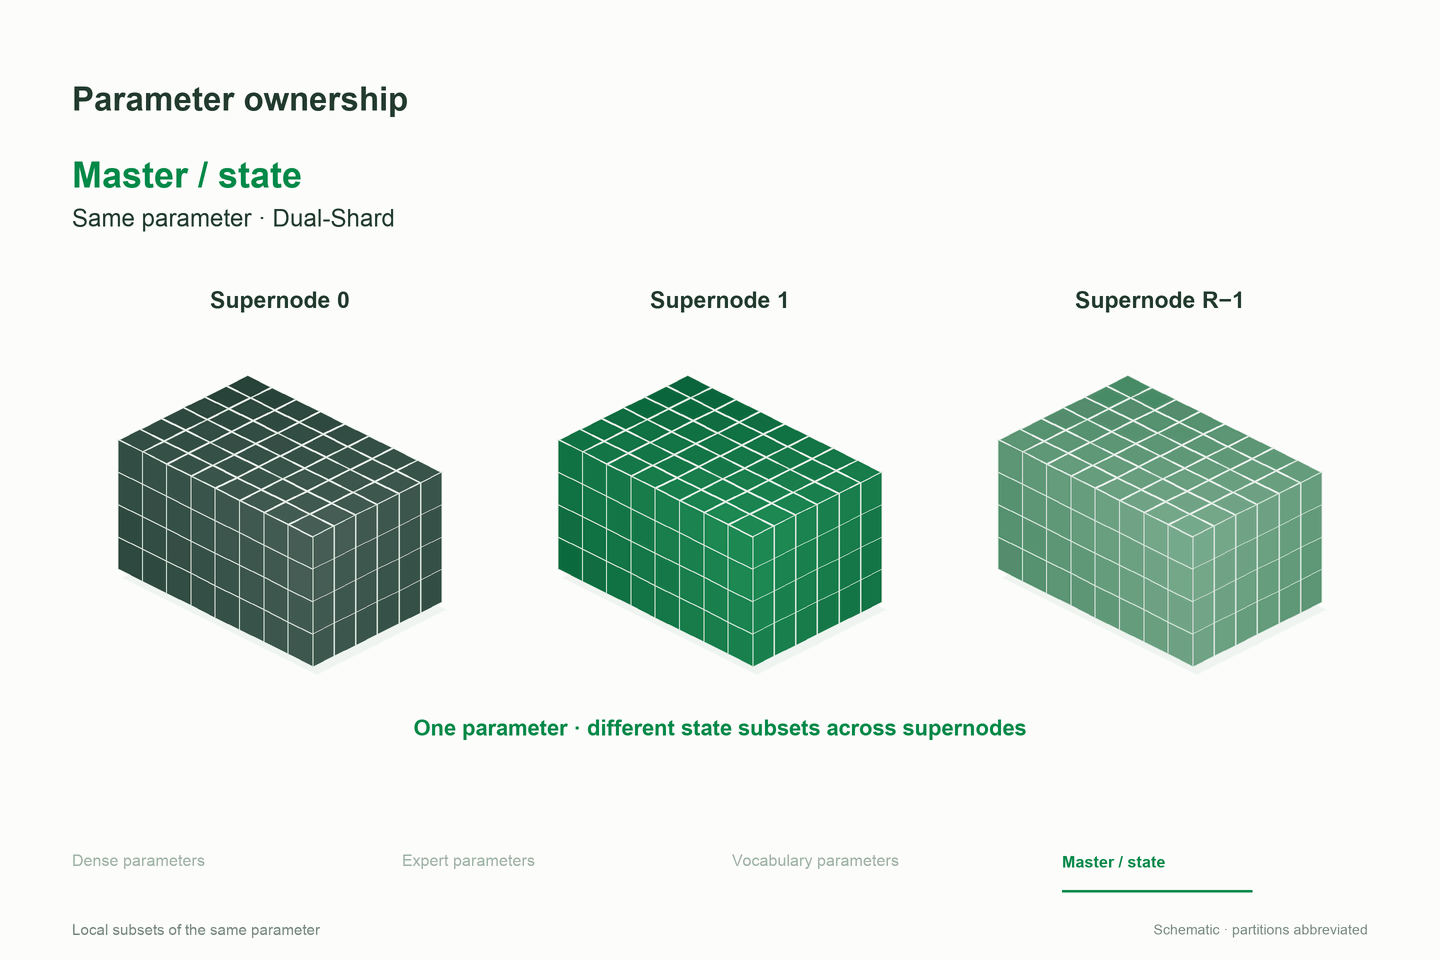
LongCat-2.5 根据超节点拓扑配置并行组,FSDP 和 EP 并行度均与单个超节点的卡数一致,CP 并行度不超过该卡数,使参数 AllGather、专家 token AllToAll 和 KV AllGather 均在超节点内的高带宽互联域中完成。
混合词表并行在 DP 和 CP 联合并行域内对基础词嵌入层、LM head 和 N-gram 嵌入层进行分片,进一步降低显存占用。
针对大规模专家并行中的负载不均衡问题,LongCat-2.5 基于 MoonEP 引入阈值触发的动态专家复制机制。仅当 EP 负载不均衡程度达到预设阈值时才启用复制,以避免额外通信开销超过负载均衡收益,并防止路由 token 引发接收端显存溢出、通信操作引发发送端显存溢出。
提前图像 token 生成使训练计算图不再包含视觉编码器,简化了并行实现。利用已知的图像 token 数量,系统可以在数据打包和打散时预估各模态的负载比例,使各数据并行 rank 上的模态占比接近。
LongCat-2.5 引入双重分片 FSDP,模型参数在超节点内的 FSDP 域中分片,FP32 主权重和优化器状态则通过 HSDP 副本进一步跨 FSDP 域分片,在保持参数通信效率的同时,降低常驻显存。
参数、梯度和优化器状态统一组织为连续的扁平化缓冲区,支持非均匀分片和 Muon 优化器分片。同时,通过直接写入权重梯度、复用临时缓冲区,减少中间拷贝,降低峰值显存占用。
系统采用零拷贝 AllGather/ReduceScatter,消除默认通信算法引入的中间拷贝。EP 将 token 与路由概率打包传输,并采用基于 AIV 的通信实现,缓解 AICPU 任务展开瓶颈。参数预取使 AllGather 与计算重叠执行,同时控制与 CP 的资源竞争;ScMoE 则使 EP 通信与稠密分支计算重叠执行。
系统通过批量执行梯度操作、合并指标归约、CPU 绑核和 NUMA 感知调度,降低主机侧开销。
综合上述优化,该 FSDP 配置在长序列 SFT 任务中的单卡吞吐量较 DDP 基线提升 86%。
基于 IsoExec[4]、GLM-5[5] 和 XoRL[6]的工作,我们构建了生产级训推一致性方案,使训练、Prefill 和 Decode 可独立选择并行配置,在性能接近无损的同时,保持逐 token logprob 的 bitwise 一致。训推两端统一采用高效的 batch-invariant 算子并对齐框架计算逻辑,补齐 backward 支持。该方案已在实验和生产任务中默认启用,为算子与框架迭代提供统一的数值回归基准。针对因为不同并行方式导致的训推无法对齐的问题,我们在社区的方案上进一步扩展 TP 和 DCP 的训推一致性支持。
TP:以完整 K 维计算替代分段求和,性能接近无损。训练侧保留权重分片,通过权重 All-Gather 和输入 AlltoAll,独立完成完整 K 维 GEMM,无需对局部结果进行 Reduce-Scatter 求和。Prefill 沿用该方案;Decode 则将 o_proj/fc2 改为 column-parallel,通过输入 All-Gather、完整 K 维 GEMM 和输出 AlltoAll 完成计算,既避免每步聚合完整权重,也避免跨卡数值求和。
DCP:在训练与 Prefill 中复现 Decode 的累加路径。我们在训练 forward 和推理 Prefill 中接入配套的 sparse attention 算子,复现指定 DCP 配置下 Decode 的 KV 分块与归约顺序,对齐了三者的计算精度。
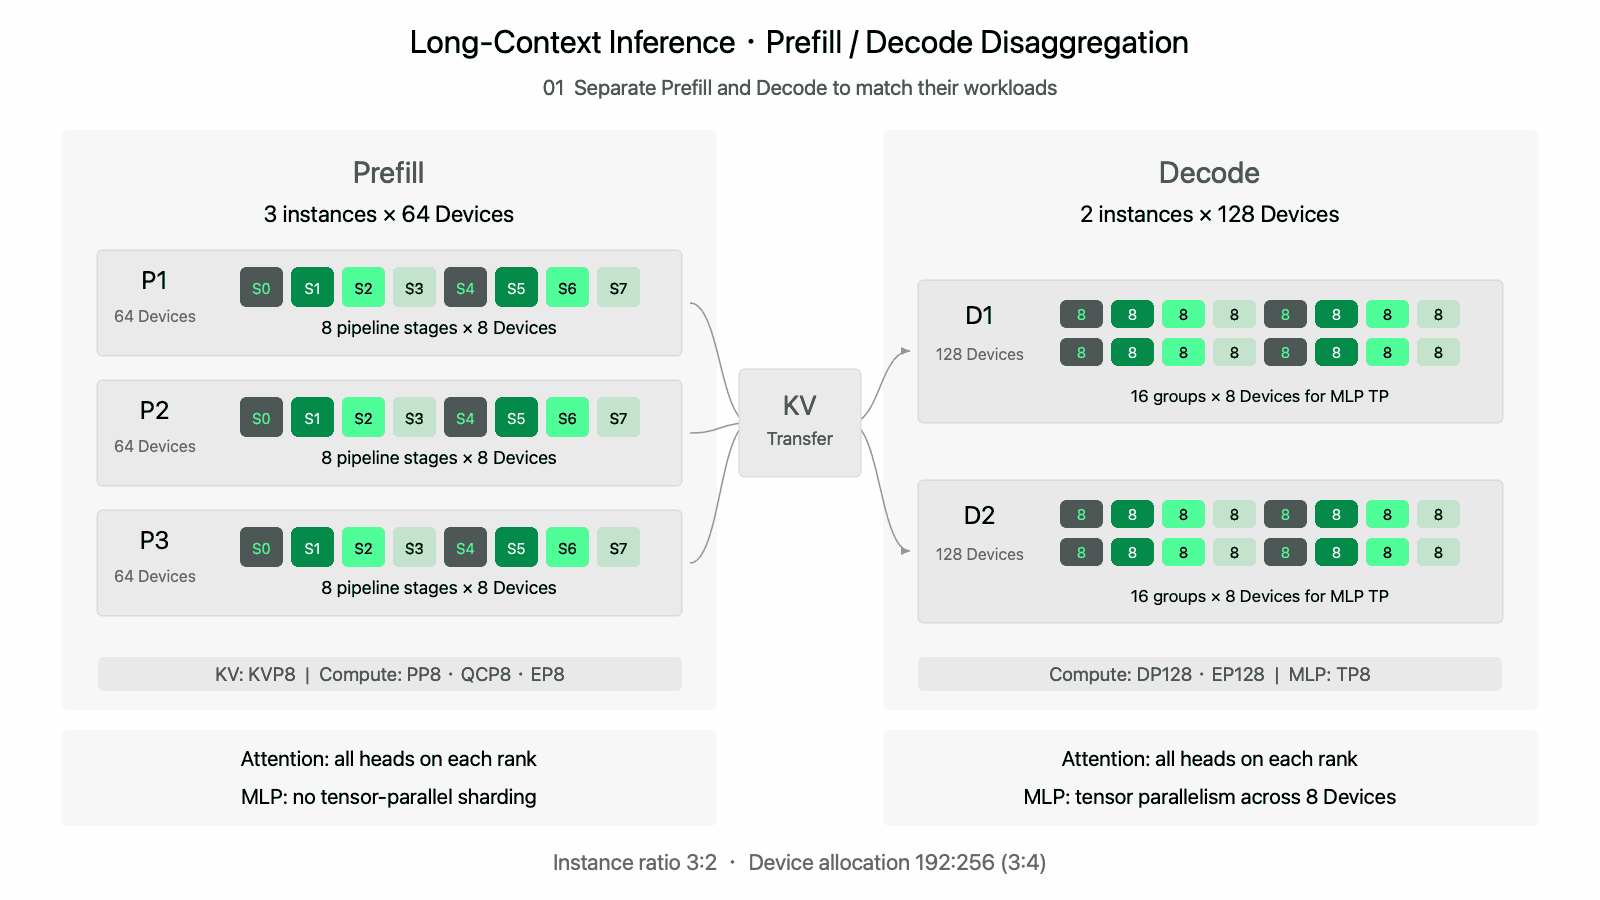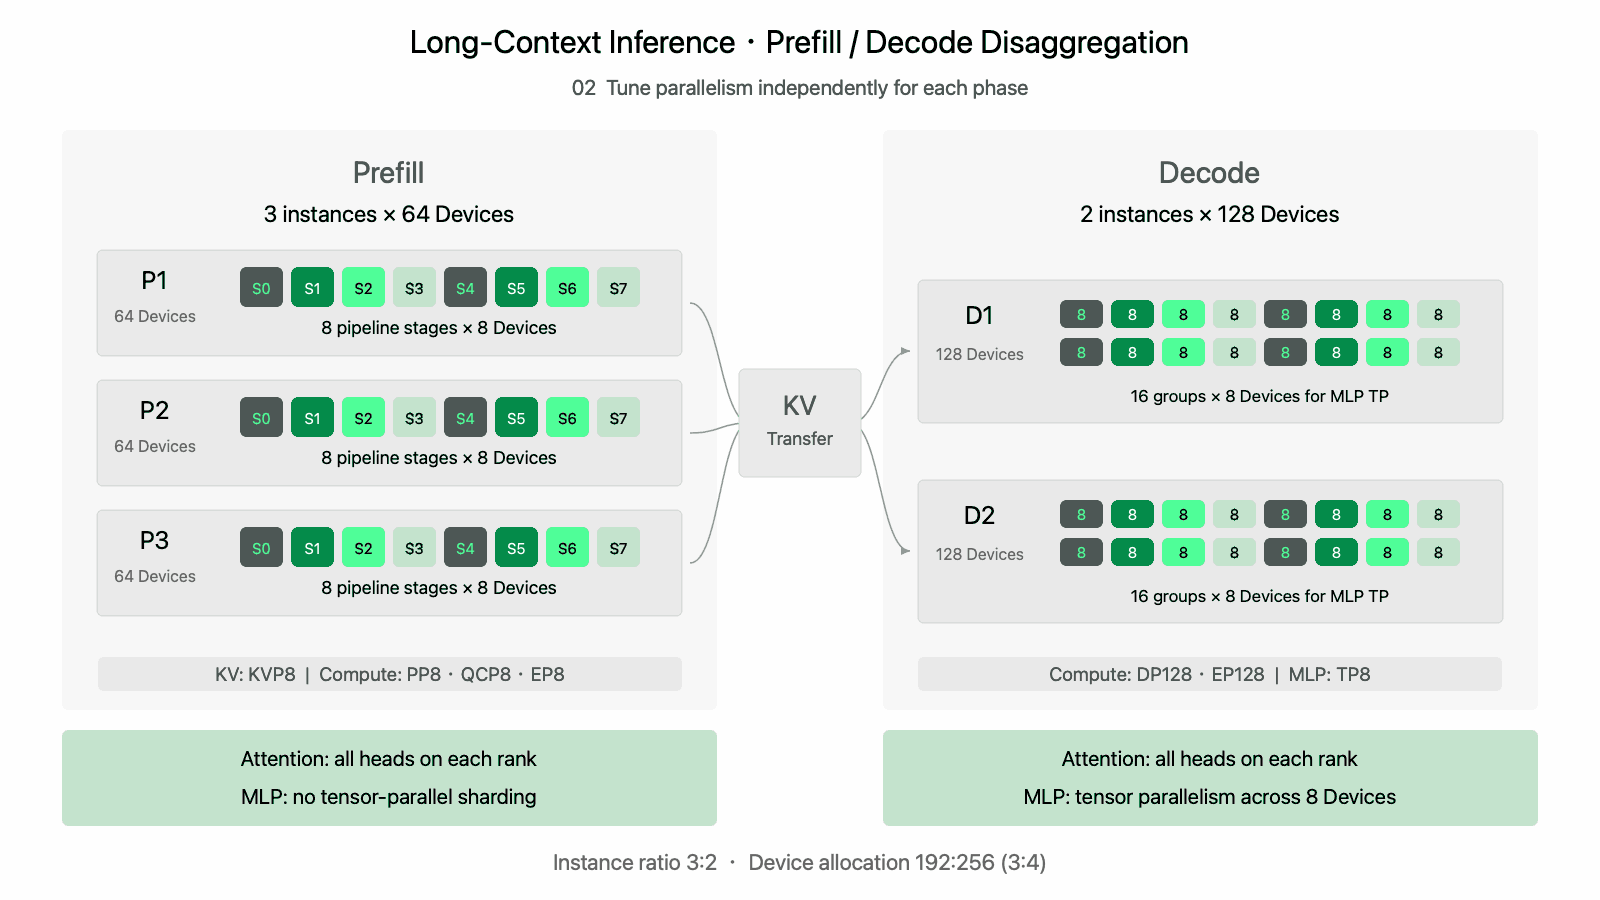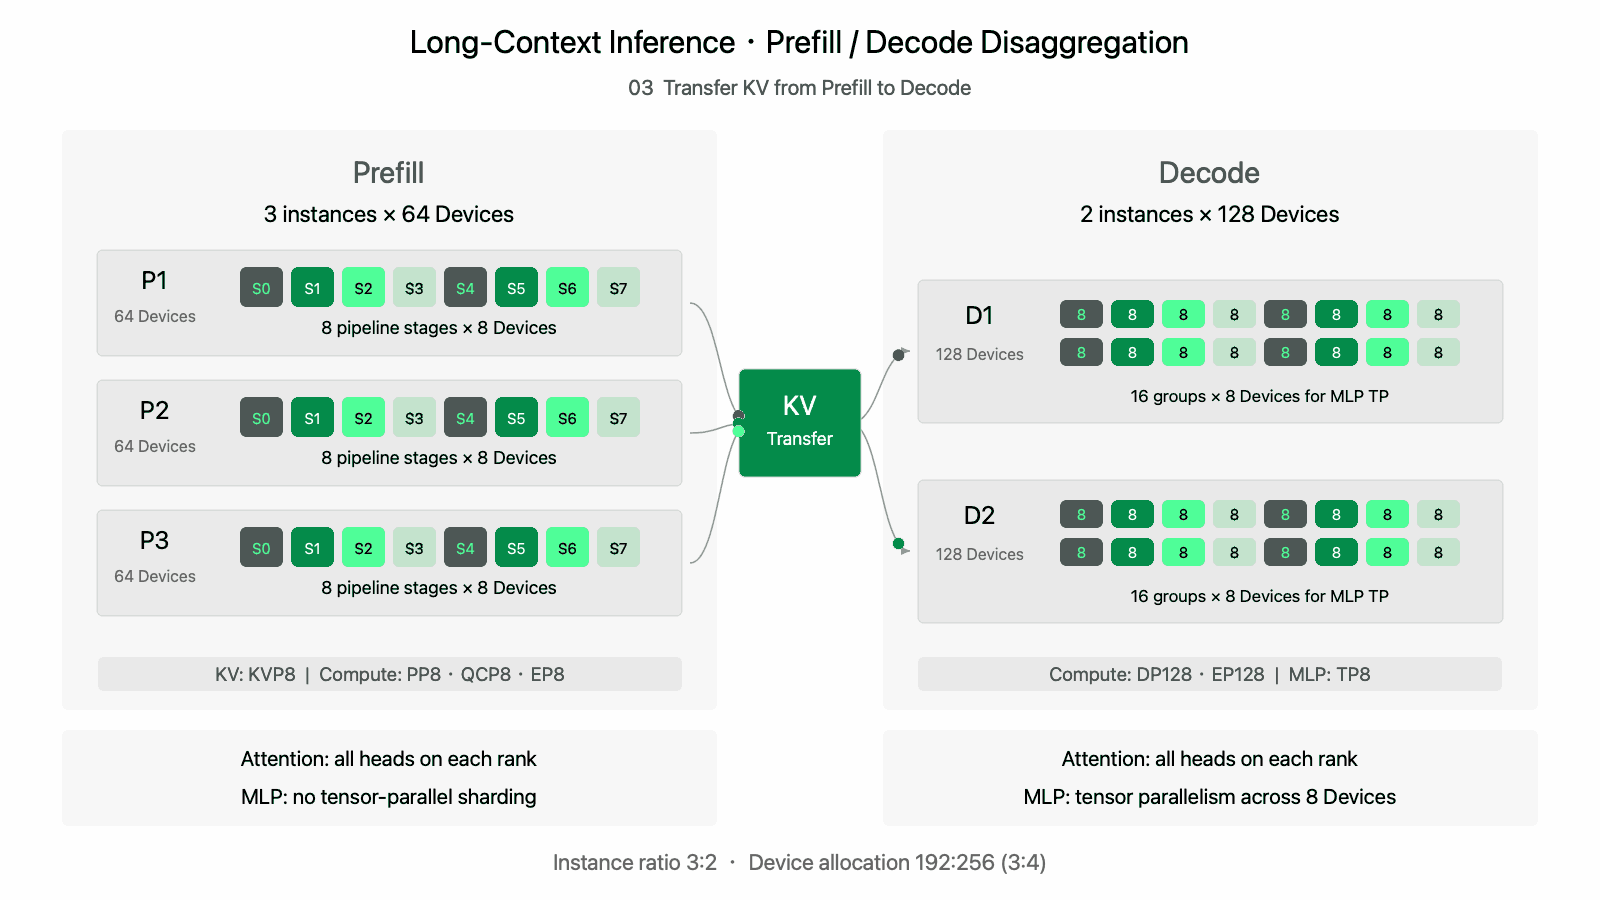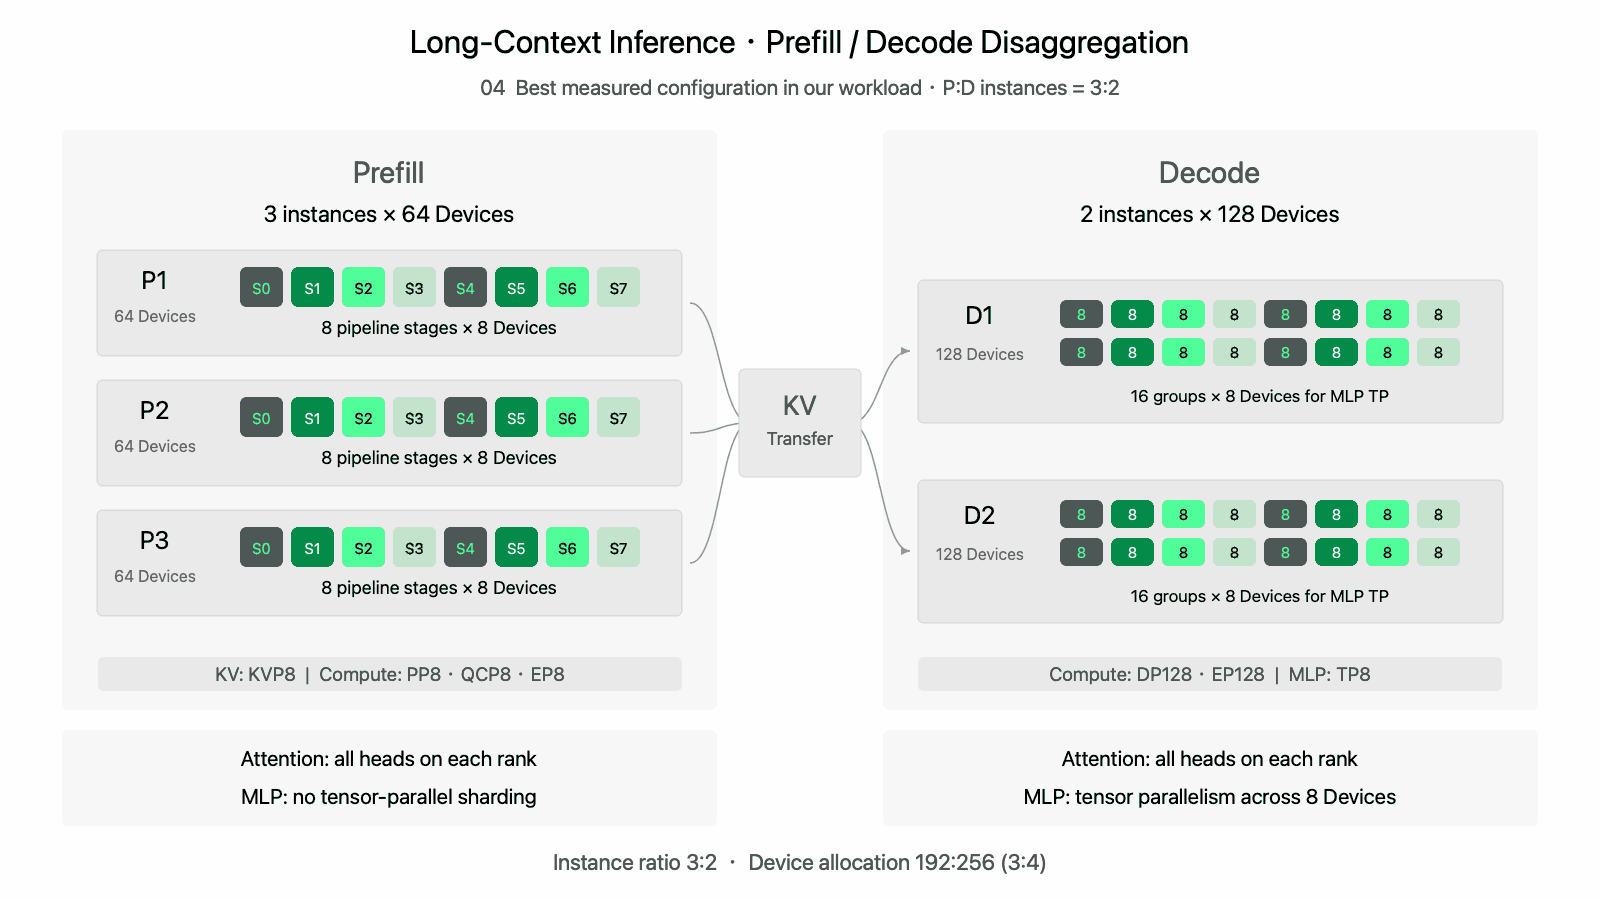
针对负载可控的长上下文多轮 rollout,我们采用 PD 分离,为 Prefill 和 Decode 分别选择合适的并行策略,并从缓存存储、跨层卸载和请求调度三个方面协同优化:
针对 1.6T 级 MoE 模型,我们结合模型结构与国产 AI 加速器的硬件特性,围绕量化精度、底层算子与推理流水开展协同优化,构建 W4A4 高效推理方案。
该方案将专家权重与激活同时量化至 4 bit,并通过原生 INT4 矩阵乘法单元执行相应的矩阵计算。
在精度方面,以 FlatQuant 的可学习等价变换为基础,进一步优化 MoE 模型的量化精度,在已评测的各项下游任务上保持与量化前模型相当的表现。
在算子与数据路径方面,通过专家共享的输入变换,在 token 复制与分发前完成量化,使同一份 INT4 表示贯穿专家通信与计算。将变换、尺度计算、量化和打包融合到专用算子,并结合权重布局与转置访问优化,减少数据搬运和转换开销。
在系统层面,针对 prefill 与 decode 的执行特点,依据模型的数据依赖和硬件资源约束,优化计算与通信的流水重叠。

在线上压测中,相对 W8A8 INT8 基线,prefill 和 decode 吞吐分别提升 43.3% 和 42.77%,TTFT 和 TPOT 分别降低 15.91% 和 19.72%。在算子层面,GMM 相对 W8A8 实现平均 1.73× 加速。

详情参见官网技术博客:https://longcat.ai/blog/longcat-2.5。
AI 能让代码写得更快,但在「不能出错」的分布式存储系统里,如何确保提效不变成风险?本文结合美团基础技术部在 AI 评审、问题排查和自动化开发中的真实实践,分享 AI 能帮上什么忙、容易在哪些地方犯错,以及哪些地方仍需要人来把关。比「多写代码」更重要的,是让代码和结论经得起验证。希望这些经验能为复杂系统中的 AI 应用提供参考,在享受效率提升的同时,守住质量与稳定性的底线。
今年年初以来,随着Agent的普及,AI Coding 在功能开发、测试生成、脚本编写和执行、问题排查这些场景里都已经用得上了:读代码更快,实现和测试可以先让它写一版,研发之外的一部分杂活也能交给它去跑。
效率上去了,质量上的账也要重新算。同样的人力,一个版本里能交付的功能更多,改动的代码也更多,就算 AI 写的代码千行缺陷率和人写的持平,一个版本累计引入的缺陷绝对数量照样会涨。所以 AI Coding 的目标不能只是更快地写代码,提速的同时,代码质量和验证充分性还得比常规研发要求得更高。
分布式存储把这个问题放大了。代码规模大,模块之间关系复杂,一致性、并发、持久化、故障恢复和性能每一项都碰得到。一处看上去很局部的改动,平时可能一切正常,等到节点重启、磁盘异常、网络抖动或者高并发的时候才暴露出来。出了问题,受影响的也不会只是某一个功能,而是上层业务的数据可用性和系统稳定性,严重时还会波及数据正确性。存储服务支撑着大量上层业务,故障影响面大,修复也困难,对缺陷的容忍度极低。
要满足这样的质量要求,光让 AI 生成代码不够,AI 评审(Code Review)、AI 测试与验证、AI Debug 和受控自动化也得一起建起来,AI 生成的代码才能放心地进入研发流程。本文结合存储团队在 AI 评审、AI Debug 和 AI 自动化上的实践,讨论在分布式存储这类复杂度高、容错低的系统里,怎样一边用 AI 提速,一边靠更严格的评审、测试、调试和自动化验证守住稳定性与数据正确性,希望对其他类似系统落地 AI Coding 也有参考价值。
1. 能注意到跨文件一致性
例:ENABLE_UNITTEST 在三处调用点控制测试 mock 变体的编译分支,但 CMake 迁移把这个名字换成了 WITH_UNITTEST,旧名字再也没被赋过值。单看任何一个文件都挑不出毛病,这个 bug 只存在于文件和文件之间的落差里。
2. 能构造可执行证据
例:AI 指出“这里没做边界检查”之后没有停下,接着构造了一个声明 1 GiB 数值、实际包体只有 5 字节的畸形包,打到真实的解码入口,把崩溃现场抓了出来。
3. 会承认自己证明不了的部分
例:一处疑似的并发竞态,AI 只能靠代码走读找到可疑路径。它明确说,要证实这段交错时序需要 ThreadSanitizer,而当前的工具链跑不了,于是把这条标成“未验证”,没有直接定性为缺陷。
4. AI 对一些常见竞态问题识别率高
例:一处“先读校验、再写推进”、中间没有互斥的更新,多次评审都稳定地识别了出来,给出的修复方向也一致(合并成单个原子操作)。这类常见的并发模式识别得很稳,可以固化成固定检查项。
5. AI 不会漏掉 PR 中被删掉的代码
例:一次重构把某个接口合并成单次 RPC,顺手删掉了成功后清理本地缓存的旧逻辑。AI 指出这会留下一个短暂的时间窗口,期间可能读到过期的旧数据。而人对被删掉的行,本来就最不敏感。
6. AI 会结合存量代码评审增量改动
例:评审之前,AI 会先分析存量代码。改动较大的 PR 里,新代码可能顺手修掉了一个原有问题,人工评审容易把这种顺带修复当成新问题反馈;AI 则会把“原本就有、这次已顺手修掉”的问题单独列出来,并声明不作为问题上报。
7. AI 评审不会局限于代码层面的变更
例:某个 PR 里,三个仓库的构建文件互相用 feature 分支名引用对方,没有固定版本,合入顺序不对或者分支被清理,主干构建就断了。这属于“合并编排”层面的问题,只看 PR 页面的人恰好最容易漏掉,而 AI 把构建文件也当成了评审对象。
AI 的误判多数是因为看不到代码之外的东西,比如运维流程、设计决策和团队约定。我们的实践中也看到了AI 评审在修复建议、信噪比、定级和证据取舍上的问题。
1. 代码可达 ≠ 运维可达
例:报告把一处过期 epoch 的代码路径标成了现实风险。人工复核时没有质疑这段代码本身,质疑的是周围的系统到底会不会产生走到这个分支的输入:"EPOCH_NOT_MATCH 只会在迁移分裂+1,分裂之后老的region就不存在了,迁移之后再迁移,src也不存在了,所以 EPOCH_NOT_MATCH 理论上走不到这个分支。"
同样的情况也出现在被报告标成竞态窗口的一天过期时间的问题上:“迁移是人工操作,线上不会存在迁移发起一天还没有成功的,需要人工介入,一天的过期时间就是解决这个问题的”。AI 能建模那个计时器,建模不了包在它外面的人工流程。
2. 把和一般实践不同的有意为之当成了缺陷
例:报告把在生产环境里直接调用 abort() 的一致性检查标成了正确性风险,建议改成记录 Error 日志,不要崩溃。实际我们选择了abort,因为存储系统是正确性高于可用性的,在特定场景下,我们宁可 abort,也不能让这个请求继续而产生非常难处理的脏数据。
3. AI 评审附带的修复建议,本身也需要评审
例:AI 针对一个 32 位溢出给出的修复,是校验声明的 size 和实际收到的字节数是否一致。复核时发现 get_size() 返回的是 int,size 落在 2³¹ 到 2³² 之间会被截断成负数,这条校验本身就会静默失效。个例修好了,同一类问题并没有修好。
4. 廉价的“请确认”条目挤占了真正的信号
例:AI 评审把线程池默认值、重命名的配置项、被移除的二级缓存刷新开关都标成了“待确认”。每一条最后得到的回复,依据的都是团队自己压测得出的历史数据,和代码缺陷无关:"根据压测调整的,后台线程数调低是为了降低对前台的影响。"
5. AI 评审的问题定级失真
AI 缺少一道界限明确的质量门槛:同一类理论上可能的问题,这次被标成最高级,下次又可能被标成不重要。拿到一份 AI 报告,定级没法完全信,为了保险只能把所有问题挨个审一遍,反而很难聚焦到真正高等级的问题上。
6. 把注释、头文件断言和设计文档当作证据
例:两份 AI 评审用的是同一个“场景 × 约束”框架,却给出了相反的结论。一份直接复述头文件里的断言判定实现是对的;另一份去核对了具体的实现,判定是错的。另一个例子是简单依赖设计文档,即迁移设计文档中要求的版本连续性校验,在代码里却没有任何引用。
两份评审看的代码没有区别,区别在于有没有去验证这些“说明”本身。
静态评审只能说明“代码里存在这条路径”。这条路径是否真的会出错、已有的保护能不能拦住、线上有没有发生过,还需要另外三类证据来回答。
实验:AI对一个项目全仓评审的 117 个疑似问题,逐条写 gtest 验证,测试在 master 上失败即视为确认。结果:36 条红测试确认,3 条被证伪(误报),41 条只能靠源码确认,37 条未验证。
比如我们有一个项目的类实现做了特殊考虑,使得我们可以在单进程里就拉起真实的 Raft 多节点集群,全仓验证所有需要“生产集群”的场景。
fake/mock 的边界就是验证的边界。fake 要走真实入口、用生产配置,并写明替换了什么。
例:分布式 KV 的 hang 告警 Bug 没被测出来,是因为测试用的设置和实际生产发生的不同;网络阶段的丢弃保护在单测里被手工喂了时间戳,线上路径却从来不设置。
实验:把一台存储节点 11 天的 WARN 日志(67.8 万行、34 个调用点)交给 AI 映射回源码,找到 5 个缺陷,对应的同学人工确认全部属实,没有误报。
其中两个缺陷并不是日志直接触发的,而是 AI 为了解释日志去读相邻代码时发现的,同样属实,日志提供的真实配置和数量级,可能也让相邻代码的推理更准。这只是一个样本,不能说明总能零误报,但足以支持一个做法:能拿到运行时日志时,评审和 Debug 都应附上。日志的局限是只覆盖执行过的路径,行号也可能与部署版本不符(需按消息文本定位)。
证据 | 能回答 | 回答不了 |
算法工程师的一天是“改代码—提交训练—等待—看日志—决定下一步”,过程中还经常被打断。我们团队从 Karpathy 的 AutoResearch 出发,经过三次架构重构,搭建出一套可在企业云端训练平台使用的算法研究自进化系统:系统从单线程 LOOP 探索升级为 CyclicGraph Engine 图探索架构,用状态机保证长周期运行的稳定性,并通过“业务知识库 + 真实大闭环 + 经验自动沉淀”实现系统自进化、越用越好用。
在结构、目标与场景均不相同的两个业务建模项目中,单任务完成耗时较人工基线分别减少约 85% 与 83%,其中一个算法模型已将系统自主推导的方案推全上线,并取得线上收益;另一个多目标项目中,系统产出的方案在全部 12 个预估目标上同时超过人工基线。两个项目唯一的共同点是同一套系统架构,说明增益来自架构本身。本文分享这套系统的设计理念、架构演进与可信度设计,希望对大家有所帮助或启发。
一个算法工程师的典型工作流是:修改代码、推送代码、提交训练、等待、查看日志提取指标、与上一轮对比、决定下一步。等待的间隙,工程师会切换到其他任务,但切换有成本,时间利用不充分;如果训练在凌晨完成,还要等到第二天继续。一天下来,大约完成 2~3 次实质性迭代。真正需要判断力的环节,反而被切换和等待挤压得所剩无几。
2025 年底,Andrej Karpathy 开源了 AutoResearch:一个在单张 H100 上训练 5000 万参数教学级 GPT 的实验原型。仓库只有三个文件:program.md 用自然语言描述研究规则,train.py 是 Agent 唯一可自主修改的训练代码,prepare.py 负责评估。正是这个极简组合,让 LLM 驱动的研究在夜间和周末自动运行。约两天内,系统运行约 700 次实验,产出约 20 个针对 val_bpb 的正向提交。这套循环背后有一个刻意的信任设计:负责评估的 prepare.py 被冻结为不可修改文件,Agent 只能改训练代码而不能改评估函数,从机制上杜绝了“篡改裁判”的可能;而 keep/reset 的 Git 棘轮机制让每一步改进都可审计、可回滚。
这让我们看到了“让 Agent 自主迭代”的可能性。但把它搬进企业场景后,三个问题很快暴露:

本文要讲的,是我们如何在三个月内经历三次架构重构,最终跳出 LOOP 架构,从“跑起来”走到“能自动化、自进化”:V1 回答“能不能跑”,V2 回答“能不能稳定地跑”,V3 回答“能不能跑得又快又准”。
在展开架构细节之前,先说清楚我们的五条设计理念,后面所有取舍都由此推导:
三个版本不是提前规划的路线图,而是被真实问题驱动的演进。

定时任务 + Shell 脚本周期性触发,单个 Agent 串行完成检查、提取、分析、改代码的全链路,报告归档到云端协作文档。V1 实现了企业云端的 AutoResearch,但上下文爆炸、状态同步不及时等问题造成了低效。
每次触发创建全新会话,状态持久化在 JSON 状态文件中,解决了长会话带来的上下文爆炸问题。架构拆分为 Monitor 与 Iterator 两个角色,依靠状态文件的 phase 字段互斥路由,同一时刻只有一个角色工作。状态文件只保留决策所需的最小信息,目标是把探索结果压缩为可复用的决策依据;这是针对 ML 迭代场景的定制设计,与通用图编排框架的“全量状态”思路不同。另一个关键决策是“无状态触发 + 有状态文件”:Agent 不同步等待训练(训练动辄数小时,长会话等待既浪费上下文也不可靠),而是靠定时触发的新会话在下一次唤起时从状态文件恢复现场,这为 V3 的异步并行打下了地基。
V3 打破了 V1、V2 沿用的单线程 LOOP 限制,核心机制是 Spawn-Converge:

需要强调的是,这与“多开几个实验同时跑”有本质区别。并行只是手段,配套的是三步闭环:主 Agent 先拆互斥假设,子 Agent 各自独立验证,主 Agent 最后收拢对比做决策。如果只并行、不收拢,就退化成了多开实验。
调度层面,系统自 V2 起逐步演进为状态机驱动:异步触发 + 状态恢复,Agent 不同步等待训练,而是依靠状态机在下次触发时查询结果。这是对“训练需要数小时”这一物理约束的合理架构回应,也显著提升了系统稳定性与流程灵活度。

图架构的效率收益可以直接量化。在同一个建模项目上:LOOP 架构下 10 次迭代耗时 3 天(0.14 次/小时)且未取得突破;切换为图架构后,12 次迭代仅耗时 4.7 小时(2.55 次/小时)并达成目标,迭代速度相差 18 倍(完整效果见第 8 节)。
差异并非来自单次训练变快,而是来自四点:正交并行把每轮的信息获取量提升约 3 倍;“汇总—分发”的组织形式提高了单位时间内的有效决策数;边界探针快速确定参数的上下界;单变量控制避免了因变量混淆产生的无效迭代。
通用 Agent 不懂你的业务。让系统真正可用的关键,是把它垂直耦合到具体业务场景,而这靠的是业务知识库 + 真实大闭环。
初始化一个新项目时,系统会要求提供基础业务知识库(建模目标、样本口径、历史结论、约束边界),并结合自动化的初始调研构建方向池,保证知识库的起点是干净的。
系统的调研方式分三层:
离线指标提升只是中间站。方案上线后的真实反馈(线上实验结论、业务口径的指标变化)会回流进知识库,成为系统在垂直场景内最稀缺的优质数据。离线指标升降是明确的、可机器判读的;线上闭环数据则校准“离线好”与“线上好”之间的偏差。在系统使用过程中,通过知识、经验与工具的持续积累与回流,实现系统在垂直场景的自进化。
长周期自动循环中,Agent 的不可靠行为分为两类,成因和治理手段完全不同:
治理原则是一句话:凡是能用代码表达的约束,一律不放在 Prompt 里。Prompt 里写“不要重复已证伪方向”并不足够,Agent 仍可能认为“这次情况不同”;但已证伪方向一旦写入状态文件的硬约束列表,下一轮就会在代码逻辑层面被直接跳过。针对执行层偏差,系统在三个环节设防:关键状态以状态文件为唯一事实源,易过期字段(如任务 ID)每轮强制重新读取,禁止复用上下文旧值;所有平台调用封装为幂等化工具,返回值做结构化校验,字段缺失或格式异常即判定失败,而非带着空值继续执行;区分代码故障与基础设施故障,前者计入证伪记录并触发方案调整,后者自动重试且不占用轮次预算。
系统保留每一轮探索的原始指标提升和原始代码 diff。Agent 的分析可能有幻觉,但指标数据和代码修改本身是确定真实的。任何一轮的结论都可以回溯到证据链,而不是回溯到某段叙述。这一点来自我们对幻觉复合效应的观察:循环里错误结论一旦被喂入下一轮上下文,就会在错误前提上叠加错误推理,步步错但步步“看起来合理”;唯一的反制,是让训练结果这样的物理事实成为不可绕过的校验锚点——模型可以幻觉“学习率太小”,但训练跑完后的指标曲线不会配合它幻觉。
子 Agent 探索时上下文相互隔离,或改用不同模型,从两条路径验证同一个假设,检测分歧。汇总时主 Agent 对照几份独立结果再做决策,天然带一层交叉验证。交叉验证并非每轮都做(成本太高),而是在主 Agent 置信度偏低、连续多轮指标同向恶化、或归因涉及方向性决策时触发;分歧结论同时保留并转入人工审查,而非简单投票取多数。
系统在执行过程中会自动总结工具使用经验与踩坑处理方法,沉淀出可复用的 Skill 草稿,经过“系统初筛 + 人工审核”的两级校验后,正式写入系统工具集。一个真实例子:早期批次中训练平台参数服务器连接异常的处理经验被系统自动整理为 Skill 草稿,人工审核后反哺至工具集,此后系统自主应对数百次同类基础设施故障,全程无需人工介入。已入库的 Skill 也会在后续使用中通过审核机制持续自完善。这背后是一条反幻觉的晋升链:经验先作为带证据的低层级记录存在,满足复用规则并通过人工审核后才晋升为正式 Skill,未经外部验证的结论永远不进入知识库,只暂存在临时区。

Agent 的归因(“为什么这个方向有效”)仍是开放难题。我们的答案不是某个单点技术,而是三方面积累:知识库的积累让归因有业务依据,调研的积累让归因有论文依据,真实实验数据的积累让归因有证据依据。归因能力是慢变量——Harness 建设得好,它会随使用时长持续变好;这本身就是自进化系统设计的一部分。
我们把套在通用 Agent 外、让它在生产流程中稳定行动的一组运行规则(状态文件、工具返回校验、失败恢复、经验库、硬约束、提示词)称为 Harness。外部也有同方向的实证:LangChain 的编码 Agent 全程使用同一个模型,仅调整 System Prompt、Tools、Middleware 三个 Harness 维度,在 Terminal Bench 2.0 的 89 个跨领域任务上得分从 52.8% 提升至 66.5%。同一个模型,换一套工作机制,差异达到 14 个百分点。我们的三次重构,本质上就是在与底层通用 Agent 解耦的前提下,打磨这套领域特定的 Harness,它决定系统是加速发现真理,还是加速传播错误。基座模型的能力红利人人可得,而 Harness 是差异化竞争力的所在。

系统与底层 Agent 基座彻底解耦,核心设计是“无状态触发 + 有状态文件”:状态全部落在 JSON 文件里,每次触发都是全新会话。这个设计带来三重收益:随时可触发——不受会话生命周期限制,定时、手动、事件驱动任意唤起;零空转——Agent 不同步等待动辄数小时的训练,触发即工作、完成即退出,长周期任务中也能充分利用计算资源;基座自由——不依赖任何基座的会话记忆或专有能力,Agent 基座升级后,系统可无缝切换。
在前端交互层,我们尝试过 IM 机器人、内部 Agent 平台、自建沙箱等多种形态,框架设计与交互形态完全解耦——换个入口,系统照常运转。
对使用者来说,开启一个新项目非常轻:
用户:我要开始一个新项目,需要给你提供什么?
系统:需要提供基础业务知识库(若有缺失,会询问补充)、需要优化的业务指标、报告归档的云端文档目录、迭代上限和阈值指标(主要用来防止无限制消耗资源),并给出一份可直接填写的需求模板。
用户:填写模板文档,把链接发给系统。
系统:启动自动迭代。中途用户可随时询问进度、打断;如果不打断,系统会在达成目标或达到上限时自行停止。
项目启动后的典型体验是:周五启动,周一回来发现系统已自主完成十余轮迭代,核心指标显著改善,期间零人工介入。这直接修正了我们对人机分工的初始设定(“AI 执行、人监督每一轮方向”);实践后收敛出的分工边界是:人的价值集中在少数几个高杠杆节点上,而非分散在每一轮的执行监督中。

在两个模型结构、优化目标、场景均不相同的建模项目上,系统给出了高度一致的答案:单任务完成耗时较人工基线分别减少约 85% 与 83%。两个项目唯一的共同点是同一套系统架构,这说明增益来自架构,而不是某个项目的特殊性。其中一个项目中,系统自主推导出的优化方案(不在任何参考论文中)已通过全部验证并推全上线,取得线上收益;另一个多目标项目中,全部 12 个预估目标均超过人工基线。

最关键的一点:工程界主流的 AutoML 默认“正确答案在预定义搜索空间内”。而在我们的实际案例中,正确答案恰恰不在初始空间内——系统需要先证伪并退出一个错误的问题框架,再从论文的数学结构中推导出新的候选方案。这是能力层级的差异(从“执行给定方向”到“自主生成假设”),而非搜索效率的差异。
验证覆盖三件事:离线指标、线上实验、可解释性检验。前两件决定上线和推全——离线指标达标后,用线上 A/B 实验结果的置信区间判断是否推全;第三件决定能不能进硬约束库——若 Agent 给不出合理的推导,即使指标好也不入库,避免错误经验污染知识库,无法判断是否可入库时转人工审核。
这套架构适用于同时满足三个条件的场景:有明确的可量化指标;单次实验成本可接受;实验结果可逆。它不适用于评价高度主观、搜索空间完全开放、或单次实验成本极高且不可逆的场景。
下一步的方向:一是提升自进化稳定性 —— 自进化技术架构方向已确定,后续持续打磨状态机与流程稳定性;二是知识迁移中的幻觉问题 —— 如何稳定复用跨业务的经验,保证经验库干净稳定;三是探索更友好的交互与使用体验。
Karpathy 的 AutoResearch 是一个在单张 H100 上跑教学级 GPT 的实验原型。我们所做的,是把这套理念搬进企业云端的真实业务场景:在工程化过程中发现单线程 LOOP 的根本局限,用 CyclicGraph Engine 的图探索架构打破它;用状态机保障长周期运行的稳定性;用业务知识库和真实大闭环,让系统在垂直场景里越用越好用。
我们相信,Agent 自主研究的真正价值不在于“比人更快地搜索已有空间”,而在于“能够证伪错误的前提,并主动扩展搜索空间”。当系统能够从论文的数学结构中推导出人类未给定的方案,并在真实业务中验证有效时,它已经从“执行工具”走向了“研究伙伴”。这条路才刚刚开始。
最后回到方法论本身。三个月三次重构给我们的最大启发是:自主研究系统的核心工程量不在模型侧,而在 Harness 侧——状态机、硬约束、证据链、晋升门槛这些“不性感”的基础设施,才是决定系统可信度的分水岭。评估这套系统的正确方式也不是看它跑得多快,而是看它犯错之后能否被证据纠正、被约束拦住、被经验库记住。可复现、可审计、可回滚,是自主研究系统比效率更重要的底座。
搜索和推荐场景中想要使用语言模型提高在线效果,往往面临着在线极低延迟的约束,现有通用大模型推理引擎并非在这一延迟约束下设计,因此本文从「具有确定 decode 次数上界的请求」这一工作负载出发,重新设计在线执行路径:以静态 DAG 组织完整业务请求,结合 AOTInductor 编译、Packed Prefill、请求内 K/V 共享及选择性 FP8,系统性压缩调度与计算开销。在平均端到端时延低于 20ms 的约束下,Prefill-only 有效 MFU 达到 67%,吞吐较 SGLang 提升 10 倍,为 SLM 在搜推场景的大规模落地提供了一套高性能、可复用的工程实践。
搜推场景下业界逐渐使用 SLM(Small Language Model, 小参数量语言模型0.5~1B),用于意图理解,相关性判断,生成式推荐等任务,这些模型保留 Decoder-only Transformer 和 Next-Token Prediction 的基本结构,但在线执行形态与开放式文本生成存在明显差异:
本文将这类控制流结构、状态容量和执行资源能够在部署前界定,输出 decode 的次数具有固定上界的请求,统称为有界生成负载;其中Prefill-Only 可以看作为 decode 次数为 0 的特殊情况;
在项目早期,我们通过 Triton Inference Server 的 Python Backend 适配业务协议,并使用 SGLang 完成模型执行。该方案能够快速复用 tokenizer、生成调度和状态管理能力,支持业务快速实验拿到效果。但随着 SLM 在搜索场景的持续应用,越来越多的场景取得显著收益,推全成本也在显著增加,业界现有方案已经不足以支持更大规模的落地 SLM,我们随即基于模型负载的独特性,提出专为有界生成负载设计的推理系统。
我们构建了一套以静态有向无环图(Directed Acyclic Graph, DAG)为在线执行抽象的推理框架,将完整业务请求作为 DAG 执行、端到端测量和容量规划的共同边界,并以节点作为模型编译边界。模型计算节点使用 PyTorch AOTInductor 生成的 AOTI 产物,文本处理和数据转换由框架自定义节点完成,Runtime 负责节点调度、资源管理和并发执行。针对有界生成负载,系统进一步将 Packed Prefill、请求内 shared-prefix K/V 布局、固定 Beam Search 编译和选择性 FP8 矩阵计算等自定义实现嵌入 AOTInductor 编译流程。
性能结论表明,约 0.6B 的 Prefill-Only 模型在每个请求包含 15 条样本时达到约 100 request QPS,即约 1,500 sample/s;约 0.5B 的短 prompt 和长 prompt Beam Search 模型在 beam width 约为 100、decode 4 次时,分别达到约 300 和 120 request QPS。三类负载的平均端到端时延均低于 20 ms,P99 约为 70 ms,Prefill-Only 负载下混合精度有效 MFU 为 67%,约为 SGLang 10 倍,短 prompt beam search 有效MFU 41%,约为 SGLang 6 倍。
目前,该框架已经在美团搜索意图分流、搜索相关性判断、生成式召回等应用 SLM 的场景取得实验显著性,能支撑业务在推理成本可控的情况下全量推送。
本文关注搜索推荐场景下一类在线执行过程受到业务约束的 SLM 负载:模型仍采用 Decoder-only Transformer,但一次请求涉及的模型阶段和最大迭代次数固定,搜索宽度和状态容量也具有可在部署前确定的上界。实际输入长度、batch 大小和搜索候选仍能随请求变化,但这些动态性均发生在预先配置的容量范围内。
“执行结构固定、动态 shape 可控”是后续系统设计的基础。这些约束来自具体业务的在线执行方式,与模型参数量或模型结构没有必然关系;同一个语言模型用于开放式文本生成时,也可能不满足这里的有界条件。
Prefill-Only 模型只执行一次 Transformer prefill,不进入自回归 decode。模型在每条序列最后一个有效 Token 位置计算 Next-Token Logits,再根据目标标签对应 Token 的 logits,通过 softmax、Top-K 或固定映射得到业务输出。该路径仍使用语言模型的 Next-Token Prediction Head,但在线执行只包含一次批量前向过程。Prefill 结束后即可返回结果,不需要跨阶段维护该请求的 K/V 状态。
Beam Search 模型在 prompt prefill 后继续执行固定次数 decode。首步 logits 用于初始化候选,后续每一步从各 beam 的 Token 分布中选择局部候选,与历史累计分数合并,再保留固定数量的候选序列。对于一个具体部署配置,beam 宽度和最大生成 Token 数均为固定值。Beam Search 中的候选、累计分数和 parent index 仍由模型输出决定,但状态容量、更新次数和算子组合可以提前确定。

本文覆盖的请求平均输入长度均在 500 Token 以内,输出则是分类分值或少量生成 Token。部分 Prefill-Only 请求包含多条输入样本;有界 Beam Search 的 beam 宽度和最大生成步数由部署配置确定,本文覆盖的配置不超过 400 beam 和 5 个生成 Token。两类请求的实际输入和候选内容会变化,但处理规模和状态容量都具有明确上界。
对于同一 batch 内的变长输入,统一 padding 会使短序列承担与最长序列相同的线性层、MLP 和 attention 计算。系统因此保留每条序列的有效长度,并在后续 Prefill 计算中只处理有效 Token。
Prefill-Only 请求在一次前向后结束,不需要跨阶段保存 K/V。有界 Beam Search 只在少量 decode step 之间维护状态,同一请求内的 beam 共用一份 prompt K/V,并分别保存较短的 suffix K/V。输入长度、beam 宽度和生成步数均有上界,因此所需状态可以在加载阶段完成容量规划和内存预分配。
跨请求 prefix cache 的收益取决于公共 Token 前缀的长度和命中率。当前模板较早进入业务 Query、候选文本等请求特有内容,不同请求间可复用的公共前缀很短,实际命中率也很低;同时,平均输入长度不足 500 Token,缓存管理能够摊薄的计算有限。因此,系统不维护跨请求 Prefix Cache,只利用同一 Beam Search 请求内部确定存在的 prompt K/V 共享。
由于 GPU 推理本质上是基于 Cuda Stream 的串行计算,因此推理服务的耗时可以抽象为排队论中的 G/G/1 模型。排队等待时间的经典工具是 Kingman 近似公式(G/G/1 排队): , 线上统计 QPS 是每秒处理的请求数,因此衡量推理性能的时间窗口就是 1000ms, 则可以对公式进行如下解释:
推理耗时可以分为四部分,CPU 入口等待时间、CPU 处理时间、GPU 入口等待时间、GPU 处理时间。 CPU 通常并发处理能力远强于 GPU,因此 GPU 成为资源瓶颈。 越大, GPU 入口等待时间就会延长,当超过上游超时后,排队中的请求被 GPU 顺序执行则是一种浪费,大量请求的丢弃又会导致 GPU 在 1000ms 内的处理时间不足,也就是 偏低。于是呈现出一种 GPU 利用率很低但耗时却很高的现象。
在搜推场景下,由于序列分批导致请求到达间隔严重偏离泊松分布,服务时间通常是稳定的(序列长度和 batchsize 基本固定),单次推理的平均耗时一般在 20ms 以下。 传统的 SGLang/vLLM框架并不是在这样的假设下设计,调度策略难以处理严重偏离泊松分布的请求到达负载,而其为了prefill 长度任意变化,decode 次数无上界等场景设计的各种优化策略,在搜推的 SLM 场景均是负向优化。

我们利用 在搜推场景下较小的优势,移除 SGLang 为无界生成负载定制的各种优化手段,重新为有界生成负载(Prefill-Only & Beam Search)设计 GPU 计算路径,以达到减少 的目的,通过移除 Python 对 request 和 Token 的调度开销压缩 CPU 等待与处理时间,从而达到减少 GPU 空泡的目的,进一步通过 cpp 精细化的 Multi-Stream 调度能力,增加 GPU 跨请求并行计算的能力,以缓解无法调和的 。
上述业务约束将系统问题收束为:如何高效处理边界已知的一批输入。编译、执行和容量控制均围绕这一目标组织。

整体上,本文实现的是一套以静态 DAG 组织完整请求流程、以独立节点封装具体计算的分层编译执行架构。离线构建链使用 Python 表达模型语义、选择算子实现,并将完整 GPU 计算编译为可直接加载的 AOTI 节点产物;在线执行链使用 C++ 完成协议处理、DAG 调度、资源管理和数据转换,不再解释或即时构建模型计算。

在线执行链进一步分为服务、DAG Runtime 和节点三个层次。服务层负责 RPC 协议、请求准入和生命周期;DAG Runtime 根据静态拓扑调度节点,并管理跨节点 Tensor、设备同步、请求上下文和并发;节点负责具体计算,其中 CPU 节点承载文本处理和结果编码,GPU 节点加载 AOTI 编译产物。Runtime 只依赖节点的输入输出、设备和执行接口,attention、Beam Search 和精度策略都封装在节点内部。
离线构建:Torch 模型与算子语义
            -> lowering 与 AOTInductor
            -> AOTI 模型节点产物

          C++ 节点实现与配置
            -> CPU 自定义节点与资源

在线执行:RPC 服务
            -> DAG Runtime
                 -> CPU 预处理节点
                 -> AOTI 模型节点
                 -> CPU 结果节点
            -> RPC 返回
两类模型在这套架构中对应两张不同的 DAG:

这种分层首先使系统可以按完整业务请求执行:Prefill-Only 的多条样本一次进入模型节点,Beam Search 的各个 decode step 在生成节点内部完成。其次,静态拓扑和有界 shape 使 buffer、stream 和执行实例能够在加载阶段规划,请求热路径只处理有效数据。最后,模型计算被封装在节点内部,算子、精度和硬件实现可以独立替换,而服务协议和 DAG 调度机制保持稳定。
项目早期通过 Triton Inference Server 的 Python Backend 适配业务协议,并使用 SGLang 完成模型执行。这套方案能够快速复用 tokenizer、生成调度和状态管理能力,适合模型验证和早期上线。但在当时的接入方式中,批量输入会被拆分为多条独立生成请求,分别完成文本处理、状态创建和模型调度,返回后再恢复原有顺序和业务结构;Beam Search 模型的各个 decode step 也继续经过通用生成控制路径。
通用生成系统通常按照独立请求组织调度,并在运行时处理请求的加入、退出和解码长度变化。这种粒度适合开放式生成;对于当前只执行一次 prefill 或少量 decode 的负载,请求拆分、对象创建、进程通信、逐步控制和结果重组却都要在约 20 ms 的端到端时延预算内完成,较长生成任务中能够被模型计算摊薄的固定开销在这里更加显著。
因此我们重新选择执行单位:完整业务请求成为 DAG 调度、端到端测量和线上容量规划的共同边界。Prefill-Only 请求内部可以包含多条样本,但这些样本作为一个 batch 进入模型节点,不再拆成独立生成任务;Beam Search 请求则从 prompt prefill 到最终候选返回只经历一次 DAG 调度。模型编译仍以节点为边界,不与请求调度耦合。
项目早期的执行路径可以概括为:
批量业务输入
  -> 拆分为逐样本生成请求
  -> tokenizer / 请求状态创建
  -> 通用生成 Runtime
  -> 逐 decode step 控制
  -> 结果重组
当前执行路径则为:
业务请求
  -> 协议适配与请求准入
  -> DAG Runtime
       -> 文本处理与 packed tokenizer
       -> prefill / 生成 AOTI 节点
       -> 结果编码
  -> RPC 输出
Prefill-Only 中的多条序列由模型节点一次处理,Beam Search 的逐步控制则收进生成节点。在线请求不再反复跨越 Python Backend、服务进程和通用生成 Runtime,协议处理、DAG 调度、buffer 管理及 CPU 数据转换均在进程内完成。这一执行路径减少了请求拆分、对象创建、进程通信、逐步调度和结果重组产生的固定开销。
静态 DAG 描述协议适配后的节点拓扑、跨节点 Tensor、执行设备和同步关系,而不要求每次请求具有完全相同的数据规模。Runtime 按照以下层次组织执行:
DAG Runtime
  -> Node
       -> CPU Engine  -> 节点配置与本地资源
       -> AOTI Engine -> 编译模型产物
DAG 声明节点之间的依赖和 Tensor 接口,节点类型决定使用哪类执行引擎,执行引擎负责调用具体实现。AOTI Engine 加载模型编译产物,CPU Engine 则调用 tokenizer、数据转换和结果编码等自定义节点,并加载各自的配置与资源。
公开协议中的字符串不会直接作为模型节点输入。在线服务首先将 String 输入转换为连续 UTF-8 payload 和 lengths,DAG 内部再通过 CPU 节点完成规范化、tokenizer 和 packed 数据组织;DAG 输出到 RPC response 的最终映射同样由服务接口完成。由此,DAG 的输入输出保持明确的 Tensor 表示,同时不将具体 RPC 协议耦合到节点实现中。
静态 DAG 固定的是执行结构和物理资源边界,并不要求 Tensor shape 完全固定。系统在加载阶段确定:
请求阶段仍然动态确定:
这一执行模型以固定结构承载有界的动态数据。加载阶段根据动态 shape 上界和执行并发预分配物理资源;请求到达后,CPU 节点只写入本次有效数据并更新逻辑 shape,下游节点仍按实际数据范围执行。输入长度和 Beam 状态等业务动态性得以保留,同时不会改变节点拓扑和物理资源容量。
节点边界主要由跨节点数据表示、执行设备和同步关系决定。字符串规范化、tokenizer 和结果编码由 CPU 节点执行。Prefill-Only 的 AOTI 节点包含 Transformer prefill 和分值计算;Beam Search 的 AOTI 节点则包含 Transformer、候选选择和固定 Beam 状态更新。一个 AOTI 节点可以包含多个算子及其固定组合,DAG Runtime 只负责调用节点,不需要理解内部的模型拓扑、搜索状态或精度策略。
同一请求上下文中的 GPU 操作优先通过 CUDA stream 的提交顺序建立依赖,只有 GPU 结果需要交给 CPU 节点或服务返回响应时才进行必要同步。跨节点 Tensor 的数据搬运也由 Runtime 统一规划,避免每个算子独立管理跨设备传输。
固定 Beam Search 可以把有限次数的状态转移表达为结构确定的 Tensor 程序,同时保留由模型输出决定的候选内容。开放式生成系统通常需要在 decode step 边界重新组织请求状态并决定下一轮执行对象;当前负载的搜索深度固定,这部分控制因而可以从在线 Runtime 移入模型程序。
设最大生成 Token 数为 N_gen。模型首先执行 prompt prefill,并根据首步 logits 初始化候选;随后固定执行 N_gen - 1 次状态更新。每一步维护的主要状态包括:
这些状态的内容由当前模型输出决定,但状态 Tensor 的容量、更新流程和算子组合在部署阶段已经确定。因此,Beam Search 不由 C++ Runtime 手写逐 Token 控制,而是在 Torch 模型中表示为固定结构的张量程序,并与 Transformer 一同导出和编译。
prompt prefill
  -> 首步候选初始化
  -> [
       decode
       -> 局部候选选择
       -> 累计分数合并
       -> parent index 更新
       -> token 与 suffix K/V 重排
     ] × (N_gen - 1)
  -> 最终候选及分数
整个过程最终封装为一个生成 AOTI 节点。DAG Runtime 对该节点只执行一次节点调度,不感知内部包含多少次 decode,也不理解 Beam Search 的候选选择和状态更新语义。
固定的是控制流,不是模型输出。parent index 仍会动态决定 suffix K/V、token sequence 和累计分数的重排,候选内容也仍取决于每一步 logits;这些数据依赖不会改变 Runtime 所看到的节点拓扑、Tensor 接口和资源规模。
将逐 step 控制收进编译节点后,请求不再在每个 token 后返回通用生成 Runtime。Transformer 计算、候选选择和状态更新可以在同一导出图中统一优化,在线服务只看到 generation 节点的输入和最终输出。
离线编译链的核心作用是将模型语义与硬件实现选择解耦。Python 侧负责表达模型和算子语义、选择 lowering 并构建产物;在线服务和 DAG Runtime 只加载已经生成的节点产物,不导入 Python 模型代码,也不进行即时编译。
对于具有独立数学语义、值得针对目标 GPU 选择实现的计算单元,框架定义稳定的可替换算子接口。Torch 参考实现明确规定输入输出、shape、dtype 和数学语义,构建配置再根据目标 shape 和硬件选择 Torch、Triton 或原生 C++/CUDA 实现。lowering 只替换节点内部的具体计算路径,不改变 DAG 可见的 Tensor 接口。
整体构建链如下:
Torch 模型
  -> 算子 lowering
  -> torch.export
  -> AOTInductor
  -> AOTI 共享库
  -> 节点配置与 manifest
  -> 可部署节点产物
Triton lowering 可以通过 torch.library.triton_op 和 wrap_triton 进入导出图;需要原生 C++/CUDA 扩展时,则在目标构建过程中将对应接口和静态库链接进节点产物。权重转换、packing、量化参数准备以及目标 GPU 相关的 kernel 配置也都在离线阶段完成。
模型定义还将运行时配置、编译配置和验收标准固化为可检查的部署描述:
模型结构和节点接口不变的新 checkpoint 可以复用大部分构建描述,但仍需重新检查参数映射、数值一致性和性能。接口复用并不意味着性能配置可以直接继承。
这种分层还使局部实现能够在接口不变的情况下替换。候选 kernel 先通过算子基准和数值对照筛选,再进入节点和完整 DAG 的 A/B 测试;只有在完整在线链路中仍能形成可辨认收益的实现,才会进入最终部署配置。由此避免仅根据 microbenchmark 决定线上实现。
明确的语义参考、可替换 lowering 和分层验收也为 AI 辅助优化提供了边界:AI 可以参与模型重表达和候选实现生成,最终选择仍由确定性的数值、业务指标和端到端性能验证决定。
状态和控制流有界,使执行资源能够在模型加载阶段按并发配置预先建立。在线链路中存在三个不同层次的并发参数,三者约束的资源不同,不能合并为一个统一的 concurrency 配置。

DAG 请求上下文持有一次请求执行所需的预分配 host/device buffer、逻辑 shape 状态和 CUDA stream。AOTI 执行实例负责调用已经加载的模型产物,并由执行引擎管理 runner、workspace 和权重资源。
加载阶段根据目标 GPU、动态 shape 上界和配置并发建立 DAG 请求上下文、Tensor 物理 buffer 和 AOTI runner。请求热路径只获取可用上下文、写入有效输入、更新逻辑 shape 并提交节点任务。
系统采用单个请求不跨卡、每张 GPU 部署完整模型副本的方式,不涉及 Tensor Parallel 或 Pipeline Parallel。不同卡型的算力、显存带宽、功耗限制和软件环境可能不同,因此节点内 kernel、精度配置和执行并发均按 GPU 独立选择;DAG、节点接口和资源管理机制保持不变。
容量配置按照完整链路逐层确定:先固定节点实现,再扫描 AOTI 执行实例数和 DAG 请求上下文数,最后设置服务入口的在途请求上限。每一步均通过端到端 QPS 和时延复核,避免将节点内部最优并发直接视为服务最优并发。
服务入口在已经验证的执行容量之外承担过载保护。后端暂时满载时,请求可以在入口有限等待;超过业务允许等待时间的请求不再进入后端计算。若持续到达速率高于单卡处理能力,服务按照配置拒绝或超时退出多余请求,避免已经失去业务时效的请求继续占用执行资源。
通过上述划分,在线系统只负责按照 DAG 执行完整请求,模型语义、固定生成过程和硬件实现均在节点构建阶段确定。第 3 章进一步介绍节点内部针对变长 prefill、Beam 状态、矩阵计算和 CPU 数据路径的专项优化。
完成执行边界的调整后,系统吞吐主要取决于模型计算节点和相邻 CPU 节点的处理能力。两类负载中仍存在五类主要开销:变长样本的 padding 计算、Beam 间重复的 prompt K/V、候选选择与状态更新、密集矩阵计算,以及文本处理和结果编码的固定开销。
这些优化均以节点接口和数学语义不变为前提。Torch 实现提供数值和语义参考,构建阶段再根据目标 shape 和 GPU 选择具体 lowering 策略;候选实现依次通过算子、AOTI 节点和完整 DAG 验证后进入部署配置。
Prefill-Only 请求内包含多条长度不同的样本,统一 padding 会使所有样本按照最长序列执行线性层、MLP 和 attention。系统从 tokenizer 开始保留序列边界,将有效 Token 连续写入 packed buffer,并在一个模型节点中完成整个请求的 prefill。
请求内的多条字符串
  -> 连续 UTF-8 payload + lengths
  -> 批量 normalize / tokenize
  -> packed token buffer + sequence boundary
  -> packed Transformer prefill
  -> 各序列末位置 hidden state
  -> 每条样本的类别或分值
设第 i 条序列的长度为 L_i,query head 数为 N_q,K/V head 数为 N_kv,head dimension 为 D。packed attention 使用以下输入输出布局:
Q:   [ΣL_i, N_q,  D]
K/V: [ΣL_i, N_kv, D]
O:   [ΣL_i, N_q,  D]
sequence boundary 隐式定义 block-diagonal causal mask:不同序列之间不存在 attention 连接,每个 Query 只能访问同一序列内不晚于自身的位置。与统一 padding 相比,线性层和 MLP 的序列维计算规模由 B × L_max 降至更接近 ΣL_i,attention 则由 B × L_max² 降至更接近 ΣL_i²。batch 内长度差异越大,减少的无效计算越多。
FlashAttention-2 已提供成熟的变长 attention 实现。但在项目部署环境中,其变长接口无法同时满足 AOTI 集成与目标 GPU 兼容要求。系统因此采用针对目标 shape 优化的 Triton Packed GQA。
Triton kernel 不展开 GQA 的 K/V head,也不物化完整 attention score。kernel 根据 sequence boundary 确定当前 query block 对应的有效 K/V 范围,对 K/V 分块扫描,并使用 FP32 累积 online softmax 的最大值、归一化因子和输出状态。模型图随后使用同一套 sequence boundary 提取各序列末位置的 hidden state,再计算标签 logits、业务分值或生成所需状态。
sequence boundary 从 tokenizer 贯穿 attention 和结果提取,并与模型一起编译进 AOTI 节点。模型节点由此可以一次处理请求内的完整 batch,并按样本边界恢复输出。
Triton Packed GQA 使用显式 Torch 实现作为数值参考。代表 shape、边界 shape 和多序列用例共同验证数值误差与序列隔离。相对显式 Torch Packed Attention,该实现使中等和长 prompt 负载的完整 DAG 吞吐分别提升约 12% 和 39%。
有界 Beam Search 中,所有 beam 共享同一个 prompt,仅生成 suffix 随搜索路径发生变化。这种固定的共享关系允许系统只保存一份 prompt K/V,并为每条 beam 保存较短的 suffix K/V:
prefix K/V: [L_p,    N_kv, D]
suffix K/V: [W, L_s, N_kv, D]

query:      [W,      N_q,  D]
output:     [W,      N_q,  D]
若每条 beam 分别保存完整 K/V,状态规模与 W(L_p + L_s) 成正比;使用 shared-prefix 布局后,则与 L_p + W L_s 成正比。对于本文固定 beam 宽度、同步推进且生成深度较小的负载,prompt 状态只需建立一次,请求结束时再与各 beam 的 suffix 一并释放。
对第 b 条 beam,attention 的数学语义仍为:
其中分号表示序列维拼接。实际执行不会生成对应的 concat Tensor。Triton kernel 直接读取公共 prefix 和当前 beam 的 suffix,并在同一组 FP32 online softmax 状态中合并两段 K/V 的贡献。
kernel 按 (beam, K/V head) 划分 program,每个 program 处理该 K/V head 对应的多个 Query Head。该路径不需要展开 K/V head,也不需要 page table 查询或 prefix/suffix 中间拼接。parent index 更新时,只重排较短的 suffix K/V、历史 Token 和累计分数,公共 prompt K/V 始终保持不变。
Shared-prefix 布局保留每条 beam 对完整 prompt 的 attention 计算,只改变 K/V 的物理组织和访问路径。收益来自减少 prompt K/V 副本、拼接 Tensor、分页索引和相关数据搬运。
项目曾评估 FlashInfer 的共享 page table Paged Decode 路径,该候选在当时的对照中使完整 DAG 吞吐提升约 3%,但它与 FlashAttention 路径在集成至 AOTI 编译流程后均存在稳定性问题,因此未被采用。
固定 Beam Search 沿用原有的两级候选选择规则:每一步先处理 W × V 个词表分数,再从各 beam 的局部候选中选出全局候选。系统保持候选集合和累计分数语义不变,将候选选择、精度转换和状态重排改写为固定 Shape 的 Tensor 数据流,并且只搬运下一步真正保留的状态。
设词表大小为 V,beam 宽度为 W。完成首步候选初始化后,每个 decode step 会生成 [W, V] 的 logits。系统先在每条 beam 内选出 2W 个局部候选,再将这些候选与历史累计分数相加,最后从 W × 2W 个扩展中选出全局候选:
BF16 logits [W, V]
  -> 每条 beam 选出 2W 个 token ID
  -> 从 FP32 log-probability 中读取对应分数 [W, 2W]
  -> 加上各 beam 的历史累计分数
  -> 展平为 W × 2W 个候选
  -> 选出全局候选及其 parent index
  -> 仅为下一轮 active beam 重排 token、分数和 suffix K/V
中间步骤保留 2W 个全局候选,是为了同时接收已经生成 stop token 的完成序列,并从其余候选中继续选出 W 条 active beam。局部裁剪不会改变这组全局候选:任意一条 beam 排名在本 beam 第 2W 名之后的 Token,都不可能进入全局前 2W。因此,全局候选合并处理的数据量从 W × V 降为 W × 2W;当词表远大于 beam 宽度时,这一差异十分明显。裁剪边界存在同分候选时,具体 Token 和顺序由冻结的 Top-K 实现决定;业务语义只要求分数等价及相同实现重复执行结果一致,不依赖同分候选的固定顺序。
候选 ID 和候选分数采用不同的数据路径。log-softmax 对同一行 logits 保持严格单调,因此 Token ID 可以直接在 BF16 logits 上通过 Top-K 确定;候选分数则由完整词表上的 FP32 log-softmax 计算,再按照入选 ID 读取。这样既保留累计概率所需的 FP32 精度,也避免 Top-K 再扫描一份 FP32 词表 Tensor。
全局候选展平后,一个索引即可同时确定来源 beam 和该 beam 内的候选位置。来源 beam 被记录为 parent index,下一步直接用它选择对应的历史 Token、累计分数和 suffix K/V。已经淘汰的候选不再复制搜索状态,公共 prompt K/V 也不参与重排。
上述候选裁剪、分数合并、parent index 计算和状态重排均位于固定 Beam Search 的 AOTI 节点内部。每个 decode step 只执行定长 Tensor 操作,不返回在线 Runtime 创建候选对象或重新组织请求。项目也评估过专用 GPU Top-K 实现,但完整 DAG 没有获得稳定的额外收益,最终保留 Torch Top-K,并将优化集中在候选数据流和整体编译上。
代表模型的大部分矩阵 FLOPs 集中在 MLP、其他线性层和 LM head。系统优先将这些计算密集且能够形成端到端收益的路径转换为 FP8,同时在 softmax、候选排序、累计分数和最终业务分值等敏感位置保留 FP32 中间计算。
以 MLP 为例,内部数据路径为:
BF16 activation
  -> per-token dynamic E4M3 quantization
  -> FP8 Gate/Up GEMM
  -> FP32 SiLU(Gate) × Up
  -> per-token dynamic E4M3 quantization
  -> FP8 Down GEMM
  -> BF16 output
activation 使用 per-token 动态 scale,权重在离线阶段转换为 E4M3,并保存 per-output-channel 的 FP32 scale。节点之间仍传递 BF16 Tensor,使低精度计算只局限在已经通过验证的矩阵路径内。
Gate/Up projection 通过一次 FP8 scaled matmul 产生中间结果。随后的 Triton kernel 以每个 token 对应的一行为处理单位,在一次遍历中完成 FP32 SiLU、逐元素乘法、amax reduction、scale 计算和 E4M3 重新量化,避免生成完整的 BF16 SwiGLU 中间 Tensor。Down projection 直接读取量化后的 activation 和 per-token scale,再通过第二次 FP8 scaled matmul 返回 BF16 输出。
动态量化、scale 计算和格式转换本身也会占用时间,较小或计算占比较低的 linear 无法稳定获得收益。长 prompt 模型最终只对 MLP 使用 FP8;短 prompt 模型的 LM head 计算占比更高,在通过数值和业务验收后也纳入 FP8。以 Prefill-Only 模型为例,MLP selective FP8 相对全 BF16 路径使完整 DAG 吞吐提升约 24%。
attention 点积累积和 online softmax 状态、log-softmax reduction、动态量化 scale、Beam 累积分数以及最终业务敏感分值继续保留 FP32 中间计算。这些精度保护策略并非完全通用。不同模型需要分别确定 FP8 覆盖范围,kernel 和分块配置也需要针对目标 GPU 固化;直接沿用其他模型或卡型的配置,可能同时损害业务效果和性能。
在小模型和短输出负载中,tokenizer、字符串处理和结果编码难以被 GPU 计算摊薄,优化前已经成为完整请求时延中不可忽略的组成部分。这些固定执行且数据规模有界的处理统一由 C++ CPU 节点完成。
业务 tokenizer 在基础词表之外增加了一批需要优先识别的 added token。原有实现会对这些 Token 逐项执行字符串查找;当前实现把 Token 的 UTF-8 字节组织成 byte trie,即按公共字节前缀建立的树形索引,使输入可以在一次扫描中完成匹配。匹配仍遵循“优先选择最靠左的起点,同一起点选择最长 token”的既有语义。
服务首先把一个请求中的多条字符串转换为一段连续 UTF-8 字节和每条字符串的长度,CPU 节点据此确定各条文本的边界。文本规范化和 tokenizer 随后直接写入请求上下文中预分配的 token buffer,并同时生成 packed attention 所需的 sequence boundary,避免为每条文本反复创建字符串对象和临时数组。
string input
  -> contiguous UTF-8 payload + lengths
  -> normalize / tokenizer
  -> packed token buffer + sequence boundary
  -> GPU model
结果侧同样使用预分配的连续 buffer。CPU 节点一次解码同一请求中的全部 Beam 候选,并把 Token、Score 和 length 直接写入预分配的 UTF-8 JSON buffer。buffer 的物理容量按最大输出预先建立,实际 length 标记本次请求写入的有效字节数;在线服务据此构造最终 RPC response。
Beam token / score Tensor
  -> 同一请求内批量 decode
  -> UTF-8 JSON payload + lengths
  -> RPC response
这条路径减少了请求热路径中的对象创建、动态内存分配和格式转换。byte trie 与预分配 tokenizer 将代表 prompt 集合上的文本处理由毫秒级压缩到十微秒级。
系统验证沿算子、AOTI 节点、完整 DAG 和在线服务逐层展开。正确性测试确认各层实现保持相同的模型与业务语义,性能测试则以完整 RPC 的 QPS、平均时延和 P99 时延选择单卡容量点,再用分层 A/B 和有效 MFU 解释主要收益与剩余瓶颈。
性能评估在业务常用的相近算力档位单卡上完成,后续结果统一按这一档位的单卡容量呈现。每个模型均针对实际部署环境独立构建节点产物,并选择对应的 kernel、精度策略和执行并发。混合精度 MFU 按部署 GPU 的 dense 理论峰值计算,BF16 和 FP8 峰值分别取约 150 TFLOPS 和 300 TFLOPS。
容量测试采用固定在途请求数的 closed-loop 方式。每个并发档位始终保持相同数量的完整请求正在等待或执行,一个请求完成后立即发送下一个,中间不加入客户端等待时间。QPS 统计每秒完成的完整 RPC 数量,端到端时延从请求发出持续到结果返回,P99 表示 99% 的请求不超过该时延。逐档增加并发可以得到单卡持续处理能力和时延开始快速增长的拐点。
单卡容量取同时满足平均端到端时延低于 20 ms、P99 低于 80 ms 的最高完成 QPS。服务入口再通过 deadline、超时退出和拒绝策略阻止过量请求继续占用后端资源。
执行链路一致性。在相同机器、相同输入和相同部署产物下,Python Artifact Runtime 与 C++ DAG Runtime 的输出 Tensor 保持逐字节一致。Server 使用同一 DAG Runtime 执行请求,协议层继续核对输出名称、类型、有效长度和最终业务结果。这一层验证用于确认节点调度、buffer 管理、数据搬运和协议转换没有改变部署产物的语义。
专用计算的数值验证。Packed GQA、shared-prefix attention、FP8 linear 和其他自定义 lowering 分别与 Torch 参考实现进行算子级和模型级数值对照。Beam Search 进一步逐 step 比较候选 Token、候选分数、parent index、累计分数、suffix K/V 重排和最终序列。
业务指标验收。低精度版本与原始离线模型使用相同的数据集、样本处理、评估代码和指标定义。优化实现不要求与原始 BF16 模型逐元素一致,但业务指标变化需要处于预先确定的验收范围内。最终部署产物通过了上述各层验证。

备注:【分层正确性验证】专用计算先与 Torch 参考实现进行数值对照;同一部署产物从 Python Artifact Runtime 到 C++ DAG Runtime 保持逐字节一致;低精度版本最终使用相同的离线评估流程完成业务指标验收。
下表给出三类代表负载在完整 RPC 链路上的单卡容量。三类模型的参数规模约为 0.5B 至 0.6B。每个 Prefill-Only 请求包含十余条样本,因此同时报告请求吞吐和样本吞吐;Beam Search 按一次完整搜索统计请求吞吐。

容量扫描表明,无约束峰值吞吐并不等于满足业务时延目标的容量。以短 prompt Beam Search 为例,在选定容量点上继续增加执行并发后,QPS 仅增加几个百分点,平均端到端时延却上升 30% 以上,并超过 20 ms 目标。
从并发曲线看,较低并发下增加请求上下文可以提高 CPU 处理、kernel launch、数据传输和 GPU 计算之间的执行重叠;进入饱和区间后,继续增加并发主要转化为排队、资源争用和单请求执行时间增长。线上配置因此选择满足时延约束的容量点,而不是无约束条件下的最高 QPS。
不同优化需要在对应层级进行 A/B,并最终回到完整请求确认收益。下表汇总 CPU 节点、AOTI 节点和完整 DAG 层级的主要结果。

分层 A/B 用于判断局部优化能否转化为完整请求收益,并确认优化后瓶颈所在的位置:
随着模型主体计算被压缩,profile 显示瓶颈逐步转移到 attention 状态布局、低精度转换、CPU 数据路径、同步和结果编码等环节,因此每次局部优化都需要回到完整请求时间线中复验。
为估算逻辑矩阵计算相对于硬件理论能力的占用程度,本文定义“混合精度有效 MFU”。该指标将每个请求中不同精度的逻辑矩阵 FLOPs 分别除以对应的 dense 理论峰值,再按照相同请求口径下的完成 QPS 汇总。
设每个请求中的 BF16 和 FP8 逻辑矩阵计算量分别为 F_BF16 和 F_FP8,对应硬件理论峰值分别为 P_BF16 和 P_FP8,则:
公式先估算每个请求中 BF16 与 FP8 逻辑矩阵计算在理论峰值下所需的等效时间,再乘以相同请求口径下的完成 QPS。Prefill-Only 的一个请求包含完整 batch,Beam Search 的一个请求包含一次完整搜索。结果表示单位 wall-clock 时间内完成的逻辑矩阵工作量相当于理论峰值算力的比例。
MFU 统计 linear、LM head 和 attention 的逻辑矩阵 FLOPs,FMA 按 2 FLOPs 计数。以下工作不进入分子:
代表结果如下:

计算使用对应部署 GPU 的 BF16/FP8 dense 理论峰值,取约 150/300 TFLOPS。
该指标用于判断后续优化方向。Prefill-Only 模型的有效 MFU 已较高,继续只优化 GEMM 的端到端边际收益将受到限制;短 prompt Beam Search 则需要继续关注 Top-K、搜索状态和短 shape 计算。
只要完整请求处理流程能够拆分为一组接口明确的节点,并由 DAG 表示节点之间的数据依赖,就可以接入本文所实现的这套推理框架。框架统一提供节点调度、Tensor 搬运、设备同步、资源预分配、请求上下文和并发管理,使新模型的开发与性能分析首先聚焦节点内部计算。
框架能力和专项优化具有不同的复用范围:
模型结构和节点接口不变的新 checkpoint 还可以复用大部分构建描述,再完成参数映射、数值、业务指标和端到端性能验证。静态 DAG 本身不限于有界生成负载,本文的专项节点与性能结论则面向 Prefill-Only 和固定深度 Beam Search。
本文的专项优化主要面向控制流和状态容量稳定、单次生成较短的 SLM 负载。对于以下场景,通用 LLM serving 系统所提供的动态能力与需求更直接匹配:
在这些场景中,vLLM、SGLang 等系统提供的 continuous batching、paged KV cache、prefix cache 和动态请求管理更匹配负载需求。当前部署采用单个请求不跨卡、每张 GPU 部署完整模型副本的方式。
搜索推荐中的部分 SLM 保留 Decoder-only Transformer 和 next-token prediction 结构,但在线执行只包含一次 prefill 或固定次数 decode。请求规模、Beam 宽度、生成深度和状态容量的上界均能在部署前确定,因此模型构建、资源规划和在线执行可以围绕完整业务请求重新组织。
系统使用静态 DAG 表示完整请求流程,以 CPU 自定义节点处理文本和结果,以 AOTI 节点封装模型计算与固定搜索过程。DAG Runtime 负责节点调度、Tensor 搬运和请求资源,节点内部则分别应用 Packed Prefill、shared-prefix K/V、选择性 FP8 以及候选与状态更新优化。这种分层将通用在线执行能力与模型专项优化解耦,也使正确性和性能能够逐层验证。
在本文覆盖的模型、输入分布和单卡环境中,Prefill-Only 达到约 100 request QPS,即约 1,500 sample/s;短 prompt 和长 prompt Beam Search 分别达到约 300 和 120 request QPS。三类负载的平均端到端时延均低于 20 ms,P99 约为 70 ms,满足 80 ms 的线上要求。相同部署产物从 Python Artifact Runtime 到 C++ DAG Runtime 保持逐字节一致,低精度路径与专用算子的业务指标变化也处于预设验收范围内。Prefill-Only 与短 prompt Beam Search 代表负载的混合精度有效 MFU 分别约为 67% 和 41%。
这组结果表明,推理系统的设计应由实际执行边界决定。对于有界生成负载,将固定结构前移到构建阶段、按完整请求组织在线执行,并把专项优化限制在接口明确的节点内部,可以提高计算效率和时延约束下的单卡容量。
美团在 MTGR 基础上提出统一推荐基座大模型 MTFM,首次实现外卖多个主要业务的统一精排模型。围绕规模可扩展性、场景可延展性与架构高效性三大挑战,MTFM以异构 Tokenizer 与动态掩码实现多场景特征免对齐,通过混合注意力与 Target Scale-Up 提升模型 Scaling 能力,借鉴 LLM 优化实践提升深层网络训练效果,并以 User-Level 训练范式与定制算子保证系统开销可控。美团外卖多个业务订单量提升 2.06%~6.68% 不等,推理成本降低 24%,相关工作已被 KDD 2026 收录。
我们去年提出了 MTGR[1] —— 一种新的生成式精排框架,在美团外卖推荐场景验证了 Scaling Law 的有效性,并取得显著业务收益。然而,推荐领域的 Scaling Law 探索往往局限于单场景内部,模型被限制在单场景孤岛中,跨场景的数据、算力和架构无法充分复用。在美团这一问题尤为突出,推荐覆盖外卖首页、拼好饭等多个业务场景,各场景长期独立建模。与此同时,大语言模型(LLM)已验证一条清晰路径:基座模型(Foundation Model)足以统一处理编程、数学、写作等多领域任务,也可以将文本、图像、语音等异构信息表示为 Token 序列并进行端到端学习,展现出了强泛化性与可扩展性。因此,我们认为美团推荐的下一个阶段关键在于打通跨场景的异构性,充分利用多场景数据提升 Scaling Law 的上限,即建设统一推荐基座大模型。
推荐基座大模型主要面临三个核心挑战:规模可扩展性(Scalability)、场景可延展性(Extensibility)和架构高效性(Efficiency)。规模可扩展性要求模型在参数规模、数据量扩大时,效果能够稳定、可预期地提升;场景可延展性要求模型能够低成本适配已有场景或接入新场景;架构高效性要求模型在处理多场景的海量数据时,训推仍保持可接受成本开销。
为解决上述挑战,我们在 MTGR 的基础上,提出美团统一推荐基座大模型 MTFM(Meituan Foundation Model for Recommendation)。MTFM 使用类 Transformer 骨干进行端到端建模,提出 Target Token Scale-Up 提升模型能力,借鉴 LLM 实践优化深层网络训练策略;通过异构 Tokenizer 替代固定特征模板,支持多场景异构特征免显式对齐;提出 Self-Attention 和 Target Attention 堆叠的混合架构,结合 User-Level 样本和 GPU 算子优化提升训推效率。
MTFM 首次实现外卖多个主要业务的统一精排模型并在各核心场景完成全量,相关工作于 2026 年 5 月被 KDD 2026 接收[2]。
多场景建模
核心目标是在共享跨业务用户兴趣表达的同时,兼顾不同业务间的分布差异与个性化需求。多场景建模主要沿着两条方向演进。第一类方法遵循“先同构、再解耦”的范式,通过将模型参数拆分为域共享与域特定部分。例如,STAR[3] 采用星型拓扑结构,将领域参数锚定在共享中心参数周围;M3OE[4] 进一步引入多个 MoE 模块,在通用、领域和任务层面学习层次化用户偏好;MLoRA[5] 则通过轻量化 LoRA 适配不同领域,提高参数效率。第二类方法开始探索多场景基座模型方向,通常采用“基座模型 + 专家模型”的架构,例如 ExFM[6] 将超大规模模型知识蒸馏到场景专家模型,LFM4Ads[7] 通过多粒度机制在特征与任务间迁移表示,这类方法非端到端建模、可能限制模型能力上限。
具备 Scaling 能力的排序模型
推荐模型 Scaling 范式主要沿着三条方向演进。第一类方法聚焦 DLRM 骨干扩容,通过扩展特定可堆叠模块实现扩展,例如 RankMixer[8]、TokenMixer-Large[9],通过 Token Mixing、Per-Token FFN 与 Sparse-MoE 增强特征交互能力。第二类方法将输入特征切分成独立 Token,采用 Transformer Backbone 进行端到端统一建模。具体而言, HSTU[10] 将推荐重新定义为序列转导任务,采用高性能架构捕获用户行为模式;MTGR 在此基础上引入交叉特征与双向注意力机制,以进一步丰富特征交互;OneTrans[11] 通过金字塔式的截断策略提升训推效率。第三类方法探索生成式自回归推荐,例如 OneRec[12],通过 NTP 将推荐改写为序列生成任务,尝试以统一生成框架替代传统“召回-排序”架构。
MTFM 的模型架构如图 1 所示,支持多场景统一建模,面向基座模型的三个核心属性进行创新改造:

MTFM 将多业务输入统一组织为三类 Token:H-Token、R-Token 与 T-Token。其中,H-Token 表示用户跨业务历史行为序列,包括商家统一序列与商品统一序列,用于建模用户长期兴趣;R-Token 表示用户近实时行为序列,包括点击、加购等行为,按行为时间戳统一排序;T-Token 表示待预估目标(商家、商品或券包),包含上下文特征、候选侧特征及交叉特征。其中,H-Token、R-Token 全业务共享,T-Token 各业务独立维护。
模型采用统一 Token 化范式:针对 H-Token、R-Token,不同序列使用序列独立 Tokenizer 完成编码;针对 T-Token,将上下文特征与候选侧特征进行拼接,再通过业务独立 Tokenizer 编码。最终,所有 H-Token、R-Token 与 T-Token 按顺序堆叠,形成统一的 Token 序列输入共享 Attention Backbone,在无需显式对齐跨业务特征体系的情况下,实现多场景统一建模。
为防止跨场景、时间的信息泄露,MTFM 进一步扩展 MTGR 的掩码策略。在下图 Mask 矩阵中,每一行代表当前 Token 在注意力计算时能看到序列中的哪些 Token,每一列代表当前 Token 能被哪些 Token 看到。对 H-Token、R-Token、T-Token 三类 Token,可见性如下:

MTGR 采用多层 Full Attention 进行全序列建模,其计算复杂度随序列长度呈平方增长。统一模型包含多条千级长度序列,直接堆叠 Full Attention 会导致训练与推理成本难以接受。另一方面,推荐任务的预估结果高度依赖 Target 侧特征,已有工作(如 STCA[13]、OneRec V2 [14]LazyDecoder)表明,Target Attention 能够以更低成本完成有效的信息提取。
基于此,MTFM V1 借鉴 LLM 中的混合 Attention 架构(Qwen3-Next[15]、MiMo-V2-Flash[16]),交错堆叠 Full Attention 与 Target Attention 层,以降低长序列建模复杂度。具体而言,Full Attention 层负责全序列信息聚合;Target Attention 层中,T-Token 仅以全序列 Token 为 Key/Value 执行注意力提取,不再参与全序列自注意力计算,从而显著降低计算量。在此基础上,进一步引入 GQA(Grouped-Query Attention),降低 Attention 的开销。
最终模型采用 Target:Full=3:1 的混合结构,共 16 层(4 个 Block,每个 Block 包含 1 层 Full Attention 与 3 层 Target Attention)。消融实验表明,该配置在各任务 GAUC 上均取得最优效果;同时由于显存占用下降,batch size 可扩大 1.7 倍,样本吞吐达到全 Full Attention 架构的 2.9 倍。


混合架构以更低成本取得了与全 Full Attention 相当的效果,说明将更多计算集中在 Target 侧是一条值得进一步扩展的方向。而在 MTFM 多场景长序列中,单个 Target Token 包含的特征数量,远多于单个 User Token 的特征数量,但是在 Token 化阶段 Target 和 User 侧都被视为同一维度的单个 Token,这会造成 Target 信息的过度压缩,在信息密度分配上是不合理的。因此在 MTFM V1 的混合架构基础上,MTFM V2(模型结构图见图 1)进一步对 Target Attention Layer 采用 Target Scale-Up 的方式来增大模型规模,以进一步实现 Scaling-Up。
具体方案:
1、Target Token Embedding 构造:采用 AutoSplit[17],每个 Target 的 User & Context & Item 特征经过一层 Linear 映射到 4 个 Token Embeddings。
2、Per-token Q Projection & FFN:在 Target Attention 层,每个 Target 的 4 个 Token 经过不同的 Q Projection Matrix 和 SwiGLU FFN。
3、Self-Attention & Target Attention 参数分离:位于同一层的 Self-Attention 和 Target Attention 有独立的 QKV Projection Matrix、 SwiGLU FFN 参数。
4、Target Token Mixing:拆分后的 Target Token 各自独立与用户序列进行 Cross Attention,经过独立的 FFN,如果不进行交叉,4 个 Target Token 在 Mean Pooling 前完全没有交互,会导致各 Token 在相同 KV 下趋向学到冗余相似的表征(表征坍缩)。因此采用 RankMixer[18] 中的 Mixing 模块,以零参数低计算量对 Target Token 进行交叉,促使各 Token 学习不同的表征。
为了实现多业务间的知识共享与差异建模,采用“共享基座 + 业务解耦”的多任务架构。具体而言,经过混合 Attention 聚合后的各业务 T-Token 表征,被送入 MMoE 层进行跨业务信息提取,再接入业务独立的任务塔,完成 CTR、CTCVR 等目标预估。其中,长序列兴趣建模能力主要沉淀在共享 Attention Backbone 中,而不同业务的分布差异则由 MMoE 门控与任务塔参数承担。
在训练与部署层面,MTFM 采用“一图多业务”的设计范式。训练阶段,以用户为粒度聚合同一用户当日全场景曝光 Target,并共享序列侧 Attention 计算,使多个业务能够复用同一份用户兴趣表征,大幅降低长序列训练成本。线上部署阶段,各业务导出图保留共享序列基座与独享 Task Tower,使在线计算限定在当前业务相关组件上,减少无效 FLOPs 消耗,在统一建模的同时控制推理成本,实现“统一训练、多业务部署”。
实验表明,跨场景的信息迁移可有效缓解数据稀疏问题。具体体现在小流量业务显著提升 0.60~0.93pp不等,中流量业务提升 0.25pp,大流量业务持平微正。

传统 DLRM 模型以曝光(PV)为粒度构建样本,多场景样本通过固定模板强制对齐,存在序列重复存储、计算的问题,资源利用率低。MTGR 将样本组织成单用户(UV)粒度,MTFM 进一步升级为外卖全业务的统一用户粒度样本,同一用户的外卖多业务曝光聚合成 1 条样本,共享模型中最耗费算力的长序列 Attention 部分计算。
MTFM 训练时按 User-Level 聚合样本、推理时按各业务 Request-Level 聚合候选,训练阶段算力复用经济性收益进一步放大。特征组织上,由于各业务的供给类型、展现形态不同,特征 Schema 无法直接对齐。相应地,各业务首先在内部按 User-Level 聚合业务独立特征,再与共享的用户序列以及其他业务的样本进行合并。模型训、推时多 Target 共享长序列计算,实现了算力资源的高效复用。
过往各业务独立维护场域内的行为序列,存在数据链路和 SideInfo 体系重复建设、跨场景行为信息缺失等问题,这一问题在数据稀疏的小流量业务中尤为严重。为此,MTFM 将全场景行为统一为商家、商品长序列,聚合外卖多场景的点击、加购、完单行为,构建覆盖质、价、品、情景化信息的通用 SideInfo。受益于 4.1 节的 User-Level 训练范式升级,整体资源消耗在可控范围内。各业务均使用全场景行为信号建模,提升了用户兴趣刻画的全面性,消融实验同步显示外卖多个业务均取得显著提升。

多业务联合训练叠加网络层数加深,使模型优化难度显著提升。项目初期发现多组随机重复实验的离线指标波动超过 0.4pp,严重影响迭代基准的置信度。通过监控中间层激活值、参数值、梯度值等指标,完善训练动态追踪,发现离线效果与部分层的梯度大小具有强相关性(图4,Run A、B、C为模型随机重复实验),基于此判断存在局部梯度衰减、参数退化的问题。为此从初始化、优化器两个方向系统性解决。另外针对多业务联合训练范式下样本稀疏引发的梯度噪声增大、无效梯度等问题,我们改进损失函数,完善优化器逻辑、并引入梯度累积。

深度感知的初始化策略:MTFM 的骨干网络是带有残差连接的多层 HSTU,残差结构使得网络输出的 std 随深度累积不断变大,训练初期存在激活值过大导致非线性激活层饱和的风险。借鉴 GPT-2 针对多层 Transformer 的初始化策略,在初始化 HSTU 每个 Block 的输出投影层时按深度缩放标准差:
其中 L = 16 为本次推全模型 HSTU 总层数,其他线性层的 std 仍设置为常数 0.02——使残差分支累积后的总方差保持在相对稳定的量级,改善深层模型训练初期的梯度稳定性。
优化器升级:将部分 Dense 参数由 AdamW 切换为 Muon — 一种主要面向二维矩阵参数、近年来在 LLM 领域得到广泛应用的优化器。Muon 使用 Newton-Schulz 迭代正交化更新梯度矩阵,以改善更新方向和训练效率。实践中借鉴了月之暗面的最新实践:增加 Weight Decay、Update RMS Scale,以提升训练的稳定性。我们针对 Muon 的覆盖范围进行探索,发现仅将 Muon 作用于 HSTU 的 UQKV 投影与 Output Projection,可以在速度与效果之间取得最佳平衡。
整体叠加两个优化策略,5~10 组随机实验的 train AUC 波动幅度从 0.4pp 降至 0.1pp,离线实验的稳定性和可复现性得到明显改善。
动态归一化:初期的联合损失采用各业务损失分别归一化后相加的形式:
其中 为 batch 内业务的样本集合。由于小流量业务的有效 batch size 小,基于其归一化损失得到的梯度存在较大噪声,既影响自身个性化参数(如 MMoE、任务塔)的收敛,也通过共享参数间接影响其他业务。为此将损失改为按 batch 内各业务 PV 占比动态加权,该形式可化简为等价的全局归一化——不区分业务、对 batch 内全部样本统一归一,修改后的 loss 形式如下:
稀疏更新改进:多业务联合建模的范式下,稀疏样本带来了一个新的问题:部分 batch 内不含小流量业务的 Target,其 Tokenizer、MMoE 专家与任务塔在该步没有梯度,但这些参数仍在被持续衰减。为此在优化器的计算逻辑中跳过零梯度 Weight Decay,并将零梯度检测合并为单次批量同步、非零参数更新批量向量化以减少 kernel launch 次数提升训练吞吐。此外,为提升小业务的训练稳定性,引入步长为2的梯度累积,降低优化器 step 频率提升训练速度。
MTFM 的单样本计算量较 DLRM 模型增长数百倍,系统性的性能优化是基座大模型成功落地的前提。为此,从训练、推理两部分,解决模型计算量和存储量激增带来的诸多性能挑战。
MTFM 在网络层数、Token Dim、序列长度三个维度上表现出了稳健的 Scaling 能力(图5~7):


MTFM 统一模型离线 GAUC 全面超越各场景基线,并且在 Target Token Scale-Up 上展现了更好的扩展效果。

目前,MTFM V1 在美团外卖多个业务完成全量,核心订单指标提升显著,在线效果最显著的业务线订单增长超过6%,同时这也是最近两年多个核心业务推荐场景单次优化的最大收益。
MTFM 是一个真正意义上实现多场景特征免对齐的推荐基座大模型架构,具备规模可扩展性(Scalability)、场景可延展性(Extensibility)和架构高效性(Efficiency)这三个关键特质。具体以类 Transformer 骨干网络为基础,通过 Target Token Scale-Up 提升模型能力,借鉴 LLM 优化实践提升训练效果;设计异构 Tokenizer 和动态掩码机制支持多场景端到端统一建模;通过混合注意力、多场景 User-Level 训练、高效 GPU 定制算子等提升训推效率。首次实现外卖多场景统一精排模型,取得显著的离线 GAUC 与在线 A/B 效果提升,展现了良好的规模效应与算力经济性。在未来,我们将和各团队紧密合作,充分吸纳 LLM 与推荐领域业界最新进展,不断提升模型能力和 Infra 能力,继续拓展基座模型在推荐场景的能力边界。主要方向如下:


