
2026-11-09 17:00:00
目前只做工程方面的总结,不做策略数据方面的复盘。这个项目是从一个小的页面开始,逐步发展形成了一套复杂的数据看板。在这个过程中踩了一些有意思的坑,这些坑都不高级,属于一看就知道很简单的问题,但为什么会遇到这么多低级问题呢?因为用了 AI。真正的关键不在于让 AI 写代码,而在于 AI 比较死板,标准比较生硬和严格,尤其是在这次做资金费率套利机会的数据看板中,这种现象体现的更加明显。所以这也是 AI 能力边界的一个体现。AI 是不是比程序员厉害?是。AI 能不能代替程序员?分情况。
一开始只是做了一个简单的资金费率排行榜单,把 Hyperliquid 上的全部美股,按照实时资金费率做了个排行。是一个纯前端页面,到现在都能访问:https://hyper.dark20.xyz/ 。页面上提供了回测资金费率的功能,直接回测榜单前几名,在不同周期内的资金费率情况。关注到美股的资金费率套利,很大一部分原因是今年的美股上链很火,RWA 等概念逐渐正规化,似乎给链上带来了新的活力。
再后来开始往页面上加资金费率套利回测的数据和功能。与之前的区别在于,真正的套利需要开两腿交易,只回测资金费率还不够,需要结合现货价格,把开关仓的成本给算上。当然到这一步的时候,整体回测下来的收益并不高,普遍在 10%~ 20% 的范围。这个收益还不够有吸引力,毕竟资金费率套利是广为人知的策略了。同时在做的是具体的 Hyperliquid Price Spreads 观察,实时检测现货价格和期货价格之间的差异,这个会影响到开关仓的成本估算。
接着从 Hyperliquid 横向扩展到了更多平台,Binance、Bitget、Lighter、DYDX 等,此时也新增了一种策略,就是跨交易所的资金费率套利。与现货+期货的套利策略相比,跨交易所得套利策略收益要高出很多倍,并且当时做了几个回测页面,比如指定同一个代币在不同平台上的费率差距情况、或者同一个平台上不同代币的费率情况等。直到最终觉得可以合并了,干脆就不同平台的全部代币直接交叉,在同一个页面上展示一个表格出来。当时还花了几天时间研究资金费率的 APR 到底应该怎么算等问题,有哪些关键数据、滑点这么考虑等。重
这些都是前置条件,不展开描述。只是在解释经过了这样一些调研的过程,最终确定了想要的网页形态,就是一个跨平台+多币种交叉的榜单。
所以在一开始,页面榜单的数据,都是纯前端加载的。打开页面之后页面实时请求多个平台的全部代币数据,然后计算这些代币在不同费率下的收益情况,最终得到一个排行榜。当然最明显的问题就是,从打开页面到能看到结果,需要长达几分钟的时间,这样使用体验太不好了。
然后改成了手动触发计算任务的方式。打开页面,设定好想要的参数,包括哪些平台、哪些代币,点击计算,会向后端发送一个任务请求,后端持续请求各平台数据、汇总结果并且返回。在计算任务期间就可以离开页面了,请求任务也会按照时期或者任务的 ID 记录到用户的操作记录中,这样用户随时可以查看到以前的任务运行状况,以及最新的计算结果。要强调的是,这一切都运行在一个 1 CPU 2GB Memory 的 AWS 服务器上。
后来因为服务器上的资源竞争,就把这个排行榜程序独立出去,放到了一个 2 CPU 4GB Memory 的 Vultr 服务器上,用的 Cloud Compute 型号(属于廉价低性能款,20u/m)。迁移的同时干脆做了后端程序的重构,从 Nodejs 切换为 Rust 语言。以及从原来的手动触发计算,大幅调整架构,改为滚动采集全部数据+定时发布排行榜快照的方式。
自动采集数据自然是好的,同时采集数据失败也经常发生,举几个典型的例子:
请求 Bitget 接口的时候,多了一个 ?,比如原本计划请求 /api/v3/account/info,但实际构造出来了 /api/v3/account/info?,导致 Bitget 的接口认为传了一个空的字符串作为参数过去,就返回 Failed to fetch。
请求 Kucoin 资金费率接口,会得到 {"code": "200000", "data": null} 这样的响应,当时程序认为 data 是 null 所以报了异常,实际上是 Kucoin 的接口分页结束了就回返回 null。
类似的接口兼容类问题很多,不需要一一列举。这些算是意料之中的问题,采集那么多平台的数据,肯定要做好接口兼容。当时支持的平台一共有这些:Binance、Bitget、Bybit、OKX、Gate、KuCoin、MEXC、HTX、Kraken、Coinbase、Deribit、Hyperliquid、Lighter、dYdX、Aster、Polymarket、Kalshi。
紧接着问题就出现了,采集数据的进度迟迟不推进。当时使用后端采集任务的数量来评估,比如请求 Binance 的 BTC 在 10月01日 14:00 的资金费率是一个采集任务(一个请求),请求同时间段的价格数据是另一个请求;这样堆积起来,十几个平台 * 一千多个代币 * 不同数据维度,最多堆积到了 15 万个采集任务。这样的数量显然是异常的。
优化方式也很简单,大多数平台的请求都可以合并,比如一次性请求 300 个代币在一天内的资金费率数据,这样一个请求直接合并上万个采集任务。需要进行这种优化的有五六个平台,当全部优化之后,任务数量就降低到了一两万个。
在数据采集有压力的情况下,有几个新的需求:
具体的门槛后来有调整,整体上没差太多。按照这个门槛,需要采集大量历史数据的代币有 100 个左右。同时期,采集任务的积压已经很严重,因为每时每刻都在产生新的采集任务,每过一小时,每个平台都会产生新的资金费率数据,采集任务的数量不降反增。为了缓解 CPU 压力,把服务器升级到了 4 CPU 8GB Memory 的规格(40u/m)。
同时也采用了一个优化手段,给代币数据的采集和快照的发布划分优先级。在用户收藏列表里的代币最高优先级采集全部数据、单独发布每个代币的快照信息。超过设定流动性门槛的代币,第二优先级采集数据、优先发布快照榜单。最后优先级的是其他的大众代币。不过优化的效果不够理想。
为了缓解数据压力、增加出榜单数据的范围,降低了几个数据的要求:
其实这个身份验证给我带来很多麻烦,这个标准是一开始 AI 自己加的,后来数次给很多其他功能带来阻碍。身份验证的意思是,比如在 Binance 看到了叫 CAT 的代币,并且在 Bitget 看到了叫 CAT 的代币,程序要求从两个平台的接口能够直接返回代币的合约地址并且合约地址能对得上,就认为这两个代币的身份是经过验证的、能够安心配对做套利计算的。这个逻辑和要求本身没什么问题,只是由于很多平台不返回合约信息,尤其是很多代币化股票需要传递不同参数的复杂性,导致能通过验证的代币其实不多,榜单上大量缺失正常数据。所以后来尽可能去掉了这层验证。
这个也非常好理解,比如最新数据只采集到 4 个小时前,那么出榜单的时候是忽略这个代币、还是同步采集完最新的数据、还是直接用 4 个小时前的数据做计算?原本的做法是会同步采集最新数据,但是服务器资源不允许,这样不但会拖慢整个榜单产生的速度,还会增加额外的采集压力。于是后来直接降低要求,只要 12 个小时内有数据就直接按照最新数据计算。榜单的数据成功率就高了不少。
这也是一个非常大的坑,很大程度阻碍了采集数据的进度。首先注意到这个问题,是发现 Bitget 对于某些代币,原本想要采集一天的小时级别的 K 线数据,但是实际上接口就是只返回 4 根 K 线。而按照当时的程序设计,程序把一天按照每个小时划分为 24 段,比如 K 线数据,会要求数据库里每个小时都有 K 线数据才算是完整覆盖,而且没数据的地方会反复采集,进度阻塞停止不前。而后全面改成了请求成功率的口径,只要请求成功且不是异常请求,就认为这个时间段内的数据已经覆盖。就这样看起来非常简单的改动,却极大推进了整个系统的采集进度。这个问题够低级吧?AI 是不会主动发现这种问题的,得你告诉他怎么改!
对于套利项目来说,我们肯定不会优先关心那些 APR 最低的代币,是吧?哪怕它只是现在这一刻低,也会意味着如果开仓这个代币,它现在的回撤会非常大,这也不是我们想要面对的风险。所以全部平台的代币有 8000 多个,其中能配对的有 1000 多个,这一千个左右的代币会最轻量级的采集实时资金费率数据,排序后选出 spread 最高的 300 个代币,然后再进一步采集 7d 的资金费率历史、30d 价格历史等数据。在这样的榜单口径下,后端一下子减少了 2/3 的压力,后端的数据逐渐就跟上了。
这也是事先没能料到的,为了观察后端整体数据的采集进度,当时是有一个页面分门别类展示每个平台各类数据的采集进度的。没想到这个请求每次都在扫描全表、还会有一个后台程序不断扫描,就为了在页面上展示一下采集进度。把这个东西删掉后 CPU 一下子释放了 20%。
数据的采集进度跟上以后,紧接着面临的问题有三个:
这几个问题看似属于不同阶段的问题,其实有很多混杂的地方,可以同步优化。当时发现并做了几个代码逻辑方面的调整:
以前把整个榜单的快照数据都放到一个 JSONB 里,程序每次都需要把超过 100M 的数据从数据库里读出来、反序列化解析到数据结构、然后计算、返回给页面(哪怕带缓存),其中光是 json 的反序列化就耗时 5 秒以上。虽然 Rust 里已经用了 Arc.clone 共享同一份内存,但是如果把数据写进 json 再读出来,就是一份新的内存,而程序里存在大量这种反复读取、反复序列化的问题,导致大量的重复计算。我不能断言这个和 Rust 语言有关,只是 Rust 语言的理念就是尽快释放内存,或者说用完就必须释放内存,导致程序里默认存很多这种用完释放然后反复序列化的逻辑。
再一个问题是即使内存里共享了内存,序列化到 json 里,json 里保存了多份数据。这也很好理解,哪怕是同样的数据,不同的程序也没有复用,而是自己单独存了一份,导致 json 的数据体积成倍增加。还有的问题比如 json 里每个快照都保存了完整的全部历史 K 线数据,可以精简。总之在经过优化后,无论是发布快照还是预热、重计算的缓解,json 的体积都降低了至少 1/3,减少到 20M 左右。不过减少体积还不够,后来又进一步把 json 里的关键字段拆开放到数据表上,进一步加快数据读取的速度。
很基础的逻辑,以前每个榜单都是一个单独的快照和数据,可以把每一种类型的数据结果都成块存下来,下次发布快照的时候直接复用上一个快照的增量数据。比如要看 7d 榜单,现在过了一个小时,只需要把最一开始的 1 小时数据拿掉、再把最新的一小时数据放进去,就可以得到最新的 7d 快照。而不再需要每个 7d 榜单都会滚动产生一份快照数据。
而且这样的数据拆分和共享,可以同时使用到快照、预热、重计算三个环节。最终的结果是,页面访问的时候,没有缓存的冷计算大概在 25 秒左右,显然好于原本的 60秒。但是仍然不够理想。当时的统计信息是,300 个代币一共有 27000 种组合,处理每种组合需要 0.6 毫秒,单看 0.6 毫秒不多,27000 个组合一累加就是 25 秒。此时服务器的 CPU 已经常规持续在 90% 以上了。
正当代码逻辑和数据共享层面的优化都已经很难有明显增益的时候,同时新的需求还在增加,要加上模拟盘等其他功能,感觉这个服务器长期下去不够用,因为 CPU 已经接近满载了。首先考虑的是能不能用另一个 4 CPU 8G Memory 的服务器分担压力,但是怎么分担是个问题,我一直想用 Redis 但是 AI 反复告诉我 Redis 没用,解决不了这个 CPU 频繁换页的问题,也解决不了内存不够的问题,Redis 做不到用磁盘换内存。可以考虑的方案是让另一台服务器直连这台服务器的数据库、把预热的 worker 给分散出去。
然后我就看 Vultr 有没有其他高规格的服务器,要是开一个 8 CPU 16G Memory 的服务器把两台服务器合并在一起会不会更好?但是 Vultr 的服务器又贵,80u/m 只能开到 6 CPU 16G Memory 的机器,如果是 vhp(高性能款)则需要 100u。同时我还在搜寻有没有性价比更高的服务器提供商。
性价比高的 VPS 自然是有的,最终直接用了 Hetnzer。虽然我早就知道 Hetnzer,据说有一半的以太坊节点都泡在 Hetnzer 上。在 Hetnzer Cloud 的常规性能机型里,我开了 CPX32 型号的机器,4 CPU 8G Memory。同样是 42u/m 的价格,结果一测试,CPU 性能比 Vultr 的那台机器高出三倍。我折腾了两个小时,把全部服务都迁移了过去。
迁移完之后进一步测试,排行榜打开的速度比原本快了 3 倍!就在当天上午,我实际测试打开网页、切换各种参数的速度,时长在 5s~ 20s 之间波动。昨天下午换了服务器再测试一遍,同样的页面路径(当然是 AI 给我测的),加载数据的时长降低到了 1s~ 5s,最长也就 5 秒钟,这已经完全是一个正常使用能够接受的速度了。
我之前从来没觉得服务器是个问题,也没觉得我应该去折腾服务器,总觉得服务器环境属于非常基础也没有技术含量的事情,而我长期作为开发人员,也不太关心服务器这回事。直到这次直观体会到了服务器之间的差异。当软件层面已经很难有显著提升的时候,直接升级硬件也是个有效的手段!
另外,Vultr 倒是也提供了 vhp 机型,从网上的测评来看,vhp 的 CPU 能力似乎和 CPX 差不太多,是同一个级别的,也没有很贵,只需要 48u/m。不过我不再需要 Vultr 了,因为我在 Hetzner 的 Dedicated 服务器里,买到了性价比最高的 AX41,只需要 70u/m 的价格,6 CPU 64 GB Memory + 2x 512 SSD。尽管这个 6 核的 CPU 是老款芯片,据说和云服务器上的 CPX32 也差不了太多,但是 64 GB 的内存,这以前在 AWS 上是不敢想的宽裕配置。
你应该看到了,这都是一些简单的技术问题,AI 有能力把每一个具体的技术问题解决好,但还不具备整体布局的能力,软件的演进,依然需要遵守软件工程的客观规律。这也是以后软件开发仍然需要工程师的原因。
2026-10-28 18:34:16
由于行业的特殊性质,我已经远程工作超过 3 年时间,期间至少换过 3 次工作,而每一次的新工作也都是远程形式。很多人觉得远程工作是一种 “福利”、“好处”,想尽办法想找远程工作,我实在不理解他们。
当然今天要说的是另外一件事情,3 年前我写《如何健康地远程工作》的时候,完全没能考虑到这一点,也可能当时有考虑到,但是受限于工作内容以及公司的制度,没办法考虑太多。而结合我最近一段时间的体会,我觉得今年得到的一个很有价值的、在生活和工作习惯方面的结论,就是:
远程工作不要居家。
先说起因。在做 预测市场项目 期间,我几乎不外出,连续几个月在家里工作,因为很忙。每天都有一大堆需求要改。面对这种大量的工作,以及团队里有很多成员需要沟通,就导致觉得在哪里工作都一样,不但要在线,而且有任务需要完成,不要以为 AI 可以自动完成工作,或者 AI 可以托管完成工作,最终的结果还是需要人来验收的。那一阵子确实很忙。
后来,预测市场项目宣告失败,开始转做其他的方向,团队成员也有减少。我的工作重心开始转向另外一些事情。也就是在此期间,我的心态开始变得异常糟糕,我不知道原因是什么,只能感受到在严重恶化。也许是工作原因,也许是生活原因,也许是负债原因,不知道。每天一回到出租屋,哪怕是出门散步后回来,都会感觉到巨大的负面情绪,大概就是 “生活不会变好了”、“以后只能这样了” 这一类。
为了缓解这个问题,我尝试了一些办法。9 月份,我第一次从北京到了天津武清,半个小时高铁过去,什么也没干,就在武清的佛罗伦萨小镇闲逛一会儿,然后在高铁站附近的酒店住一晚。佛罗伦萨小镇是一个新鲜的地方,说起来就是个大号的蓝色港湾(室外商场),但是蓝色港湾我去过太多次了,而佛罗伦萨小镇是第一次来,看到新鲜的环境、布景、人流,暂时忘掉了所有不开心的事情。尽管回到酒店之后还需要继续工作。
10 月份国庆节前后,我前后多次就近去了几个地方,承德、滨海、廊坊、济南等。因为需要工作,所以不能走太远,大多数是高铁 1 小时内能到的,也不会刻意去景点,毕竟景点一般不会在高铁站附近。对我来说,只有两个改变是新鲜的:在高铁站附近散步;在新的酒店环境里工作。即使只是这样,我都能感受到,在出行的时间里,是会自动忘记不开心事情的。一旦回到出租屋后一两天,原本焦虑的东西又会回来。
这很有意思,另外一个小的感受是,当时我在房间里觉得无聊,准备出行到另一个地方,在高铁站候车的时间里,拿出电脑做一些工作,身边人来人往、熙熙攘攘,我都感觉有一些不一样的心情。哪怕是在高铁站里,身边流动的人群让我感觉到了一种世界还在运转的证据。再加上后来散步环境的改变、工作环境的改变,心情就是会不一样。那么这种新鲜感到底是因为去了新的地理位置,还是因为换了不同的工作环境?
所以再后来的一次尝试是,不离开北京,随便找一个地铁站、找个酒店住一晚试试。结果上了地铁才发现 6 号线物资学院站往后的站点附近,几乎都没有酒店,毕竟太偏远、太远离城区了。为数不多的酒店又很贵,最便宜的也要 ¥200 多。三星级以上的酒店价格在 ¥300 以上。北京的消费确实高,在天津三星级酒店的价格才 ¥150 左右。所以干脆下了地铁随便走走,无意间到了一个偏远的公园,可以散步,休息的时候坐在椅子上拿出电脑还可以工作。出乎意料的,我没有离开北京,也不需要去一个酒店住,就能感受到不一样的新鲜感和心情。
最后得到的方案是,去图书馆工作。
去哪里不重要,重要的是要离开房间。对我来说,北京城市图书馆就是一个很好的选择。北京城市图书馆很新、很大、很气派,在通州,离城区比较远,离我家不太远。比国家图书馆还要大,而且人流量不大,工作日只有 1000 人左右,有空调和舒适的温度、有空座位,每个桌子上都有插座,有 Wifi,有矿泉水的自动贩卖机,有干净的洗手间,等等。而且北京城市图书馆同时也是博物馆,装修风格就是博物馆的风格,算是 “国家级” 的投入和审美,桌椅都美观且干净。最重要的是,这一切都免费。花几百块钱去酒店住一晚,还不如在这里呆一天。
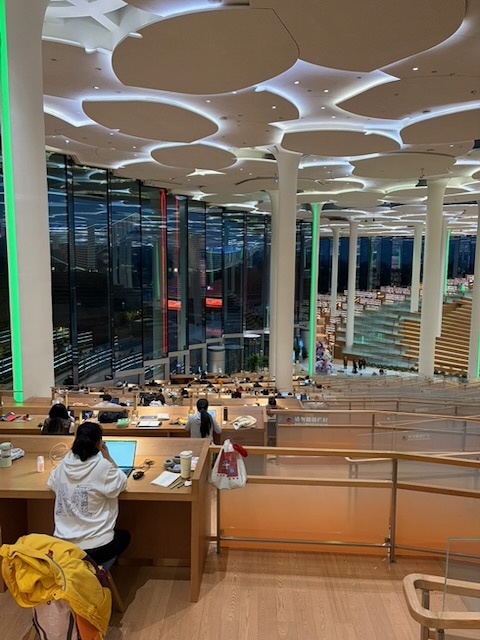
北京城市图书馆不是唯一的选择,首都图书馆、国家图书馆都可以,一线城市也就公共资源比较丰富。这种环境比星巴克好很多,需要花钱买咖啡还是其次,主要是桌子小、空间小,比较挤、嘈杂、还没地方活动;图书馆则是默认静音,有种回到大学自习室和大学图书馆的感觉。很多人都是在看书或者看什么资料,像是在备考。就像坐班工作一样,如果把图书馆当公司的工位,岂不是很有意思。
这只是一件微不足道的小事,也仅仅只是我的个人处境和体验。但是在这件小事上我感受到的东西,却有一些,因为目前得到的结论,能够直接推翻我们从小接受的教育,或者说从小被洗脑的一些鸡汤观念。
我们从小听到的糟粕是:
而事实上我的结论是:
这只是一件非常个人的小事,但是这个道理背后,却需要付出很多真实的代价来获得。我们经常能在网络上随便看到很多道理,看过去也就看过去了。包括从一开始 AI 就在分析我的状态、给我建议。但是如果不实际体会到这样的过程,很难切身理解 “物理环境会影响人的心情” 是什么意思。可能会想,不都是工作吗,不都需要做一些事情吗,家里面有舒适的椅子,想躺下就能躺下,到外面又得赶路又得找座位,干嘛要出去呢?
“每只青蛙都有属于自己的井”,是我最近看到很有道理的一句话。哪怕半年以前,我甚至都不知道通利福尼亚(通州)这个地方,无意间在小红书刷到,发现原来只有几站地铁的距离,后来就经常往千荷泻露桥跑了。是啊,在一个地方住了两年,都不知道两站地铁之外的通州区的景象。
还有就是 “物理环境会塑造生活习惯” 这件事情,也非常明显。如果整天呆在家里,会觉得无聊,然后时不时点个外卖,用高甜或者高辣食物来给自己一些刺激,顺带着也会变胖起来。而如果离开了家,比如一天都在图书馆,因为会受到物理环境的约束,在图书馆不方便点外卖,而且也不方便吃东西,自然就不会去做这些事情了,结果就是饮食习惯可以改善、生活习惯也可以改善。家里舒适的环境,反而成了坏习惯的帮手。
总之,不知道你信了没有,远程工作不要居家。
2026-08-09 23:14:31
我会总结分析一下最近半年来,我们团队做项目遇到的种种困难。总的来说,现在项目仍然没有找到 PMF、没有达到用户自增长的状态。与以前的项目经历不同,我可以毫不掩饰地说这个项目的官网是:http://virae.ai/
在这个项目上,团队一直在以最少的人员配置 + 最低的硬件成本去做。这种低成本主要也是为了试错。至少我是这么理解的。
一开始想要切入预测市场、做一个预测市场生态上的项目时,我们就看到了一个新闻,一个叫 Polycule 的 TG Bot 项目,算是 Polymarket 生态比较头部和知名的一个项目,因为服务器被黑客攻击、一度损失资金甚至传闻跑路,目前也已经改名换姓、整个产品换了方向。
当时忌惮这种托管私钥方面的安全问题,团队对于项目的约束是,不要做这种托管私钥类型的交易工具。
那么不做交易工具做什么呢?主要在这几个方向上徘徊:
另外还有一个团队自己发掘出来的方向:预测市场事件的语义搜索。因为无论是从 news 文本-> 提醒,还是从链上数据-> 提醒,都绕不开一个关键环节:怎么精确找到自己想找的事件?我看到一个特朗普的新闻,但是并不知道与这条新闻相关的预测市场事件是哪个、去哪里下注。
然后我告诉你为什么这几个方向没做起来:
我一开始提到我们在硬件投入上也是维持在低成本模式。有多低呢,现在整个 Virae 的后端服务器,一共用了 3 vCPU、6 GB 内存,100 GB 数据,在 AWS 上。
我并不是说这样的配置不够用,而是在这样的成本约束下,自建节点、自建 SubGraph 一类的服务自然是做不了的。举个直观的对比,运行一个以太坊节点的配置,是 8 vCPU、32 GB 内存、1 TB 磁盘、且要 IOPS 大于 10k 的固态硬盘。
这是在可以做交易工具之后、首先比较看好的方向,比如用户需要在 NBA 相关赛事下注,需要同时打开 NBA 比赛以及 Polymarket 的事件下注页面。我们能不能做一个交易终端,同时展示体育赛事的信息、以及聚合 Polymarket 的下注交易能力?
这个方向上有明确的竞品,包括 Crypto 领域的 GMGN、Axiom,预测市场领域的 Betmoar、Areas、stand.trade。
结果就是没有人用。
至于为什么没有人用,是我们一直都在反思但是不知道答案的问题。
顺便提一下,所有在 Polymarket 生态的项目,都在 Polymarket 的 Builder 榜单上。Polymarket 官方提供的榜单只有交易量总额,没有更多信息。因此我做了一个辅助网站 https://poly.dark20.xyz/ ,这些数据都是从 Polymarket 官方的公开接口拿到的,列出了每一个项目方的交易额、交易人数、甚至具体的每一笔交易的详情。由于交易接口方面的约束,同赛道的项目方一定都在这个榜单上,反之,不在这个榜单上的项目方一定不是 Polymarket 生态的项目。
在 Crypto 领域有很多 TG Bot,提供 snipe 代币的功能,或者很简便的贴一个代币的 CA 地址就可以开始交易。那么在预测市场是否需要一种 copy trading bot 来一键复制别人的交易行为呢?
比较头部的竞品很多,做的也都不错,除了之前提到的 Polycule、还有 PolyCop、Kreo、PolyBot 等。
结果也是没有人用。
至于为什么没有人用,能找到一些原因:
世界杯期间,项目准备了一些预算做活动,交易就给钱那种,来了不少来自印度的撸毛用户。当时有一个发现,大多数用户都是在手机上操作,要么在手机浏览器里打开网页,要么在 TG bot 里操作。很少有用电脑直接操作。
这一点和我们的预期有很大偏差,因为一直以来,都是在做专业的交易终端,而交易终端一定是电脑网页,也因此几乎没有刻意做什么移动端的适配。
再后来,又关注到一个用户数量很多的项目 polymtrade,是一个手机 App,在苹果商店能搜到那种。这个项目页面非常简陋、而且不支持高频交易,但是月活跃交易用户在1000以上、交易额在百万美元以上。我调查过,这个项目没有融资背景、只有 3 个开发者。
所以我们后来一方面优化移动端网页、另一方面适配了 TG Mini App,希望用户可以直接在 TG 上面打开 Mini App、就能拥有完整的体验。
结果也是依然没有人用。
高频交易就是给专业交易员操作用的,比如现在下单后、看 K 线、发现几秒钟的动量、马上操作卖出,或者同时挂很多订单、止盈止损、频繁操作。这种就要求界面操作要流畅、下单速度要快、交易反馈要准确。与之相应的,技术难度高。
低频交易是指那些佛系散户,比如今天看到什么新闻、想去某个事件上下一单、明天想起来就又下一单、下单之后也不看 K 线也不看流动性、甚至不操作不卖出,就纯粹等半年后的结算。
这两种交易频率的不同,也是产品方向上的分歧。高频交易注定使用者专业、数量少、交易量大。低频交易也许用户量多、但是交易量会很少。
有研究报告指出,整个 Polymarket 有80%的散户交易总额在100美元以下。而且这是整个 Polymarket 生态的,其中 Polymarket 官网的交易人数和交易量占了90%左右,留给第三方项目方的交易量只有10%。(研究报告原文找不到了,大概是这个数字,你不相信的话可以让 AI 重新调研一次。)
这个数据如果靠谱的话,那么 Polymarket 生态的项目会过得比较惨。看起来预测市场的交易量和收入年年新高,但是跟第三方项目方有什么关系呢?
随着项目功能越做越多,后来逐渐发现一个误区:再做一个官网。
当时正是世界杯,Polymarket 和 Kalshi 都出了 combo 交易的功能,我们就在看能不能从接口接入这种 combo 交易的能力。后来发现官方提供的 API 不支持。
这就导致一个尴尬的现象:专业的交易终端本应该是功能增强版本的 Polymarket,结果 Polymarket 出了新功能、第三方交易终端跟不上!
这也突然带来一个警醒:Polymarket 是中心化平台、不是去中心化协议!
CLOB v1 版本的时候也许还能看到一点去中心化的影子,自从 CLOB v2 之后,就实锤 Polymarket 是中心化平台了,毫无疑问。
也因此后来 Polymarket 出了 perps 交易的功能,我们根本不去看能不能接入了。接入了也没人用。
再后来,Kalshi 还出了官网版本的交易终端 Kalshi Pro,杀死比赛。
总之再做一个官网绝对是行不通的方向。
后来看 Agentic Trading 的方向比较火,很多交易所相继出了这方面的功能,我们也开始往自动交易、代理交易方向转型。转型的结果就是,目前平台上支持 BTC/ETH 的 15m/1h 市场的尾盘策略,可以配置参数一键启动。这个方向上目前看到最直接的竞品是 EVPLUS。
这里有一个考量在于,是做执行工具还是做策略?执行工具就是用户自己设定策略参数、我们只管执行;做策略就是我们找到稳健的策略或者策略参数、推荐给用户运行。对于用户来说,肯定是希望直接给策略,而对于项目方来说,因为考虑到策略风险,只能是做工具比较稳妥。
并且我诚实的告诉你,我们的项目也没有 edge;不但我们的项目没有,而且我可以负责任的告诉你,我们的竞品 EVPLUS 也没有,因为它的策略源码是公开的。
然后为了推广现在的这个 Auto Trade 功能,还开发了针对 Auto Trade 的 Paper Trading 账户和排行榜,希望做一场活动、让用户免费参与、最终 PNL 高的用户可以获得 100 USD 的奖励、培养用户习惯。
原本计划明天周一开始这个模拟盘交易大赛活动的,后来一个团队外部的成员,以命令式的语气、在没有经过团队讨论的情况下、就直接告诉运营人员推迟这个模拟盘交易大赛的活动。也因此我现在甚至不知道这个活动还搞不搞、什么时候开始。(你会不会没看懂,什么叫团队外的 “成员”?)
事实证明经过了预测市场的大热点世界杯,我们在预测市场辅助工具这个方向上没有做起来。后来又开始考虑做更多领域的集成,比如前段时间看 Robinhood Chain 比较火,就集成了 Robinhood 的 Memecoins 交易。
再后来又看到 Robinhood Chain 上有一个叫 SLVR 的链上游戏很火、交易量很高,我就直接把他们公开的合约源码拿下来、自己开发前后端、直接出了一个类似的仿盘出来 VORE(只是演示,千万不要玩)。这个 VORE 是为了证明我们能做出和 SLVR 一样的链上游戏。同时也在考虑 SLVR 这种游戏的玩法有没有什么 Virae 能够借鉴的。
总之就是这个阶段已经不局限于预测市场,而是开始打 Memecoins 或者其他链上热点项目的主意了。
为什么我现在可以做这样一个总结呢,因为你能看到,我们尝试了各种各样的产品方向,结果都不太尽人意。我作为开发者的角度,已经没有灵感下一步还能做什么了。因为很明显,不管做什么新功能,都不会有更多人来用,这已经不是开发层面的问题。
我其实之前反复跟团队说一个道理,如果 100 个用户进来了、用着不好用、功能有 bug、走了,那是产品或者开发的问题,我们就可以去优化产品、修复 bug、提高用户留存率。但事实上是,根本没有 100 个用户进来,连来都没有来。所以问题在哪里?
2026-08-03 00:32:47
今天有一个 “重大” 发现想要分享:PySonar2 可以大幅度降低 AI 在执行 Python 项目修改的时候的 Token 消耗。
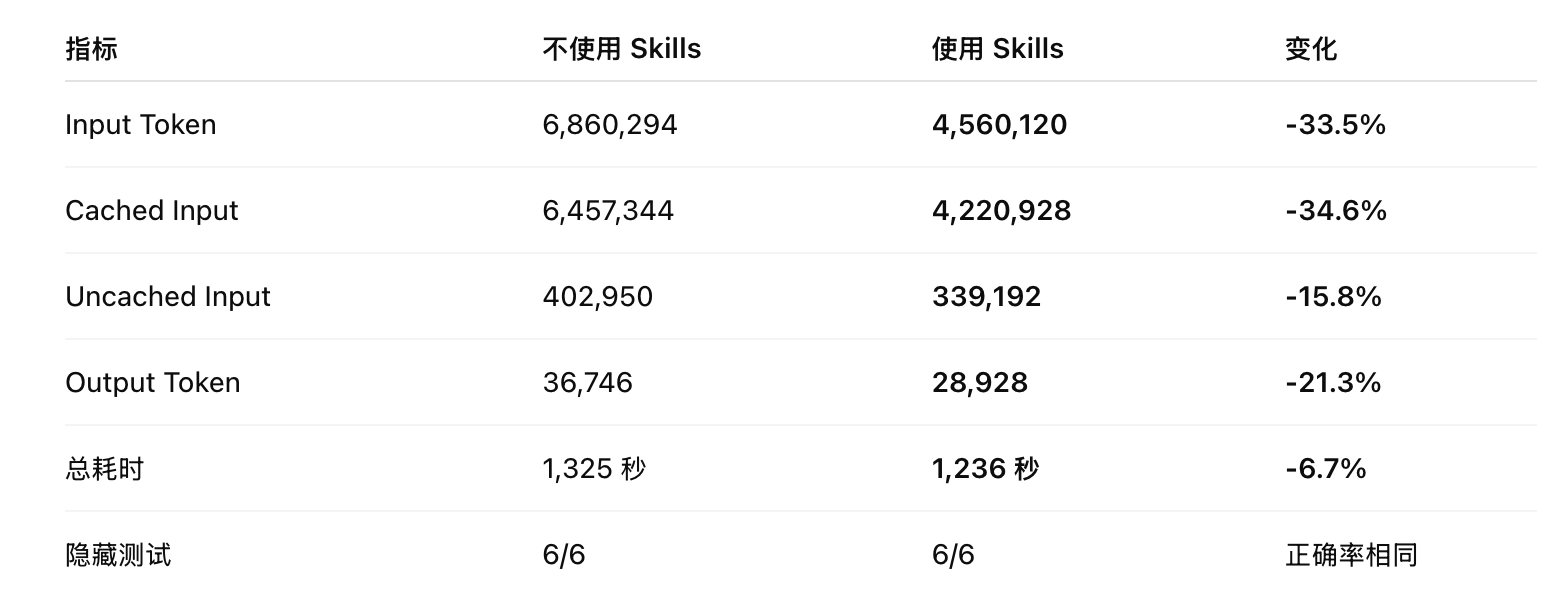
这是 ChatGPT 运行出来的 benchmark 结果:
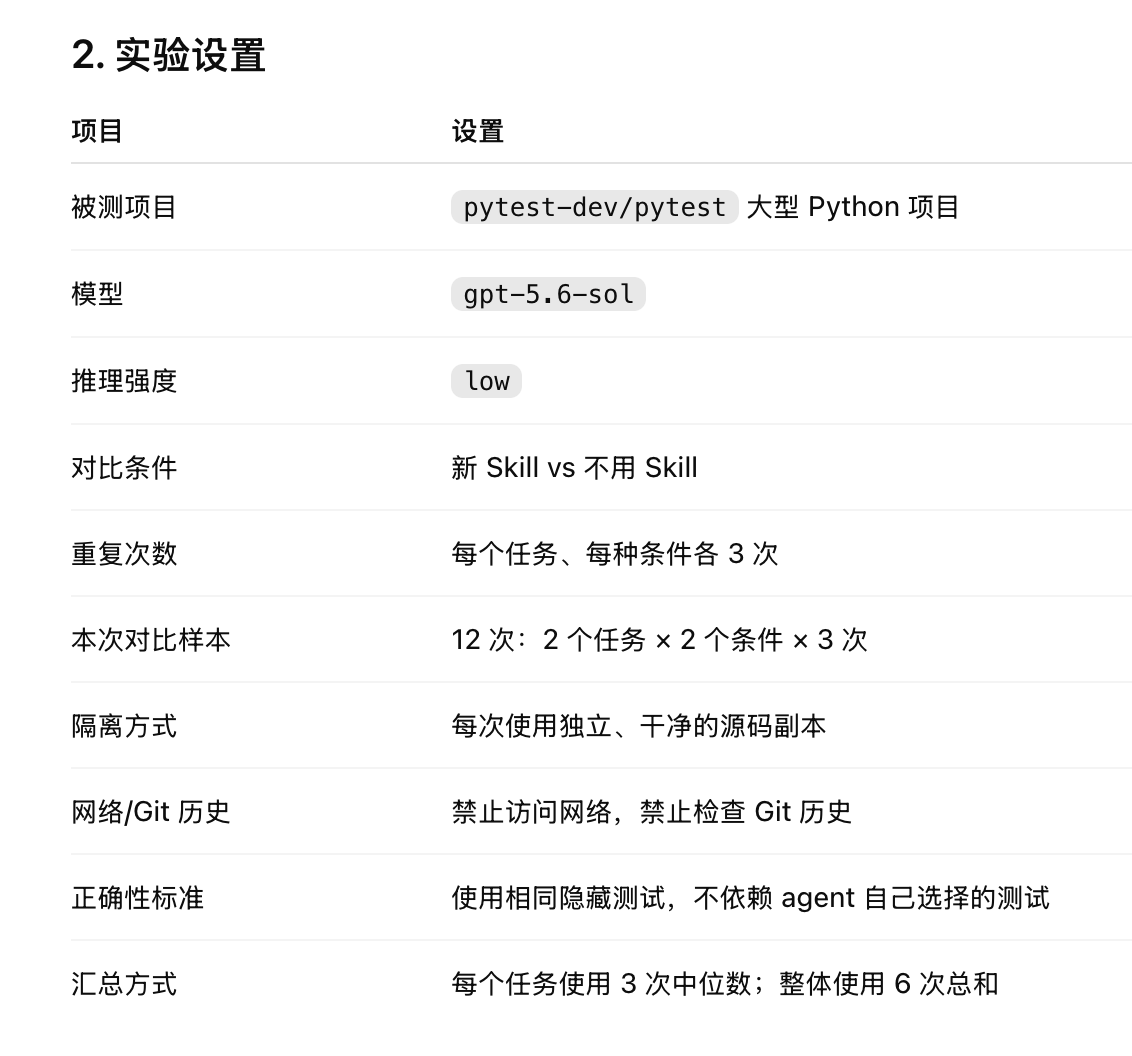
补充一下这个 benchmark 任务的定义:
具体任务有 2 个:
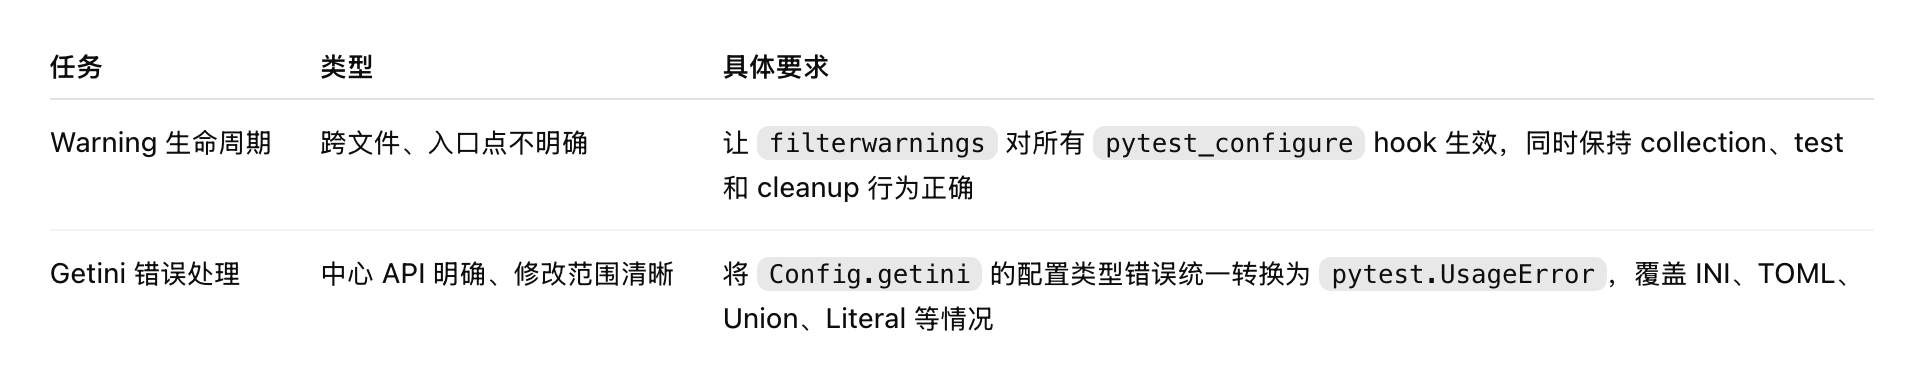
概括来说,就是基于一个测试专用的大型 Python 项目,设定两个方向的任务,一个任务横跨多个目录和文件,另一个任务目标明确、不需要跨文件定义,然后分别用 skill 和不用 skill 执行。
结果如你所见,使用了 skill 之后,速度略微有提高,token 消耗量则直接减少 30%!
说明一下,刚才提到的 skill,是指基于 PySonar2 源码封装的、符合 AI Skills 规范的 skill,你可以直接告诉 ChatGPT:
帮我安装这个 skill 到用户级目录:https://github.com/smallyunet/pysonar2
就可以了。
这个 PySonar2 的仓库是 fork 出来的,因为原版的 PySonar2 仓库是王垠 13 年前的项目,已经有一些工程和特性方面的 “过时”,所以做了一点点新的工程方面的包装。当然 PySonar2 最核心的词法分析、类型推断是没有过时的。
除了这个 AI skill,我还把 PySonar2 以 VS Code 插件的形式发布了,安装后可以在 VS Code 上打开 Python 代码之后,鼠标 hover 上去看到 PySonar2 的类型推断:
解释一下为什么 PySonar2 可以帮助 AI 节省。
如果你是程序员并且经常让 AI 写代码,一定会看到 AI 会使用大量的 rg,每一次任务都会把各种代码文件看一遍,然后继续执行代码修改。而 PySonar2 可以提供一种基于代码语义的、基于 AST 结构分析出来的这种内容:
{ "symbol": "User", "definitions": [ {"file": "models.py", "startLine": 12} ], "references": [ {"file": "service.py", "startLine": 48}, {"file": "tests/test_service.py", "startLine": 31} ], "affectedFiles": [ "models.py", "service.py", "tests/test_service.py" ]}直接在一个文件里把每个变量定义的来龙去脉、相关源码文件总结出来。相当于本地建立了一个索引,AI 直接看索引,而不需要每次看一遍全部代码。
因为任何 AI 工具目前都有两方面限制:
那么 PySonar2 现在是否还具有某些独特的价值呢?答案是有:
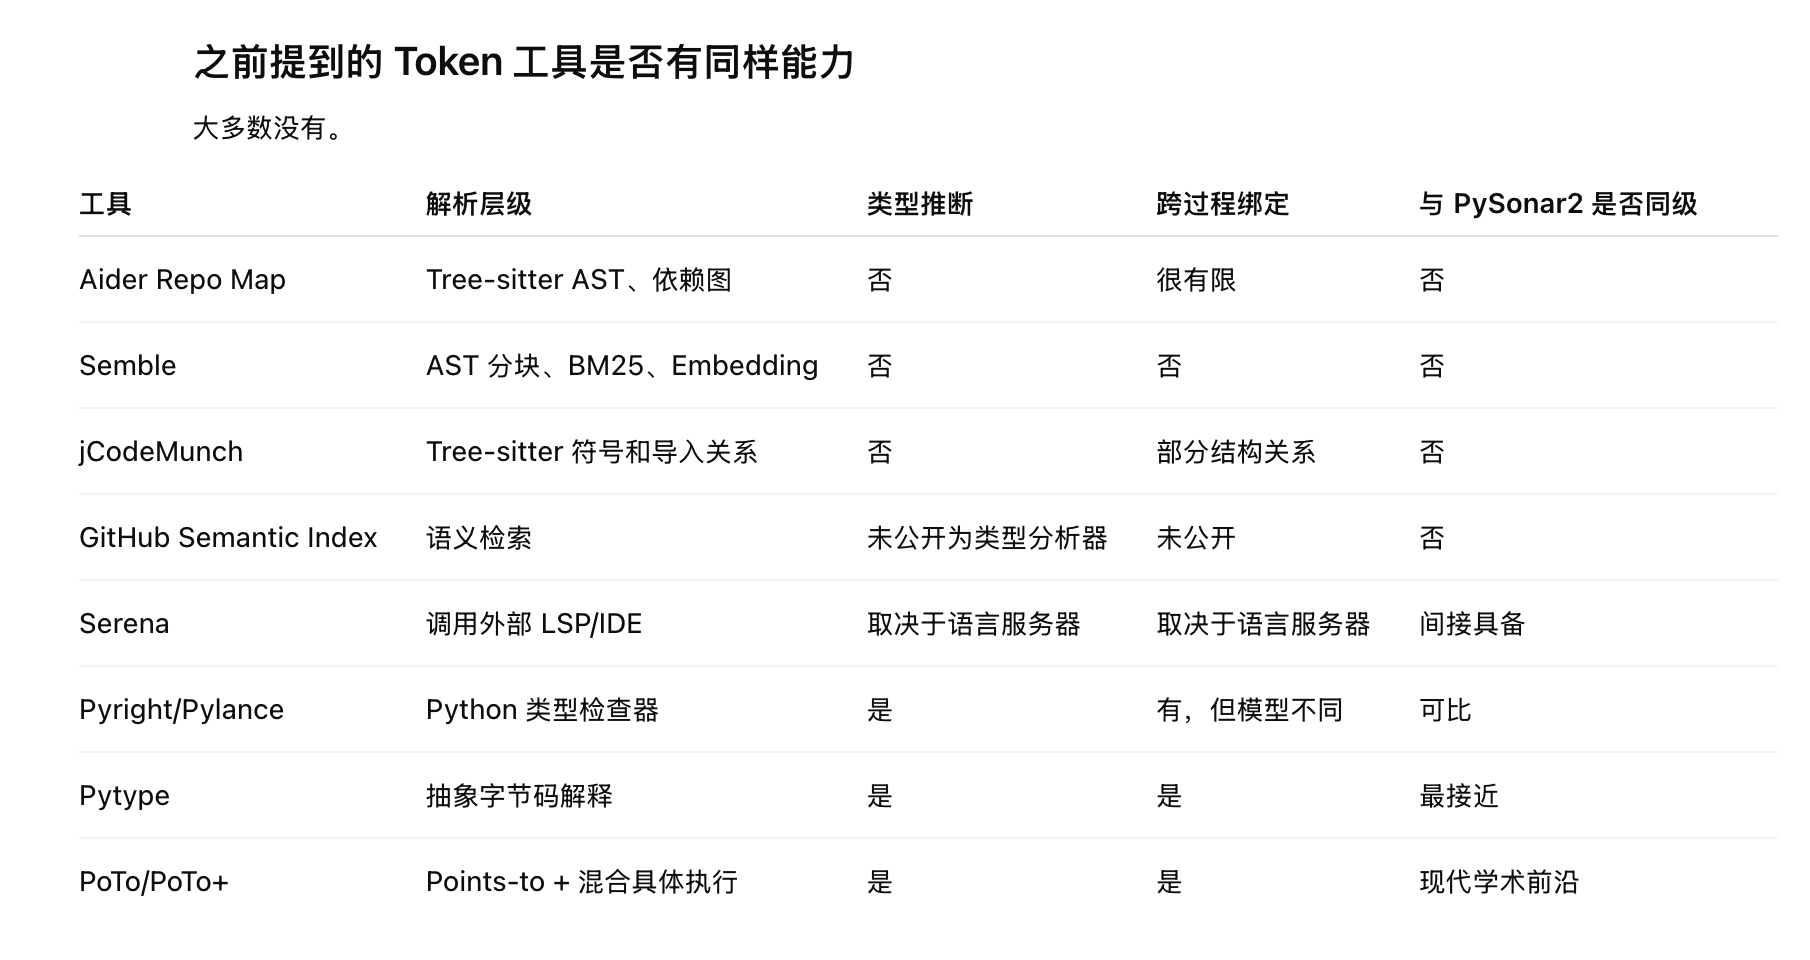
很多同类型的、号称节省 Token 的项目,都是基于关键词匹配、甚至 embedding 的匹配,与 PySonar2 的语义分析不在一个层面。
不过毕竟已经过去了 13 年,PySonar2 已经 13 年没有在学术理论上继续更新,要说 PySonar2 仍然处于世界前沿是不可能的。但是 PySonar2 因为开源、代码轻量、逻辑清晰,在 Agent 适配方面也许会有独特的优势和潜力:
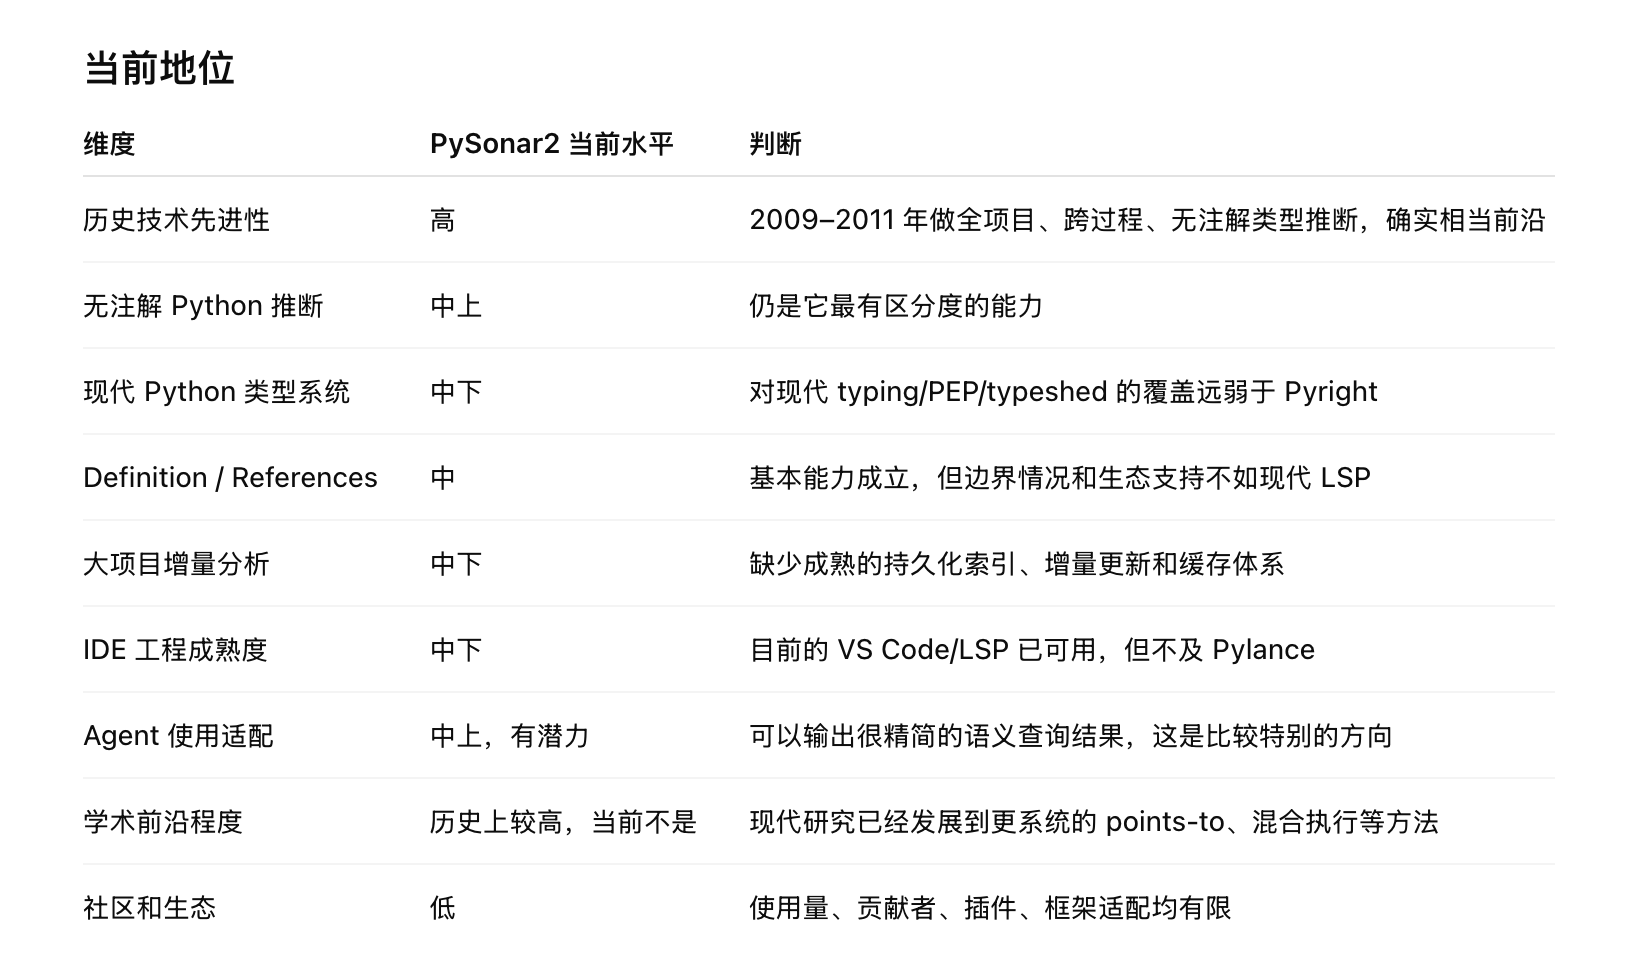
既然针对 Python 项目,PySonar2 可以帮助 AI 节省大量的 Token 消耗,那么其他语言的项目呢?JavaScript 是否可以借鉴同样的思路?以及更多脚本语言?同样的思路,已经不局限于 PySonar2 这个工具了。
比起让 PySonar2 这个古老的项目重新发挥价值,我更在意的事情是:在 AI 时代,还有哪些代码工具是有价值的?
因为人已经不需要写代码了,甚至不需要看代码了。但是 PySonar2 在这个场景下发挥了巨大的作用,让我看到了不一样的希望:
(与此同时,我还在优化另外一个项目:EchoEVM。基于 EchoEVM 的 EVM 解释器底座,让 AI 能够在编写 Solidity 脚本的时候、有能力看到脚本文件字节码级别的执行过程。这种 debug 工具对人类没什么用,但是对于 AI 极其有用,因为人类看不懂字节码、AI 可以)
PySonar2 作为拥有学术级别原理的工具,在人类已经不需要写代码的今天,仍然能够发挥价值、让 AI 节省 Token、给使用者省钱,这是真正意义上的效率工具。
如果你不了解 PySonar2 的背景,分享几篇相关文章可以看一下:
要补充说明的是,原文中对于节省 40% 的 Token 消耗,仅限于某些特定的、大量跨文件、变量名重叠、语义不清晰的任务。经过后来更丰富的测试,最新的 benchmark 结果 显示,很多通用任务中,如果强制使用 Pysonar2,消耗的 Token 和时长反而是增加的。不过由于 PySonar2 提供的精准语义分析能力,在 benchmark 中使用了 PySonar2 的准确率能达到 100%,给 AI 提供语义级别的事实证据是 Pysonar2 目前对于 AI 最明确的增强。
至于 “先给代码建立语义索引、修改代码直接使用索引” 的方式是否能够提交效率、节省 Token,我后来创建了单独的项目 code-engram 来进一步测试。目前 code-engram 主要支持 TypeScript 以及适配了 Pysonar2,唯一正向的 benchmark 数据是,在大型项目的 rename 任务中,Token 消耗节省 60%。但是对于小型项目或者其他通用任务,Token 消耗反而是增加的。这一点和 Pysonar2 单个仓库的结果类似。所以 code-engram 这个项目也仍然在继续探索中……
2026-07-28 00:50:05
在 bitcointalk 上看到一个帖子:How to handle weak scripts?
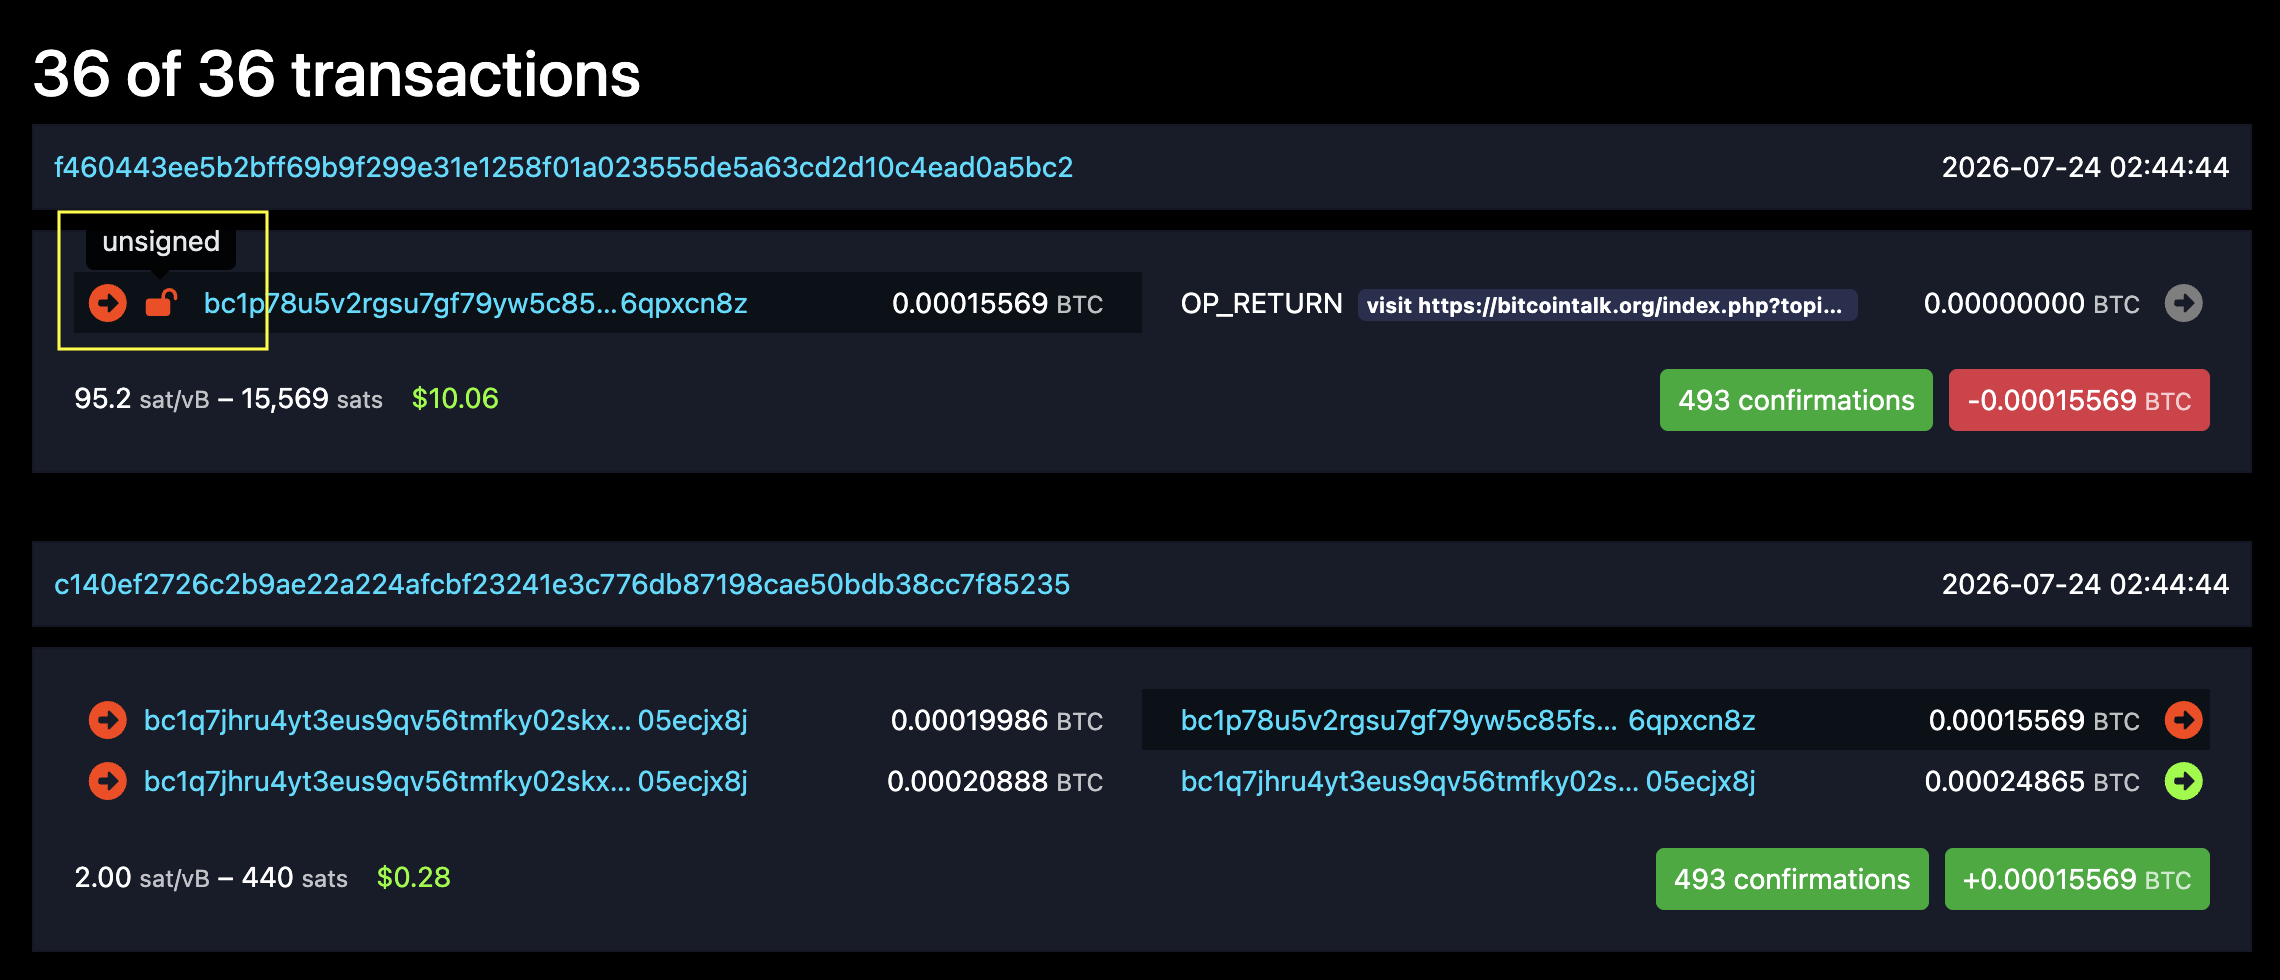
这个帖子说明了一种 Taproot 脚本的漏洞,无需经过签名验证,任何人都可以花费在这个 UTXO 上的余额。在 mempool 浏览器的界面上可以清晰看到,这笔 f460...5bc2 交易转出的一方有一个 unsigned 的标识,这个标识在比特币网络上并不多见:
帖子中描述的 Taproot 脚本的逻辑是这样,这也是 f460...5bc2 交易真实执行的脚本过程:
OP_PUSHBYTES_32 fa9b5ec193f735c41b804fc6ace1d28e81a299fc815c0f5009dd2dd7d0293c3bOP_CHECKSIGOP_IFOP_PUSHBYTES_32 ff1275b635cd160914cfe1bc516f521abde0fc8ae3fd92ae01ca16449e4758e9OP_ENDIF可以简化为:
<pubkey A>OP_CHECKSIGOP_IF <pubkey B>OP_ENDIF比特币的 Taproot 是基于栈结构的脚本,理解起来需要绕弯,把这个脚本翻译为 JavaScript 代码的话,大概是这个意思:
function isTrue(...params){ var pubkeyA = params[-1]; params--; if (checkSign(pubkeyA)) { return true; } else { // } return params[-1];}从代码来看,在正常使用流程下,假如输入的参数是 [pubkeyA],那么 checkSign(pubkeyA) 为 true,最终 return true,这个是合理的。
假如输入的参数是 [pubkeyC],那么 checkSign(pubkeyA) 为 false,下面的 else 分支什么都不做,最终 return null,依然不是 true,这个也合理。
这个脚本的漏洞在哪里呢,在于 params 是一个数组,用户未必只输入一个参数。
在漏洞逻辑下,可以输入非预期的参数组合 [true, pubkeyC],那么按照后面的执行流程,当进入 else 分支什么都不做之后,return params[0] 会把 true 给返回出来。
这里面存在几个基础的问题:
所以很简单,这个所谓的脚本漏洞,实际上是作者自己写了不严谨的代码导致的。要注意这里指的不是比特币的作者,仅仅只是比特币的用户。比特币的 Taproot 相当于以太坊的智能合约,任何人都可以写一些脚本规则,来决定钱怎么控制、怎么花。只不过比特币的脚本写起来复杂,而且不是图灵完备,所以很多人忽略了比特币可以自己写脚本这件事情。
很明显这不是一个比特币协议级别的漏洞,比特币的共识只负责按照脚本规则正确执行,而脚本逻辑是否有漏洞,跟协议无关。
而且事实上无论是比特币钱包还是比特币生态的项目,如果依赖于 Taproot 的脚本逻辑,一定会经过审计公司来审核代码,这种低级错误出现在主网上的情况恐怕会非常少。
另外 Taproot 这种脚本设计的隐私性其实很强,我们只能知道比特币地址 bc1p 开头是 Taproot 脚本,0xc0 开头的是当前版本号,但是一个 UTXO 在没有被花费之前,网络上是无法看到脚本具体内容的。而在被花费的那一刻,大概率全部的钱都已经被转走了。一个 P2TR UTXO 被创建的时候,链上只保存这棵树结构的根节点哈希,任何可以解锁 root 的路径都是有效输入,这些有效输入只有在花费的时候,链上才需要根据具体的 leaf 和 key path 去验证。而且即使某一个 leaf 被公开,链上也只能看到其中一个,看不到同一个 root 下的其他 leaf。
比特币从设计之初,就提倡每一笔转账都使用一个新的地址,实际上大多数靠谱的钱包也是这么设计的,这本身就很大程度规避了漏洞脚本被再次利用的风险。
所以无论是从技术上和商业逻辑上,这种漏洞脚本的出现都是极其小概率的个例,完全就是脚本作者自己写错了。主网上存在漏洞脚本的可能性很小。
有没有可能网路上真的存在这种漏洞脚本,不需要验证签名就可以把钱转走的?
先从 bc1p...cn8z 这个例子入手,有几个问题:
这显然不是钱包 App 提供的功能,而且比特币的交易比较麻烦,得把 UTXO 来源的交易和编号都作为参数才能构造出交易。这是一个示例脚本 taproot-script-path-demo.mjs,可以这样来运行:
TXID='0618d93bc4eef77f4b47c4b4b188011f95c7ccb929e6226df2774b88b5d4693d'VOUT='0'INPUT_SATS='15000'DESTINATION='bc1px6jn77jd4tplp94q46svkuutc53wtn24dk34wxp4dfur6tvez89swvlcmj'FEE_SATS='1000'node outputs/taproot-script-path-demo.mjs \ "$TXID" \ "$VOUT" \ "$INPUT_SATS" \ "$DESTINATION" \ "$FEE_SATS"如果你不小心把钱打到了地址 bc1p...cn8z 上,就可以用这个脚本,在没有私钥的情况下,把钱转出来。但是要小心脚本里的 xOnlyKey 和 payload 都是硬编码,如果换一个目标地址,这两个值就不一样了,得用另外的值。那么这个值应该是什么呢?这个值只有在 P2TR 被花费过之后才能知道。
这也就意味着,即使我们知道链上某一个地址有余额、脚本有漏洞,因为不知道整个树结构、拿不到 xOnlyKey 和 payload 的值,我们也无法动这个地址上的钱。从这个角度看,比特币上的资产安全程度还是很高的。
同样有一个示例脚本来干这个事情:audit-taproot-neighborhood.mjs,结果就是,没有。这个作者把全部关联地址的钱都转走了,不存在这种低级漏洞。
这个程序可以扫描整个比特币网络上类似的脚本漏洞:tapscript_weak_finder
扫描逻辑是这样:
0xc0
[01, <empty signatrue>] 的排列组合,处理 0 个参数、1 个参数、2 个参数的情况,一共 12 种01, <empty signatrue>,扩展到小整数和一些常量,比如 02, 03, true, false 等[[data, sigA, sigB]],尝试变换组合,比如 [data, "", sigB]、[data, sigA, ""] 等OP_SUCCESS80的脚本,或者目前规范还没有定义的公钥类型,会记录到数据库当然我会告诉你运行结果。如果你运行了这个开源程序,会得到和我一样的结果和结论。我的启动参数是从区块高度 709632 开始,这是比特币主网启用 Taproot 的高度,到 959701 高度结束,也就是最新的区块高度。
一共扫描了 71037 个区块,扫描了 127119410 笔交易,扫描到 1000061 个 Taproot 地址,其中 427378 个属于当前程序没识别出问题的脚本,12 是有可能有漏洞的弱脚本。
在 12 个有可能有漏洞的脚本中,8 个属于不需要签名的弱脚本,1 个属于始终返回 OP_SUCCESS80 的非漏洞脚本,3 个属于包含扫描程序解释器不支持操作码的非漏洞脚本。
来逐个分析一下扫描到的有可能是 weak script 的交易。最终输出的、未经加工的结果数据在这个文件:result_report.json,可以还原出我下面提到的地址和交易、脚本。
首先扫描到的这个 taproot 地址出现在 758737 区块:bc1p...2354
这个地址出现了 2 笔异常交易:
先说结论,这 2 笔交易是非常专业的开发者在演示比特币主网的 BIP342 规范而发起的。
第一笔交易 00c1...c40e 包含 2 个 witness 参数,是用来测试交易的。
第二笔交易 73be...2a7e 就离谱了,包含 500001 个 witness 参数,OP_RETURN 的内容解码后得到 “you’ll run cln. and you’ll be happy.” 的文本。
TapScript 的规定是,初始栈最多只能有 1000 个元素,但是第二笔交易出现了 500001 个元素而且交易成功了,是因为 BIP342 规范定义,如果脚本中出现 OP_SUCCESSx,则无论脚本包含多少元素,一律视作成功。因为 OP_SUCCESSx 属于目前还未明确支持、但是预留给未来有可能使用的操作码,所以 BIP342 这样来规定了。
很明显第二笔交易就是用来演示这种状况的。也因为这笔交易包含大量参数,花费了超过 700 美元的手续费。
其次扫描到的地址出现在 771740 区块;
这 3 个脚本对应的交易包含了 OP_CHECKSEQUENCEVERIFY 操作码,扫描程序没有处理这个操作码,所以认为是异常给挑出来了。OP_CHECKSEQUENCEVERIFY 操作码的含义是,必须等待多少个区块,才可以使用地址里的资金。属于是典型的 TimeLock 脚本。
在区块高度 775722,扫描到了这个地址:bc1p...amq6
这是一个真正有逻辑漏洞的脚本,不需要任何签名就可以转移资金。这个脚本明显是一个 Ordinals 数据结构的封装,可能是某个开发者在尝试自己开发类似 Ordinals 的协议。当然这个地址上的钱当时就被全部转走了,现在没有余额。
另外还有几个地址,数量不多,大多数是 Ordinals 的测试交易,就不一一详细解释了:
bc1p...3hu0,区块高度 777335,一个 Ordinals PNG 图片bc1p...xgdr,区块高度 777617,一个加法运算,没有校验签名bc1p...gq7d,区块高度 777681,一个测试脚本,固定返回 truebc1p...9x3t,一个 Ordinals 的 Hello World 脚本已经扫描了从 Taproot 脚本功能上线到至今为止全部的区块和交易,真的出现了少量 How to handle weak scripts? 中描述的类似的脚本漏洞,不过那些地址上都已经没有余额了。
这件事情另外的启发:
2026-07-10 19:53:28
现在做 Crypto 方向的项目,一般会选择 Privy.io 或 Turnkey 来作为钱包的基础设施提供商。这些钱包设施提供了注册登录方面的集成,可以用传统方式邮箱、Google 登录,也可以用 web3 一点的方式,比如 MetaMask 钱包或者 OKX 钱包登录。更重要的是这些钱包设施解决了钱包安全的问题,允许给用户创建 embedded wallet,如果不使用这些钱包服务,项目方需要自己在服务器上保存用户的私钥,这是很危险的,尤其是对于中小团队来说,安全问题是很沉重的负担。Privy 或者 Turnkey 的解决方案是,私钥由他们来保管,储存在 TEE 一类的加密硬件中,项目方只需要通过 API 来访问和使用钱包。
至于 Privy 还是 Turnkey 的取舍问题,比如我们经常在看的 Kreo、PolyCop、polymtrade 等项目都在用 Privy。这些项目列表都在 Polymarket Builder 榜单 上。Polymarket 的这个 Builder 榜单上,列出了每一个 Polymarket 生态的项目方交易量排名。GMGN 也用的 Privy。
用 Turnkey 的项目也有,比如 Axiom、alchemy 等。我们当时用了 Turnkey。一开始是因为 Turnkey 从定位上对自动化运行的 Trading Bot 更加友善,Privy 定位上有很重的对前端界面 SDK 的依赖。后来又发现了一个 Privy 和 Turnkey 比较大的区别:是否支持 Telegram 注册登录。
Privy 支持 TG 登录,Turnkey 不支持,为什么呢?
因为 TG 没有像 Google 那样成熟的 OAuth 体系,TG 账号本身无法像 email 或者 wallet 一样给 Privy/Turnkey 一个 identity provider。Privy 针对这种场景做了简化,你用 TG 登录,登录后 Privy 代替你去通过 API 请求钱包的操作,实际上此时 Privy 后端 “就是你”,假如 Privy 后端的服务器被黑了,你的钱包权限会完全暴露在黑客手里。而 Turnkey 比较生硬,无法提供 identity provider,就不能让你操作钱包,Turnkey 的后端不愿意代替用户承担这种权限风险。
所以这是我们发现的 Privy 和 Turnkey 之间比较大的场景支持程度上的差异。如果想要用 Turnkey 并且支持 TG 登录,就得专门做一个 TG Miniapp,登录的时候唤起 Miniapp 来完成。
Polymarket 上的订单系统叫 CLOB,下单等行为都是在和 CLOB API 交互。4月28日,Polymarket 正式启用 CLOB V2。对于我们这种下游项目来说,最大的变动是需要换掉一些合约地址信息,比如 Copy Trading 功能需要扫描链上交易,以前监听的是 V1 版本的合约,迁移后监听的是 V2 版本的合约。此外如果下游不适配也是可以的,因为大体上兼容旧版本的订单参数。
而 CLOB V2 也引入了 FAK、FOK 等 Market Order 在使用的参数,这些参数直到一个多月以后我才发现它们的差异。因为在 V1 版本订单如果没有立即成交,会把没成交的部分自动挂单为 Limit Order,但同时又要求 Limit Order 的 shares 数量必须大于 5。所以用户有时会遇到一个奇怪的错误,为什么订单 shares 数量必须最小是 5?又为什么有时候会提醒最小订单金额是 1 美元?为什么有时候能成功有时候失败了,最小金额不是固定的?用上 FAK 参数的话倒是没有这种旧的问题了。
5月4日,Polymarket 发公告说启用新的 Deposit Wallet,不再使用旧版本的 Safe wallet。这是一个 breaking change,所有旧的用户依然兼容,但是新的尤其是通过 api 操作的钱包,都将使用新的 Deposit Wallet,也就是说下游项目必须兼容。
这个时间点非常微妙,因为我们原本计划项目 Beta 版本上线的日期是 5月5日。也因此当时连续两三天我紧赶慢赶去适配这个 Deposit Wallet 的迁移。这本身不是一件特别难的事情,但是由于突然升级带来的措手不及,以及上线的 delay,还是有一点点压力。
至于集成过程中遇到的唯一挫折,是 Polymarket 的 Migration 文档里没有写新的 Deposit Wallet Implementation 地址。在用 Factory 合约创建钱包的时候,需要一个 implement 合约作为参数,不同的 implement 合约出来的钱包地址是完全不一样的。而重点不只是我们用哪个地址,而是 Polymarket 的 Relayer api 用哪个,因为在新的这种 Deposit Wallet 模式下,所有的钱包操作都会通过官方的 Relayer api 了。以前用的 Safe wallet,其实我们可以自己直接去链上调合约的。Polymarket 的这个改动,反而让钱包体系更加不那么去中心化。至于正确的 implement 的值,则是需要直接从 Polymarket 发布的 SDK 里去读。而且当时还遇到个小坑就是 Polymarket 发布的不同 SDK 之间用的 implement 地址还不一样。不是同一个 SDK 不同版本,而是那种不同 SDK,比如 client-sdk, server-sdk 这种。当时 Discord 群里遇到这个集成问题的开发者非常多。
刚才提到新的 Deposit Wallet 必须要通过 Polymarket 官方的 Relayer API。我们在迁移后并且项目上线一段时间、做活动,紧接着就遇到了另一个坑:Unverified 状态的 Builder API 只有每天 100次的请求额度。
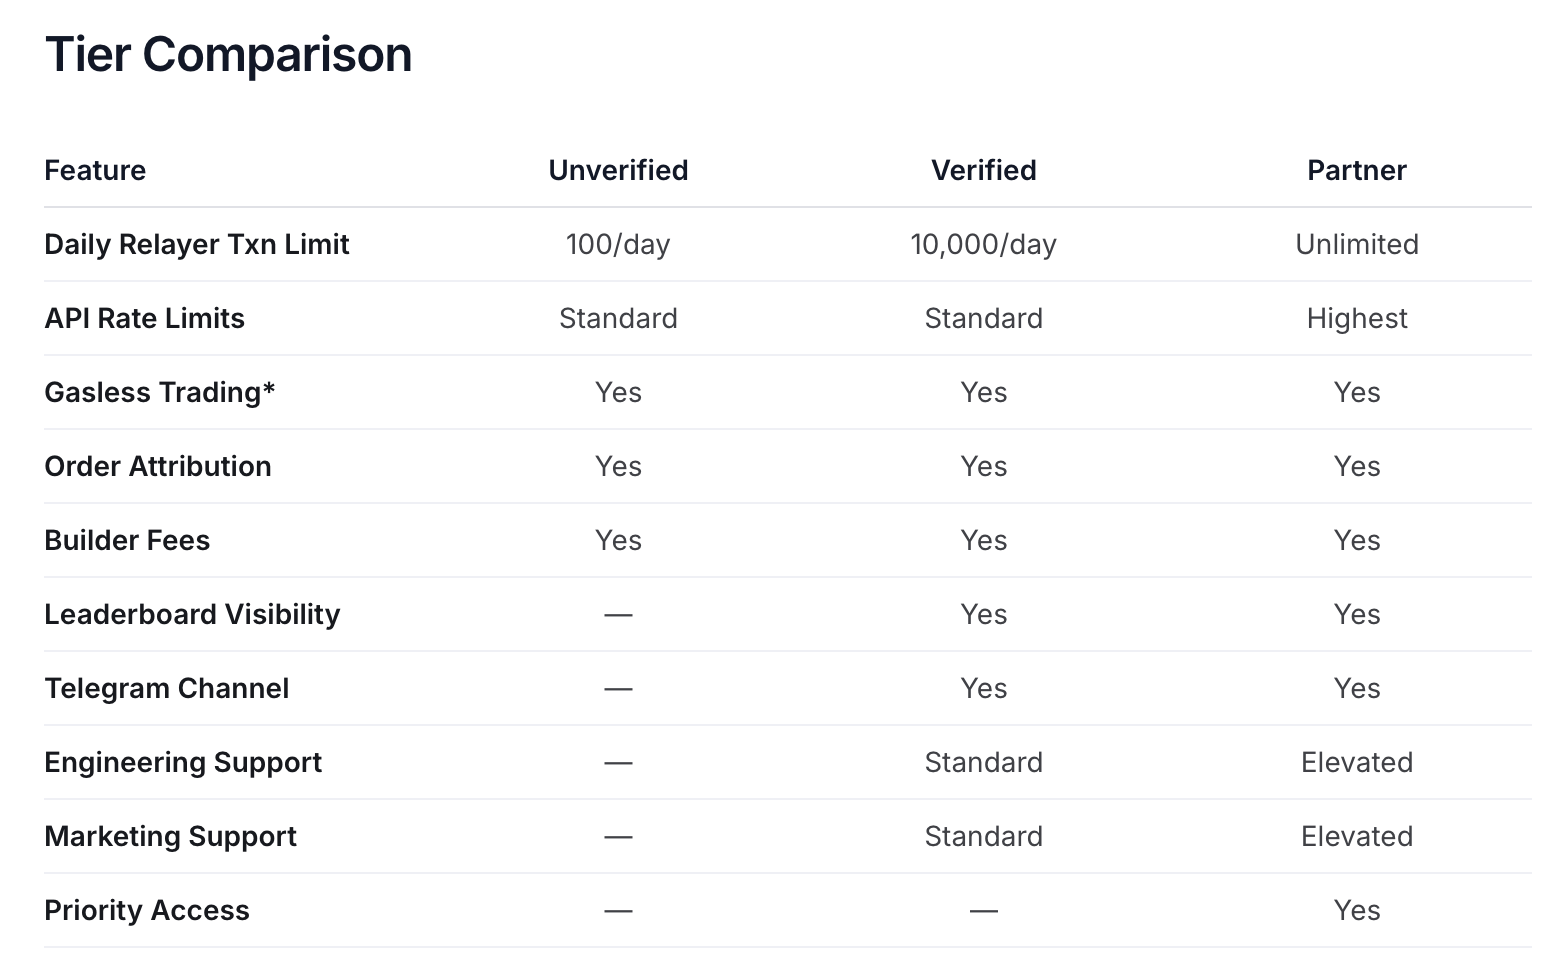
看出 Polymarket 的阴险之处了吧,先是要求所有新用户都用 Deposit Wallet,而新的 Deposit Wallet 自然必须通过 Relayer API 来操作钱包,再然后你会发现,Relayer API 的请求是有额度限制的!如果是原本的 Safe wallet 可以直接链上操作绕过 Polymarket 的 API 额度限制。现在不行了。
这个 Relayer API,每次创建新的钱包都要用、每一次从钱包里 withdraw 钱要用,所以这是一个高频率会用到的接口。
针对这个限制的缓兵之计是,Polymarket 默认用 Builder API 来对 Relayer API 授权,但是 Relayer API 却没有要求 Builder API 具体是哪一个。所以我注册了 10个账号、每一个账号都创建了 builder api,配置到服务器里,用来暂时缓解 relayer api 的额度限制问题。每个账号每天100次请求额度,也就意味着 10 个账号一天有 1000 次额度。因为 verified 从提交到审核需要两到四周的时间,是一个很长的周期。
当然最终还是通过了 Verified,现在我们的项目已经出现在 Polymarket Builder 榜单上,并且状态是 Verified。
7月6日,又是 Deposit Wallet 的问题。我们发现了一个很严重的 bug,自从 7月1日以来注册的全部用户,创建钱包都失败了!而因为用户反馈少,出问题很多天我们才发现这个问题。也就是说,新注册的用户,注册完之后如果充值,会把钱充值到错误的地址上。
为什么会出现这个 bug 呢,因为 7月1日,Polymarket 直接修改了创建钱包的逻辑,用上了 beacon 的方式去创建代理钱包,而且连公告都没发,直接改变 API 接口的行为。这种改动,是需要下游项目方主动适配的。
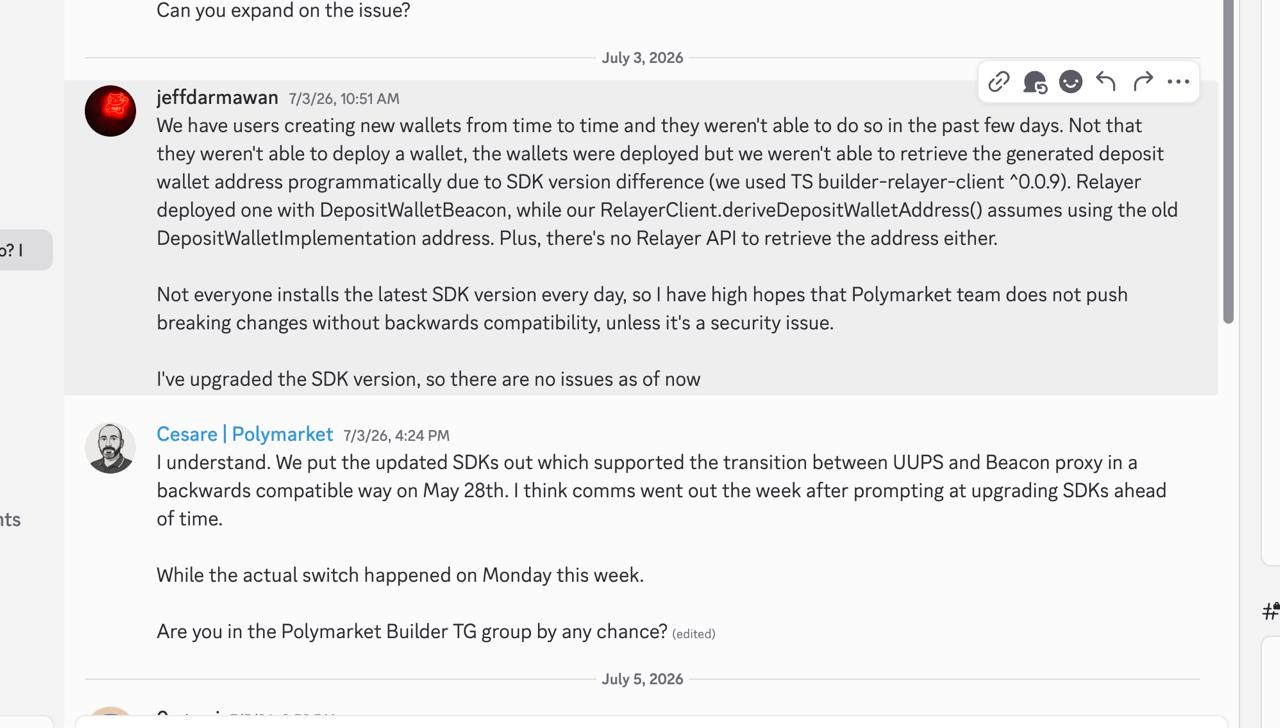
我们也有错误,我们的错误之处就在于没能及时发现这种异常,并且在程序前后端加上足够的保护性、防御措施。针对这次事故所有用户充值钱到错误地址的,全部金额都赔了,好在金额不大。
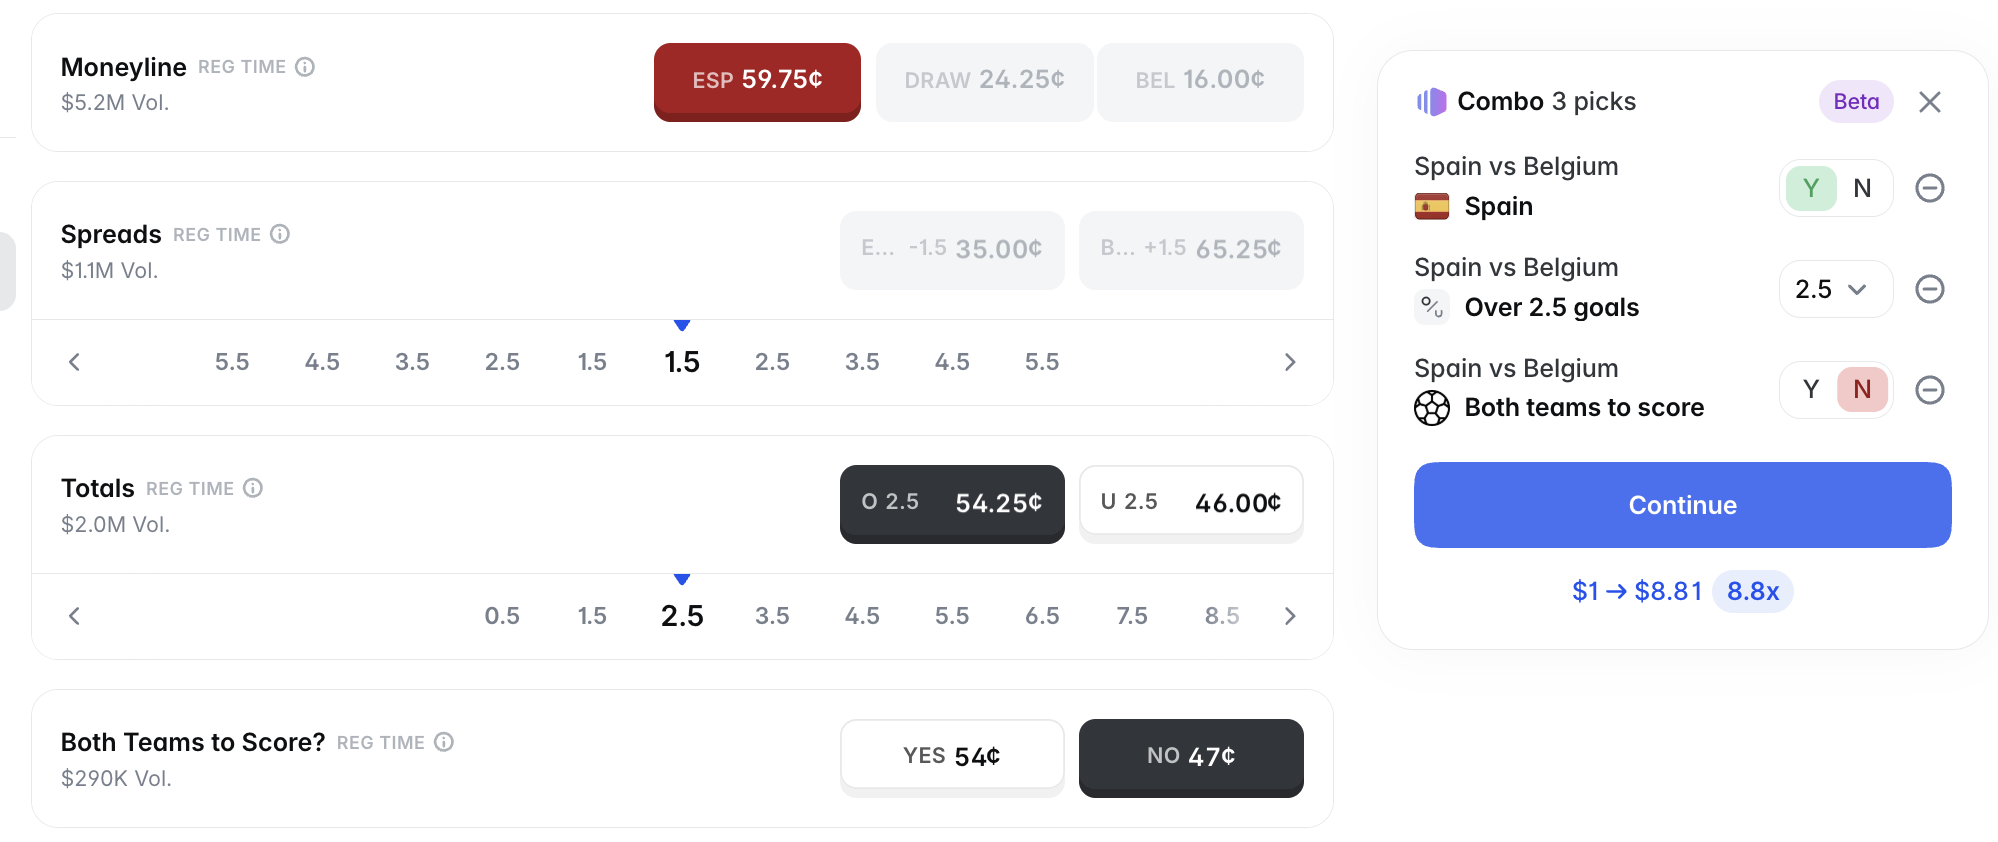
Polymarket 针对世界杯的市场,新出了一个叫 combos 的功能。我们就开始评估是否可以接入这个 combos 的功能。结果就是,从 combos 文档 上看,API 只提供了针对做市商提交 quote 的接口,没有提供作为普通用户作为 taker 角色去下单的接口。
Polymarket 从 6月4日开始运作 combos 的接口,看起来也是在辛苦 build 中。
7月10日,用户反馈遇到了订单交易失败的问题。经过排查后发现是订单的 tick size 有了变化,所有的世界杯市场都支持 0.0025 (0.25¢) 级别精度的 tick size。在此之前 tick size 只有固定 4 种,这个 0.25¢ 属于第 5 种(枚举类型)。
同样的,这个变动其实 Polymarket 早在 7月2日就上线了,但是我们直到 7月10日才发现 bug。
所以你看到了,一直以来,我们都在不断的追随 Polymarket 的脚步,一直不断的响应 Polymarket 的功能更新和变化。
也因此,在构建项目的过程中,我们也开始逐渐意识到这样的项目误区:再做一个官网。
如果定位是 “再做一个官网”,项目方就会陷入非常被动的处境。而且 Polymarket 家大业大,官网 UI 做的也好,有功能都是第一时间上官网,再者官网自家的服务器,下单速度也快。我们的订单速度再快也不可能快过 Polymarket 官网。
这是一件尴尬的事情,如果想要做的比官网使用体验好,客观上难度是很高的。Polymarket 不是 memecoins,一般 memecoins 没有官网至少不会有官方钱包、官方 DEX,但是 Polymarket 有官网、有官方解决方案。Polymarket Builder 的定位,从来都不是说,Polymarket 是一个开放的去中心化协议,大家都来建设项目去玩。
与之相反,Polymarket 最近的功能更新上也越来越往中心化的方向走,定位更像是中心化交易所,比如 Binance 这种,Polymarket API,就是 Binance API。做 Polymarket 生态的项目,就有点像是做 Binance 的 Trading Bot 一类事情。


